Resumo:
DeepSeek também se juntou à competição de parâmetros. De acordo com o The Information, o DeepSeek está atualmente treinando um novo modelo com aproximadamente 2 trilhões de parâmetros; Liang Wenfeng também afirmou numa recente reunião de investidores que o próximo passo da empresa é continuar a levar o modelo para 8 biliões de parâmetros. Há um ano, 8 biliões ainda era um número inimaginável.
Mas agora, o Kimi K3 atingiu 2,8 trilhões de parâmetros; Byte está pré-treinando um novo modelo que pode atingir até 10 trilhões de parâmetros; O Alibaba também declarou publicamente que o modelo da próxima geração avançará para 5 trilhões a 10 trilhões de parâmetros. A Anthropic não divulga os parâmetros do modelo, mas o FT já citou estimativas da indústria dizendo que seu mais recente carro-chefe, o Mythos 5, tem aproximadamente 8 trilhões de parâmetros.
A grande modelo andou em círculos e começou a competir novamente para ver quem era maior.
Só que desta vez, os parâmetros que todos implementam não são mais os mesmos da rodada anterior de escalonamento.
Quando o DeepSeek lançou o V4-Pro em abril deste ano, a escala divulgada oficialmente era de 1,6 trilhão de parâmetros totais e 49 bilhões de parâmetros de ativação.
O plano de acompanhamento é de 8 trilhões de RMB, o que equivale a 5 vezes o do V4-Pro.
Isso é bastante incomum quando se trata do DeepSeek. Afinal, DeepSeek deixou a impressão mais profunda em toda a indústria de IA no ano passado, não em termos de parâmetros.
Certa vez, isso fez com que a indústria de IA voltasse a discutir que talvez os modelos de ponta não precisem queimar GPU infinitamente.
Quando a V3 for lançada no final de 2024, o DeepSeek deliberadamente coloca a conta de treinamento na mesa: 671 bilhões de parâmetros totais, 37 bilhões de parâmetros ativados por token e o treinamento completo consome 2,788 milhões de horas de GPU H800. Calculado em US$ 2 por hora de GPU, o custo oficial de treinamento é de apenas US$ 5,576 milhões.
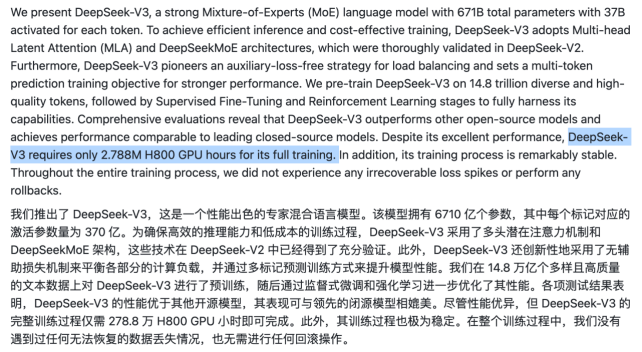
Esse número e a eficiência por trás dele se tornaram um dos rótulos mais importantes para o DeepSeek posteriormente.
O DeepSeek não possui um suprimento abundante de GPUs avançadas como OpenAI e Anthropic; a empresa há muito confia no Huanfang de Liang Wenfeng para quantificar a sua autotransfusão e não aceita financiamento externo. Suas condições determinam sua rota - como o dinheiro e o poder computacional são limitados, o desempenho deve ser maximizado a partir da arquitetura, do treinamento e da eficiência de inferência.
Mas agora as condições mudaram.
A DeepSeek acaba de concluir sua primeira rodada de financiamento externo desde a sua criação em junho deste ano, arrecadando aproximadamente US$ 7,4 bilhões. Actualmente, a segunda ronda de financiamento de aproximadamente 50 mil milhões de RMB (aproximadamente 7,5 mil milhões de dólares) entrou na fase de finalização, correspondendo a uma avaliação de aproximadamente 500 mil milhões de RMB. Se este financiamento for concluído com sucesso, o financiamento externo acumulado da DeepSeek será próximo de 15 mil milhões de dólares americanos e aproximadamente 100 mil milhões de yuans dentro de alguns meses.
Ao mesmo tempo, a DeepSeek contratou a CITIC Securities para se preparar para o IPO do Conselho de Inovação Científica e Tecnológica, e o novo capital será claramente usado para infraestrutura de computação, desenvolvimento de modelos e investimento em talentos; em 21 de setembro, Yan Wentao, ex-sócio da Hillhouse Venture Partners, ingressou oficialmente na DeepSeek e atuou como CFO, encerrando a vaga de CFO nos três anos desde a fundação da empresa.
No passado, o DeepSeek usava dinheiro e poder computacional limitados para tornar o modelo o melhor possível; agora o financiamento e a listagem estão sendo impulsionados. Com mais dinheiro em mãos, o poder computacional também pode ser aumentado.
Depois que as condições são atendidas, o DeepSeek também começa a implementar parâmetros com ousadia.
Isso não entra em conflito com a busca pela eficiência. Quando a eficiência é alta, a escala pode ser ampliada com o mesmo dinheiro.
Nos últimos dois meses, a escala total de parâmetros dos modelos de ponta aumentou significativamente.
Trazendo esta competição de volta aos holofotes está The Dark Side of the Moon. Em julho deste ano, o Kimi K3 atingiu 2,8 trilhões de parâmetros totais e 104 bilhões de parâmetros de ativação. O K3 ainda é o modelo de peso aberto com a maior escala de parâmetros já lançado oficialmente.
Não é apenas grande. Na avaliação oficial, o GPQA Diamond do K3 atingiu 93,5, e o Terminal-Bench 2.1 atingiu 88,3, muito próximo do GPT-5.6 Sol e Claude Fable 5 no mesmo período. A escala atingiu trilhões e o desempenho atingiu o primeiro escalão.
Em agosto, foi revelado que a Byte estava planejando se tornar maior.
Em 6 de agosto, o "LatePost" divulgou pela primeira vez que a Byte estava discutindo o treinamento de um novo modelo com mais de 5 trilhões de parâmetros, liderado por Xiang Liang, chefe da Seed Foundation. Segundo relatos, a Byte parece acreditar internamente que, em vez de continuar a acompanhar o tamanho existente, é melhor aumentar a escala de parâmetros várias vezes mais do que a de seus pares de uma só vez.
Um dia depois, em 7 de agosto, o FT informou, citando pessoas familiarizadas com o assunto, que a escala do novo modelo que está sendo pré-treinado pela Byte pode atingir até 10 trilhões de parâmetros; quando a Reuters fez o acompanhamento, também o comparou com o Mythos de última geração da Anthropic – embora este último nunca tenha divulgado a escala do parâmetro, as estimativas da indústria atingiram cerca de 8 trilhões. Se o novo modelo da Byte atingir 10T, ultrapassará a escala atualmente circulada pela Mythos.
Agora, quantidades de parâmetros extremamente grandes, de mais de 5T, começaram a aparecer repetidamente nas discussões sobre modelos de ponta.
Hoje, o CEO do Alibaba, Wu Yongming, anunciou publicamente que o modelo da próxima geração planeja atingir 5 trilhões a 10 trilhões de parâmetros; DeepSeek está treinando um modelo 2T enquanto define a meta de acompanhamento para 8T. Pode-se entender que o laboratório principal mais uma vez considerou uma escala total de parâmetros maior como um caminho importante para impactar o limite superior das capacidades.
Mesmo os modelos americanos de código fechado que não divulgam parâmetros não podem escapar do escrutínio externo. O Mythos da Antrópico é estimado em 8T por pessoas de fora; A OpenAI não divulga mais a escala do modelo desde a era GPT-4, mas há um boato na comunidade de que o Astra atingiu um MoE de 10T.
O número de parâmetros nunca perdeu o seu apelo, tal como o valor do poder de combate no painel do jogo - as pessoas sabem que não pode representar tudo, mas será sempre o número mais intuitivo e opressivo.
Na verdade, a grande indústria de modelos não gosta muito de falar sobre parâmetros há algum tempo.
Nos últimos dois anos, destilação, pequenos modelos, MoE, aprendizagem por reforço e cálculos de tempo de inferência se revezaram. Em vez de exibirem que possuem centenas de bilhões ou trilhões de parâmetros, os fabricantes de modelos estão mais dispostos a falar sobre desempenho, custo e eficiência. Simplesmente aumentar o modelo fará com que pareça que você tem dinheiro, mas não tem onde gastá-lo.
Hoje, as grandezas dos parâmetros foram elevadas novamente e tornaram-se mais uma vez a "frente" dos modelos de ponta.
No entanto, o 5T, 8T e 10T de hoje não são mais a mesma coisa que "mais parâmetros, maior o modelo" na rodada anterior de escalonamento.
A razão mais direta pela qual as quantidades dos parâmetros podem ser colocadas de volta na mesa é que a arquitetura principal dos modelos ultragrandes mudou.
No passado, a tendência principal dos grandes modelos era a arquitetura Densa, onde a escala dos parâmetros e a quantidade de cálculo estavam basicamente interligadas. Simplificando, significa quantos parâmetros existem no modelo e eles basicamente devem ser inseridos juntos em todos os cálculos. Quanto mais parâmetros houver, maior tende a ser o limite superior de capacidades, mas o custo de treinamento e inferência também aumenta.
Hoje em dia, cada vez mais modelos grandes usam MoE, Mistura de Especialistas e arquitetura especializada mista.
É mais como uma empresa com muitos especialistas. O modelo pode ter centenas ou milhares de especialistas, mas apenas uma pequena parte deles é selecionada para trabalhar em cada tarefa. Por exemplo, Kimi K3 tem parâmetros totais de 2,8T, mas cada token ativa apenas 104B, cerca de 3,7%; DeepSeek V4-Pro possui parâmetros totais de 1,6T e cada token ativa apenas 49B, cerca de 3%.
Portanto, hoje, se um modelo possui parâmetros 5T, 8T ou mesmo 10T, isso não significa que ele deva passar por esses parâmetros 10T toda vez que gerar um Token.
Quanto o modelo pode conter e quanto precisa ser calculado a cada vez tornaram-se dois números diferentes.
Parâmetros podem ser entendidos como o espaço utilizado pelo modelo para transportar conhecimentos, padrões e capacidades. Quanto maiores os parâmetros totais, mais espaço o modelo teoricamente tem para aprender distribuições cada vez mais complexas; O MoE permite ligar apenas para alguns deles quando necessário.
Como resultado, o modelo pode continuar a aumentar a capacidade total dos parâmetros sem tornar cada cálculo mais pesado ano após ano.
Ainda tomando o K3 como exemplo, ele tem um parâmetro total de 2,8T, que é cerca de três vezes a escala do K2.5, mas entre 896 especialistas, apenas 16 de cada Token são ativados. Dark Side of the Moon disse que, graças ao MoE mais esparso e a uma série de otimizações arquitetônicas, a eficiência geral de escala do K3 foi melhorada em cerca de 2,5 vezes em comparação com o K2.
A era do Agente acabou de empurrar essa "capacidade" de volta para o centro da competição.
No passado, a capacidade de um chatbot era frequentemente medida um por um. A matemática analisa a matemática, o código analisa o código e as perguntas e respostas analisam o conhecimento. Se o modelo atingir picos mais elevados em vários benchmarks importantes, será suficiente provar que é muito forte.
Mas o Agent agrupa esses recursos na mesma cadeia de tarefas. Uma tarefa realmente longa pode começar com a busca de informações, depois ler páginas da web, ver imagens, escrever código, ligar para o terminal e então encontrar erros, modificar o plano, chamar outras ferramentas e até mesmo atribuir subtarefas a outros agentes.
Quando a OpenAI lançou a API Agents em setembro deste ano, ela listou diretamente a execução de longo prazo, o gerenciamento de contexto, o uso de ferramentas e a coordenação de subagentes como a infraestrutura central do Agente, e enfatizou que o Agente precisa funcionar de forma confiável por horas ou até dias.
Em uma sessão de perguntas e respostas, se uma determinada habilidade falhar ocasionalmente, apenas uma pergunta poderá ser perdida; em uma tarefa de Agente envolvendo dezenas ou centenas de etapas, qualquer elo fraco pode interromper todo o enlace. Quanto mais longa for a tarefa, maiores serão os requisitos de cobertura de capacidade e estabilidade. Como resultado, a concorrência fronteiriça começou a ter um óbvio “efeito barril”.
O METR agora usa diretamente o "intervalo de tempo da tarefa" para medir as capacidades do Agente, porque quanto mais longa a tarefa, maior será o requisito para o modelo concluir continuamente uma série de operações diferentes.
Na era do Chatbot, é mais fácil ver o pico das capacidades, enquanto na era do Agente, a cobertura da capacidade é cada vez mais importante.
Neste momento, parâmetros maiores de capacidade têm um novo valor. Quanto mais longa a tarefa, menos tendencioso deve ser o modelo; quanto mais coisas o Agente puder fazer, mais amplas serão as capacidades que a base precisa cobrir.
O MoE abre espaço para a expansão contínua da capacidade e o Agent amplifica ainda mais o valor da capacidade. Portanto, os fabricantes de modelos estão fazendo o possível para melhorar a eficiência enquanto aumentam os parâmetros para 5T, 8T e 10T novamente.
O poder de computação economizado não fez com que o Scaling desaparecesse, mas, em vez disso, criou um novo espaço para o Scaling.
Comentários