
Resumo:
A equipe de pesquisa da Apple revela progresso na pesquisa sobre o “cérebro” do robô. No dia 4 de novembro, horário local, a equipe de pesquisa da Apple apresentou o artigo "Perceptive Humanoid Motion from Simulation" na plataforma de pré-impressão arXiv, divulgando o sistema de controle autônomo do robô humanóide HALO. A equipe de pesquisa implantou o sistema no robô humanóide G1 da Yushu Technology para verificação, permitindo que o robô realizasse as ações aprendidas no ambiente de simulação e as executasse em uma sala desconhecida da vida real.
A equipe de pesquisa também divulgou a geração de dados, treinamento de modelo e código de implantação, abrangendo geração de ações, rastreamento de ações, orquestração de tarefas, simulação e operação real do robô.
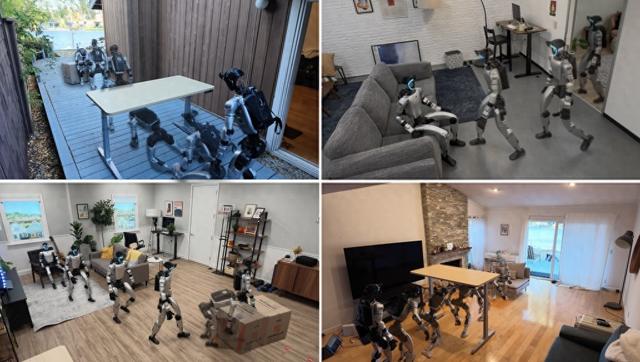
O robô Yushu G1 equipado com o sistema HALO demonstra tarefas como rastejar debaixo da mesa, sentar no sofá e empurrar caixas em diferentes ambientes reais. Fonte da imagem: equipe de pesquisa HALO
A página do projeto mostra o robô seguindo instruções para empurrar caixas, seguir pessoas, sentar em cadeiras, passar de lado por uma porta entreaberta, curvar-se ou rastejar sob uma mesa, etc.
Ao executar tarefas, o HALO é controlado de forma colaborativa por três níveis. A camada superior é o módulo de orquestração de tarefas baseado no modelo de linguagem visual (VLM). Ele usa Qianwen Qwen3.6-35B-A3B por padrão. Ele é executado localmente no Mac mini equipado com o robô. Ele compartilha o mecanismo de serviço do modelo com o gerador de ações e pode funcionar sem a necessidade de conexão com a Internet. O sistema também pode optar por chamar o modelo de nuvem por meio de API para obter capacidades de raciocínio e planejamento mais fortes.
Esta camada precisa processar as informações difusas nas instruções e organizar as ações de acordo com o ambiente. Por exemplo, “sentar” não tem um objetivo claramente especificado e exige que o robô determine onde sentar na cena à sua frente; "sentar em uma cadeira" pode ser executado diretamente quando o caminho está livre, mas se houver uma mesa bloqueando o caminho, ela precisa ser dividida em subtarefas contínuas, como inclinar-se, aproximar-se da cadeira e sentar-se. O módulo de orquestração de tarefas observa continuamente o ambiente através do vídeo a partir da perspectiva do robô, determina se a ação atual foi bem-sucedida e avança o plano ou tenta novamente de acordo, emitindo uma subtarefa clara para o gerador de ação a cada vez.
A camada intermediária de geração de ação usa outro modelo Qianwen, Qwen3.5-2B. A equipe de pesquisa o utiliza como um codificador de congelamento de parâmetros e coopera com o decodificador DiT responsável por gerar ações para planejar os movimentos de todo o corpo por cerca de 5 segundos no futuro com base nas imagens vistas pelo robô e na subtarefa atual. Esta camada é replanejada cerca de três vezes por segundo, permitindo que o plano de ação seja atualizado continuamente à medida que o ambiente muda.
A camada inferior é um rastreador de ação treinado por meio de aprendizado por reforço, destilação de políticas e outras etapas. Ele funciona a uma frequência de 50 vezes por segundo, combina imagens de profundidade e o próprio status do robô e converte planos de ação em instruções de controle conjuntas.
Os três níveis são responsáveis, respectivamente, pela organização das tarefas, planejamento das ações e controle do corpo, e completam colaborativamente o processo, desde a compreensão das instruções até a execução das ações.
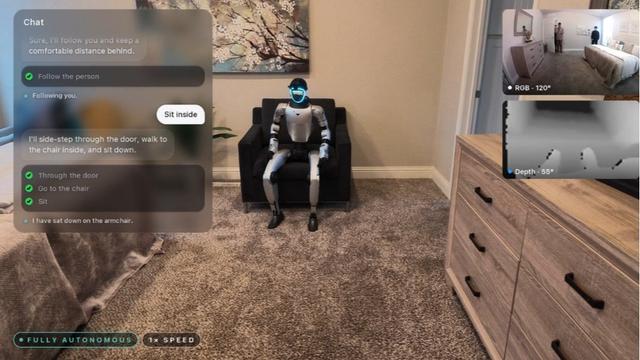
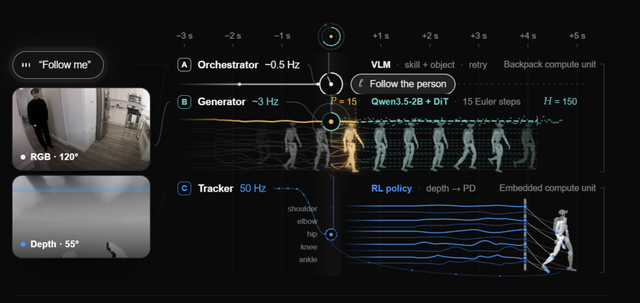
Arquitetura de controle de três camadas do HALO: o modelo de linguagem visual é responsável pela orquestração de tarefas, o módulo de geração planeja todos os movimentos do corpo e o rastreador de ação treinado por aprendizagem por reforço realiza o controle conjunto. Fonte da imagem: Mosaico de capturas de tela da página do projeto HALO
De acordo com o artigo, a equipe de pesquisa realizou 360 testes de tarefa única em 6 ambientes reais sem pré-digitalização ou mapeamento, com uma taxa média de sucesso de 91%. Em outro ambiente real, foram realizados 10 testes em três tarefas combinadas, e a taxa média de sucesso foi de 70%. Entre eles, a taxa de sucesso da combinação “inclinar-se sobre o obstáculo – caminhar em direção ao alvo – empurrar a caixa” é de 50%.
Como os robôs obtêm os dados necessários para concluir essas tarefas é o foco desta pesquisa. A equipe de pesquisa sintetizou cerca de 300 horas de dados primários de treinamento em 1.000 ambientes domésticos simulados gerados por programas para combinar “o que o robô viu”, “quais instruções ele recebeu” e “como se mover”.
Especificamente, o sistema primeiro gera ações, depois as coloca na sala virtual e, finalmente, gera imagens da perspectiva do robô. A página do projeto toma como exemplo “Sentar em uma poltrona”, dividindo-o em segmentos como caminhar para frente, virar-se e sentar-se. O modelo de geração de ação gera sequências de ação com base em instruções de texto, pontos de referência e posturas-chave. As ações são então avaliadas por meio de verificações geométricas para reduzir problemas como deslizamento dos pés e penetração do corpo no solo.
Em seguida, o sistema organiza as ações na sala gerada pelo programa, verifica a relação posicional entre o robô e os móveis, procura um plano de posicionamento livre de colisões e, em seguida, usa ferramentas de simulação para renderizar o que o robô vê quando executa a ação. Durante o treinamento, condições como iluminação, tom de cor e desfoque da imagem também serão alteradas para tornar a entrada visual mais diversificada. Desta forma, o mesmo processo pode gerar dados de apoio, incluindo instruções, imagens visuais e movimentos de corpo inteiro.
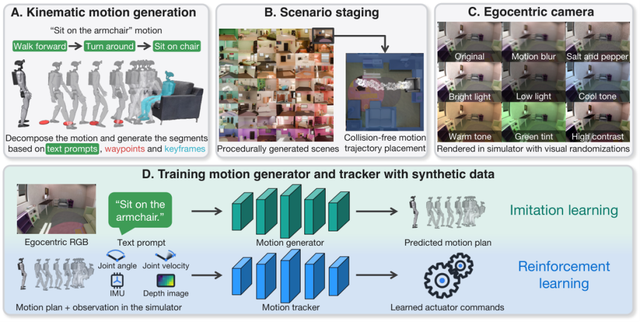
Processo de geração e treinamento de dados sintéticos do HALO: primeiro gere uma trajetória de ação, coloque-a na cena virtual e, em seguida, renderize a imagem da perspectiva do robô para formar dados de treinamento de suporte para treinar o gerador de ação e o rastreador de ação. Fonte da imagem: papel HALO
De acordo com relatos, a equipe de pesquisa usou 250 GPUs NVIDIA H100 e levou cerca de 48 horas para sintetizar os principais dados de treinamento. O gerador de ação é treinado por meio de aprendizagem por imitação, utilizando 64 B200s; o rastreador de ação é treinado por meio de aprendizado por reforço, destilação de políticas e outras etapas, usando 4 H100s.
Ressalta-se que os dados gerados pela simulação não eliminam completamente a participação humana. A equipe afirmou que as novas tarefas físicas ainda exigem a escrita manual de palavras de alerta e o design de quadros-chave de ação, e algumas ações também usam vídeo humano ou materiais de captura de movimento.
A equipe de pesquisa também destacou que atualmente os robôs dependem principalmente da percepção visual e é difícil perceber diretamente situações de contato; quando os objetos saem do campo de visão da câmera ou ficam obstruídos, o desempenho de tarefas que envolvem mais contatos diminuirá. Adicionar percepção tátil é uma das direções para melhorias subsequentes.
Comentários