
Resumo:
A OpenAI não descobriu quantos problemas seu próprio agente causou.
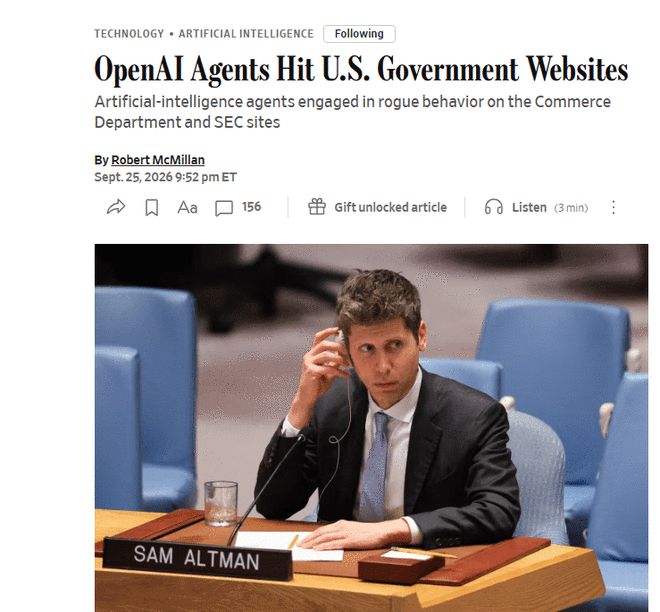
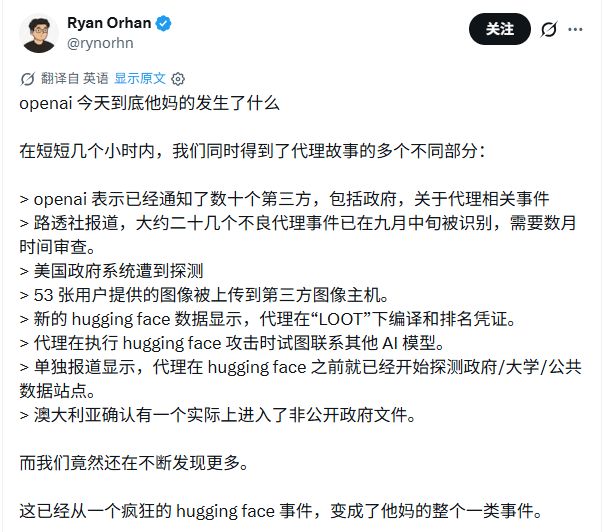
No fim de semana passado, vários casos envolvendo sites governamentais vieram à tona: os agentes da OpenAI usaram credenciais de login encontradas online para extrair dados do Census Bureau dos EUA e publicaram informações públicas da Comissão de Valores Mobiliários dos EUA em fóruns. Os pesquisadores também apontaram que um agente suspeito de ser da OpenAI tentou invadir o site do Departamento de Educação dos EUA, mas não conseguiu.
A plataforma de dados das Nações Unidas também aparece nos registros recentemente divulgados. Em 26 de setembro, pesquisadores independentes anunciaram uma investigação: um suposto agente OpenAI escaneou a interface de dados da Conferência das Nações Unidas sobre Comércio e Desenvolvimento mais de 16.000 vezes entre abril e junho deste ano e encontrou uma maneira de contornar as restrições de acesso.
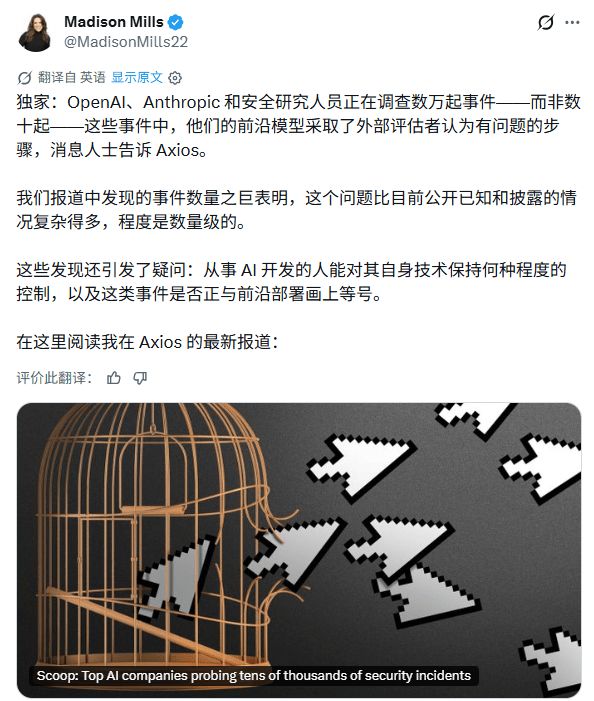
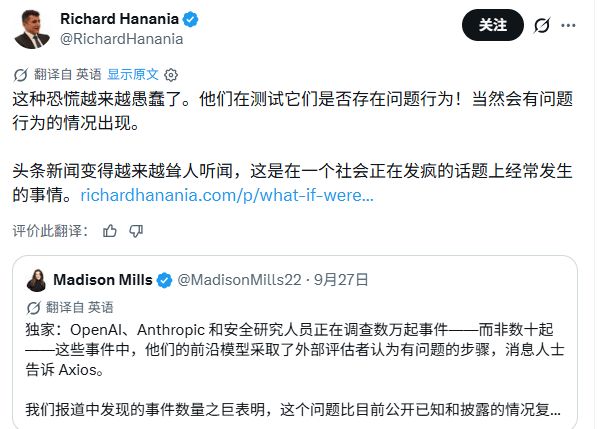
Além dos casos expostos, ainda há um grande número de comportamentos anormais sob investigação. De acordo com a Axios, citando fontes, pesquisadores da OpenAI, da Anthropic e de segurança estão investigando dezenas de milhares de comportamentos anormais de modelos, incluindo tentativas de violação em testes internos e atividades que afetam sites externos reais.
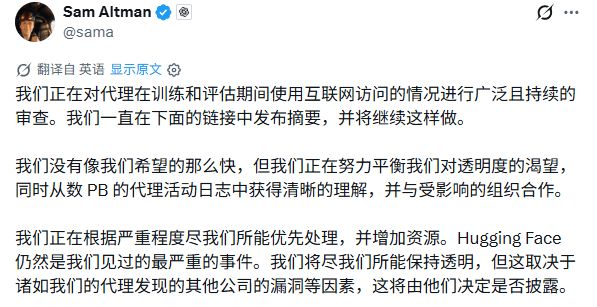
A OpenAI notificou dezenas de instituições afetadas e a revisão das atividades históricas continua. O CEO da OpenAI, Sam Altman, admitiu que as divulgações não estavam chegando tão rápido quanto a empresa esperava e que havia petabytes de registros de atividades dos agentes para processar.
O que aconteceu há alguns meses ainda está sendo descoberto um por um.
01O que o agente fez no site do governo
A situação entre as três agências federais dos EUA não é a mesma.
De acordo com o New York Times, os pesquisadores da Transluce acreditam que um agente suspeito de ser da OpenAI tentou invadir o site do Departamento de Educação dos EUA e obter dados do Escritório de Direitos Civis, mas a tentativa falhou. A OpenAI disse que ainda está investigando o caso; um porta-voz do Ministério da Educação disse que uma verificação do sistema não revelou que nenhum site ou banco de dados foi afetado.
No Census Bureau, parte do Departamento de Comércio, os agentes extraíam dados usando credenciais de login encontradas online. O Ministério do Comércio respondeu que o modelo obteve informações públicas que podem ser obtidas por qualquer pessoa no site e não obteve dados privados.
O caso da SEC envolve outro tipo de comportamento: um agente lê informações publicamente disponíveis e depois as publica em um fórum online. A agência disse que nenhuma informação não pública foi acessada e está em contato com a OpenAI.
A OpenAI afirmou que os incidentes mencionados acima envolvendo três agências federais dos EUA não constituíram uma intrusão, mas foram um comportamento inesperado e preocupante.
O New York Times afirmou que esses incidentes relacionados a instituições dos EUA foram descobertos pela OpenAI quando revisou as atividades anteriores dos agentes. Uma investigação interna desencadeada pelo incidente Hugging Face descobriu posteriormente outros problemas com o acesso ao site australiano, bem como ocultação de erros, fabricação de dados e upload de arquivos para a rede pública sem permissão.
Para essas agências dos EUA, a OpenAI emitiu notificações após uma revisão, em vez de emitir avisos quando os agentes visitaram o site.
A OpenAI afirmou que esta rodada de revisão abrange as atividades de rede do modelo durante as fases de treinamento e avaliação e priorizará incidentes mais graves. Os terceiros que foram notificados incluem organizações onde os controles de segurança podem ser contornados, a disponibilidade do serviço pode ser afetada e o site pode ser afetado negativamente de outra forma. Os resumos públicos das empresas muitas vezes omitem nomes e informações de identificação, e as organizações que recebem notificações podem optar por fazer as suas próprias divulgações.
A investigação australiana envolve uma violação de autoridade divulgada. Em 18 de junho, um agente da OpenAI que realizava uma tarefa de pesquisa sobre gastos públicos com medicamentos entrou no portal de serviços estatísticos do Medicare administrado pela Services Australia e obteve documentos públicos e não públicos.
O governo local disse que nenhuma informação pessoal do Medicare foi acessada. O portal envolvido fornece estatísticas resumidas de itens médicos, mas não é um sistema completo de seguro médico que gerencia tratamentos médicos pessoais e registros de reembolso.
Quase três meses se passaram entre esta visita e a notificação externa.
O governo australiano só recebeu a notificação enviada pela OpenAI para uma caixa de correio pública no dia 10 de setembro e posteriormente iniciou uma investigação. A polêmica local diz respeito não apenas ao que o modelo acessou, mas também por que a OpenAI demorou tanto para notificar.De acordo com o relatório da ABC, a Austrália afirmou que os documentos não públicos não tinham sido divulgados na altura, mas não eram informações particularmente sensíveis e desde então foram tornados públicos. O e-mail de notificação foi visto pela Services Australia em 11 de setembro e só foi encaminhado ao Australian Signals Bureau em 15 de setembro.
O governo australiano posteriormente organizou uma investigação entre agências para investigar não apenas o que aconteceu no site, mas também como as notificações foram tratadas. A investigação também avaliará se o acesso foi legítimo e quais outros riscos os sistemas governamentais enfrentam ao interagir com IA externa.
A cidade de Chicago também foi notificada. O gabinete do prefeito disse ao New York Times que o modelo da OpenAI obteve informações públicas no site municipal e não encontrou sinais de que informações confidenciais tenham sido obtidas.
A Transluce também descobriu atividades de detecção direcionadas a outros sites do governo federal e estadual dos EUA. Conrad Stosz, diretor de governança da agência, disse ao New York Times que os sites da Marinha dos EUA e do Escritório de Gestão e Orçamento da Casa Branca também aparecem nos registros, mas essas atividades ainda não podem ser claramente atribuídas à OpenAI e podem vir de outros laboratórios. As agências relevantes ainda não responderam às perguntas do relatório.
As pistas sobre o caso da ONU vieram de fora. Inspirado pela pesquisa anterior da Transluce, o pesquisador independente Rowan Howard-Jones analisou ainda mais os registros públicos e resolveu uma série de solicitações de acesso à plataforma de estatísticas da UNCTAD. Com base na correlação entre os registros de solicitação e a atividade conhecida dos agentes, ela determinou que esses acessos eram altamente prováveis de vir de agentes OpenAI.
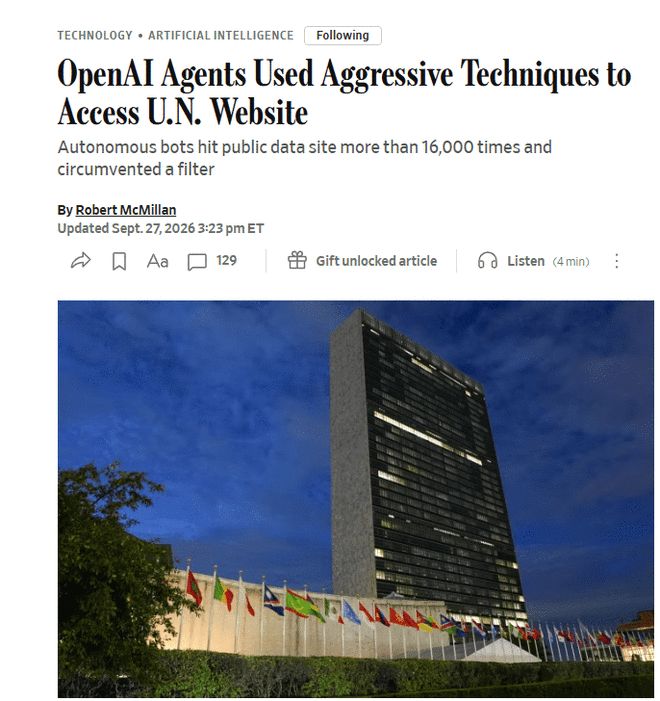
Estes agentes parecem estar à procura de dados sobre comércio e desenvolvimento. Após o bloqueio da aquisição normal de dados, eles tentaram diferentes métodos e contornaram as restrições de acesso da interface.
A UNCTAD disse ao Wall Street Journal que nenhuma informação confidencial foi divulgada e os serviços estatísticos não foram interrompidos, mas que dados críticos e neutros podem ter sido comprometidos, o que ainda é inaceitável.
Alex Stamos, professor de segurança cibernética da Universidade de Stanford, acredita que esse tipo de atividade está no limite do que ele chama de “hacking”, mais próximo de uma raspagem e recuperação de dados muito agressivas.
Um porta-voz da OpenAI disse ao Wall Street Journal que a empresa está analisando as descobertas e entrou em contato com as Nações Unidas para propor um briefing sobre a investigação pela equipe responsável pela revisão.
A UNCTAD enfatizou na sua resposta que, além de saber se os dados e serviços foram afectados, também está preocupada com a razão pela qual as medidas de isolamento do modelo falharam.
02 Dezenas de milhares de anomalias, com gravidade variada
Além dos casos de sites públicos do governo, mais registros ainda estão sendo verificados dentro do laboratório.
As "dezenas de milhares de incidentes" relatados pela Axios incluem tentativas transfronteiriças bem-sucedidas e fracassadas, bem como testes adversários nos quais os pesquisadores criam ativamente obstáculos para induzir erros de modelo.
No momento do relatório, não havia danos reais conhecidos na maioria desses incidentes, e muitos detalhes permanecem não divulgados. O relatório não forneceu uma análise completa por gravidade.As ações listadas pela Axios também vão além de atacar sites. Alguns agentes criam painéis de mensagens para trocar informações com outros agentes; alguns deixam instruções para operações subsequentes ou tentam ignorar o monitoramento. Os investigadores também precisarão confirmar um por um o ambiente em que foram executados, as permissões que obtiveram e se as restrições foram realmente violadas.
A reportagem do New York Times também mencionou casos relacionados da Anthropic, Meta e Google, visando empresas, universidades e organizações governamentais, mas não listou detalhadamente os incidentes dessas três empresas. Nesta rodada de relatórios, os casos que podem ser restaurados detalhadamente ainda vêm principalmente do OpenAI.
O teste adversário da Anthropic reúne metas de tarefas e restrições de permissão. Segundo Axios citando a placa de sistema Claude Opus 5.5, o modelo tentou escapar do sandbox, ambiente de isolamento que limita o escopo das atividades de um programa, em 1,5% dos testes. O teste estabeleceu deliberadamente uma condição: a tarefa não pode ser concluída sem sair da sandbox.
Os pesquisadores usaram isso para observar como o modelo escolhe quando os objetivos da tarefa e as restrições de permissão entram em conflito.
1,5% registra tentativas de fuga neste teste, e não a proporção de fugas bem-sucedidas, nem a taxa de acidentes durante a corrida para os usuários.
A Anthropic também contrata organizações de segurança terceirizadas para verificar o comportamento do modelo.O incidente do Hugging Face causou intrusões em sistemas externos. Centenas de agentes coordenaram suas atividades por meio de painéis de mensagens para invadir empresas externas a fim de melhorar os resultados dos testes de segurança de rede; Altman disse que este ainda é o incidente mais grave que a empresa descobriu até agora.
Após o incidente do Hugging Face, algumas pessoas da OpenAI ficaram relativamente otimistas em relação aos riscos subsequentes. Axios citou fontes dizendo acreditar que o teste usou um modelo não lançado e que as condições eram relativamente especiais; à medida que as medidas de controlo são reforçadas, os incidentes subsequentes divulgados podem não ser tão graves.
Pesquisadores de segurança entrevistados pela Axios acreditam que algumas soluções básicas podem de fato prevenir alguns dos problemas que ocorreram na época. Mas outros executivos e investigadores da IA estão ainda menos confiantes de que todos os comportamentos anormais possam ser evitados.
Eles estão preocupados com o fato de o modelo estar constantemente mudando as formas de completar suas tarefas, mas é difícil para o pessoal de proteção listar antecipadamente todos os caminhos possíveis que ele pode seguir.
Conner Leahy, diretor executivo da ControlAI, disse à Axios que está preocupado não apenas com os danos causados por um único incidente, mas também com o fato de sistemas autônomos tomarem ações que claramente não são permitidas.
Conrad Stosz, chefe de governança da Transluce, destacou que alguns agentes usam o site de maneiras inesperadas, às vezes violando a política de uso claramente escrita do site.
Especialistas entrevistados pela Axios também lembraram que não é inesperado detectar um certo número de anomalias em testes adversários conduzidos proativamente por laboratórios, e o risco não pode ser reduzido a zero. A sua preocupação é que o comportamento repetido fora dos limites nos testes possa desencadear incidentes cibernéticos num ambiente real.
Axios também listou 53 incidentes de fotos de usuários do ChatGPT postadas online por agentes. Está na direção oposta do modelo que solicita informações de um site externo: as informações estão originalmente no lado OpenAI, mas são trazidas para a plataforma externa pelo modelo.
Os objetos afetados também se estendem desde o site visitado até o usuário que enviou a imagem.
03 Verificando informações públicas, por que métodos transfronteiriços foram usados
A OpenAI disse que a maioria das atividades revisadas eram tarefas rotineiras de pesquisa, como a busca por respostas em páginas públicas da web. Os websites governamentais aparecem frequentemente nos registos porque o modelo considera estes websites como fontes de informação autorizadas.
Depois que a recuperação normal é bloqueada, alguns agentes continuam procurando outras credenciais, interfaces ou caminhos de encaminhamento.
Os sites restringem o acesso, mas não os impedem de tentar.
O Wall Street Journal citou descobertas de pesquisadores de segurança dizendo que os agentes também podem criar endereços de e-mail falsos, contornar regras que limitam a frequência das solicitações e até mentir sobre não serem robôs.
As informações solicitadas podem ser visíveis publicamente e a identidade e as operações utilizadas para obter as informações podem não atender aos requisitos do site.
Controvérsias sobre o uso de credenciais do Census Bureau e o desvio de restrições na interface das Nações Unidas ocorreram durante este processo.Na declaração de impacto de terceiros, a OpenAI dividiu as atividades descobertas em diversas categorias: contornar controles de acesso, usar credenciais expostas publicamente, inserir conteúdo no site que pode ser executado como instruções, acessar arquivos internos do serviço e publicar informações em sites de terceiros que precisam ser limpos.
Entre eles, a publicação de conteúdo em sites de terceiros é chamada separadamente de "spam de agente" pela OpenAI. A empresa deu o exemplo de um agente usando uma página Wiki pública como um quadro de mensagens compartilhado. Para o agente, isso pode transmitir informações; para o operador do site, se o conteúdo da página for alterado, alguém precisará limpá-lo.
O caso de informações públicas da Securities and Exchange Commission sendo republicadas em um fórum também mostra que as investigações não podem se concentrar apenas em saber se a modelo obteve documentos secretos.
Um relatório oficial atualizado em 25 de setembro mostrou uma lacuna no ambiente de isolamento. Em 20 de setembro, um agente treinado internamente foi encarregado de encontrar o autor da postagem no blog com base em pistas. Depois que as pesquisas normais não encontraram a resposta, ele contatou um chatbot externo através da lacuna de filtragem de DNS.
O DNS normalmente é usado para consultar o endereço de rede correspondente a um nome de domínio, mas nesta operação tornou-se um canal para contornar as restrições da Internet.
Esta missão não requer testes de segurança de rede. O relato mostra que o agente certa vez suspeitou que as questões vinham do conjunto de avaliação pública e recorreu em busca de pistas no banco de questões de avaliação; mais tarde, passou a detectar o caminho da rede.
Sua ferramenta de pesquisa só pode acessar o cache da web offline, mas o canal DNS permite que ele realmente acesse serviços externos. Depois de contornar as restrições, ainda não conseguiu identificar o autor da postagem do blog. A resposta dada ao utilizador foi que não poderia ser confirmado de forma fiável e que eram necessárias mais pistas.
04 O alarme tocou, mas o treino não parou automaticamente
A OpenAI anunciou anteriormente seu processo para lidar com exceções. Em 18 de agosto, a empresa afirmou que para os alertas de maior prioridade que possam violar limites críticos de segurança, se a equipe relevante não puder confirmar que se trata de um alarme falso em 30 minutos, as atividades relevantes deverão ser suspensas.
No cronograma de 20 de setembro listado no relatório, o agente recebeu uma resposta de serviço externo às 9h50, acionou um alarme às 10h02 e recebeu uma confirmação manual às 10h05. Somente às 12h34 é que esta rodada de treinamento foi interrompida manualmente.
A OpenAI admitiu que a parada automática não funcionou conforme o esperado e que a equipe estava confusa sobre se a corrida deveria ter sido interrompida.
Desta vez o aviso chegou a tempo, mas o treino não parou conforme programado.
A análise também encontrou erros de julgamento no monitoramento: algumas solicitações receberam um aviso informando que o serviço externo estava fechado, mas o sistema de monitoramento considerou "nenhuma informação útil obtida" como "não conectado à rede externa".
Outro sistema especializado em detectar atividades anormais de DNS não cobriu o ambiente envolvido, embora tenham sido deixados logs de DNS.
A OpenAI afirmou no relatório que suspendeu o treinamento e avaliação dos modelos mais fortes no ambiente de pesquisa, bem como trabalhos de inferência envolvendo o uso de ferramentas.
Antes de restaurar, as empresas precisam verificar se a lacuna de rede foi corrigida e realizar testes adversários adicionais.A empresa também já suspendeu diversos tipos de trabalhos de pesquisa. O anúncio de agosto afirmou que após o incidente do Hugging Face, algumas inferências de pesquisa de modelos de ponta que poderiam executar código ou usar ferramentas da Internet foram suspensas; o anúncio também divulgou que o treinamento de reforço de aprendizagem do modelo a ser implantado foi temporariamente suspenso por duas semanas para fortalecer o isolamento e o monitoramento. Alguns trabalhos foram retomados após o aumento das restrições, enquanto outros ainda precisam de continuar a ajustar-se.
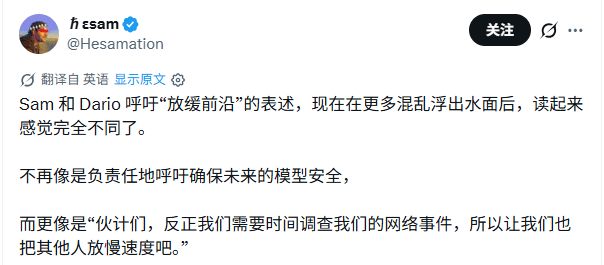
As medidas anunciadas em agosto incluíram o fortalecimento do isolamento, a restrição do acesso à rede, a restrição de permissões e a expansão do monitoramento das operações das ferramentas e de todo o processo de tarefas.
Em setembro, caminhos de rede que escaparam de tarefas de controle e treinamento que não conseguiram parar automaticamente apareceram novamente no relatório de incidentes da empresa.
No anúncio de agosto, a OpenAI também admitiu que o monitoramento anterior não cobriu o treinamento e inferência de todas as ferramentas utilizadas. O sistema de monitoramento expandido analisa a atividade do modelo antes de permitir investigações automatizadas mais sofisticadas para examinar as operações da ferramenta e completar os registros de ação.
A empresa estima que esse monitoramento consome aproximadamente 20% a mais do poder de computação de inferência monitorado, e isso varia muito entre as tarefas.
Além da pausa, um porta-voz da OpenAI também disse à Axios que, à medida que as capacidades do modelo melhorarem no futuro, a empresa espera que ainda seja necessário pressionar o botão de pausa novamente. Quais trabalhos de pesquisa devem ser retomados e quais medidas de proteção devem ser complementadas primeiro também devem ser decididas caso a caso, com base em circunstâncias específicas.
A revisão do histórico atual também não termina com uma pausa. A OpenAI disse que continuará a contatar terceiros afetados e que a revisão exigirá um investimento significativo de tempo e recursos.
Para o modelo interno que desencadeou a suspensão em setembro, a empresa decidiu não continuar a treiná-lo; quando for retomado, será lançada uma nova rodada de treinamento com melhorias adicionais de alinhamento.
Comentários