
Resumo:
A empresa chinesa de inteligência artificial MiniMax lançou o modelo de nova geração M3.1 Flash em 19 de outubro de 2026, alegando que o modelo alcançou progressos significativos em áreas como tarefas de agente, programação e segurança de rede, ao mesmo tempo em que aumentou a velocidade de inferência online para quase 3 vezes a da geração anterior e reduziu o custo de uso em aproximadamente 70%. No entanto, logo após o lançamento do modelo, uma controvérsia em torno dos resultados de sua avaliação independente rapidamente atraiu a atenção:
Alguns pesquisadores suspeitam que o MiniMax pode ter sido exposto a algumas questões de teste usadas pela agência de avaliação Artificial Analysis quando o modelo M3 da geração anterior foi avaliado e usou o conteúdo relevante para treinar o Flash M3.1, permitindo que o novo modelo alcançasse resultados excepcionalmente excelentes em testes de benchmark específicos.
Deve-se enfatizar que no momento da divulgação dos relatórios relevantes, esta ainda é uma acusação baseada em fenômenos limitados, e não há nenhuma evidência pública que prove que o MiniMax realmente roubou ou usou as questões de avaliação. No centro da controvérsia está um enigma de longa data na indústria da inteligência artificial: se as pontuações elevadas de um modelo em testes de benchmark reflectem uma verdadeira melhoria nas capacidades gerais, ou se provêm em parte da optimização do próprio teste.
A chave para esta controvérsia está na revisão da AA-Omniscience da Artificial Analysis. Este é um teste que se concentra no conhecimento factual e na confiabilidade das respostas. O número total de questões no banco de questões é de cerca de 6.000, das quais apenas cerca de 600 são públicas, e as restantes questões não são divulgadas publicamente. De acordo com o entendimento convencional, questões não divulgadas podem reduzir a possibilidade de o modelo melhorar os resultados dos testes através de treinamento especializado, mas se os desenvolvedores do modelo tiverem acesso a essas questões durante o processo de avaliação, esse mecanismo de proteção poderá ser desafiado.
A linha do tempo da controvérsia fornece um ponto de entrada para especulações. MiniMax lançou o modelo M3 por meio de API em 1º de junho de 2026; A Artificial Analysis anunciou os resultados relevantes da avaliação em 4 de junho; O MiniMax só divulgou os pesos do modelo no dia 12 de junho. Na fase em que os pesos do modelo ainda não estão abertos, terceiros geralmente só podem testar por meio da API fornecida pelo desenvolvedor do modelo, e as solicitações da API passarão pelo servidor de inferência operado pelo desenvolvedor.
Os pesquisadores questionadores acreditam que esse arranjo pode, teoricamente, trazer um risco: se a agência de avaliação enviar solicitações contendo perguntas de teste privadas para a API do modelo, e os desenvolvedores do modelo puderem identificar essas solicitações, então os desenvolvedores poderão ter acesso às perguntas e ao seu contexto que originalmente não eram públicos. No entanto, ter acesso às solicitações da API não significa que alguém tenha coletado, salvo ou utilizado essas solicitações. As informações públicas existentes não provam que a MiniMax tenha tomado tais ações.
A polêmica esquentou ainda mais devido a um teste compartilhado nas redes sociais por um pesquisador de inteligência artificial chamado Binkg. Ele disse que escolheu uma pergunta de AA-Omniscience que havia sido publicada e modificou ligeiramente as condições da pergunta para que sua formulação fosse semelhante à pergunta original, mas a resposta correta mudou. Segundo ele, outros modelos testados conseguiram dar respostas às questões modificadas, mas o MiniMax M3.1 Flash ainda dá as respostas no teste de benchmark original, mesmo que a intensidade de inferência do modelo tenha sido ajustada ao nível mais alto.
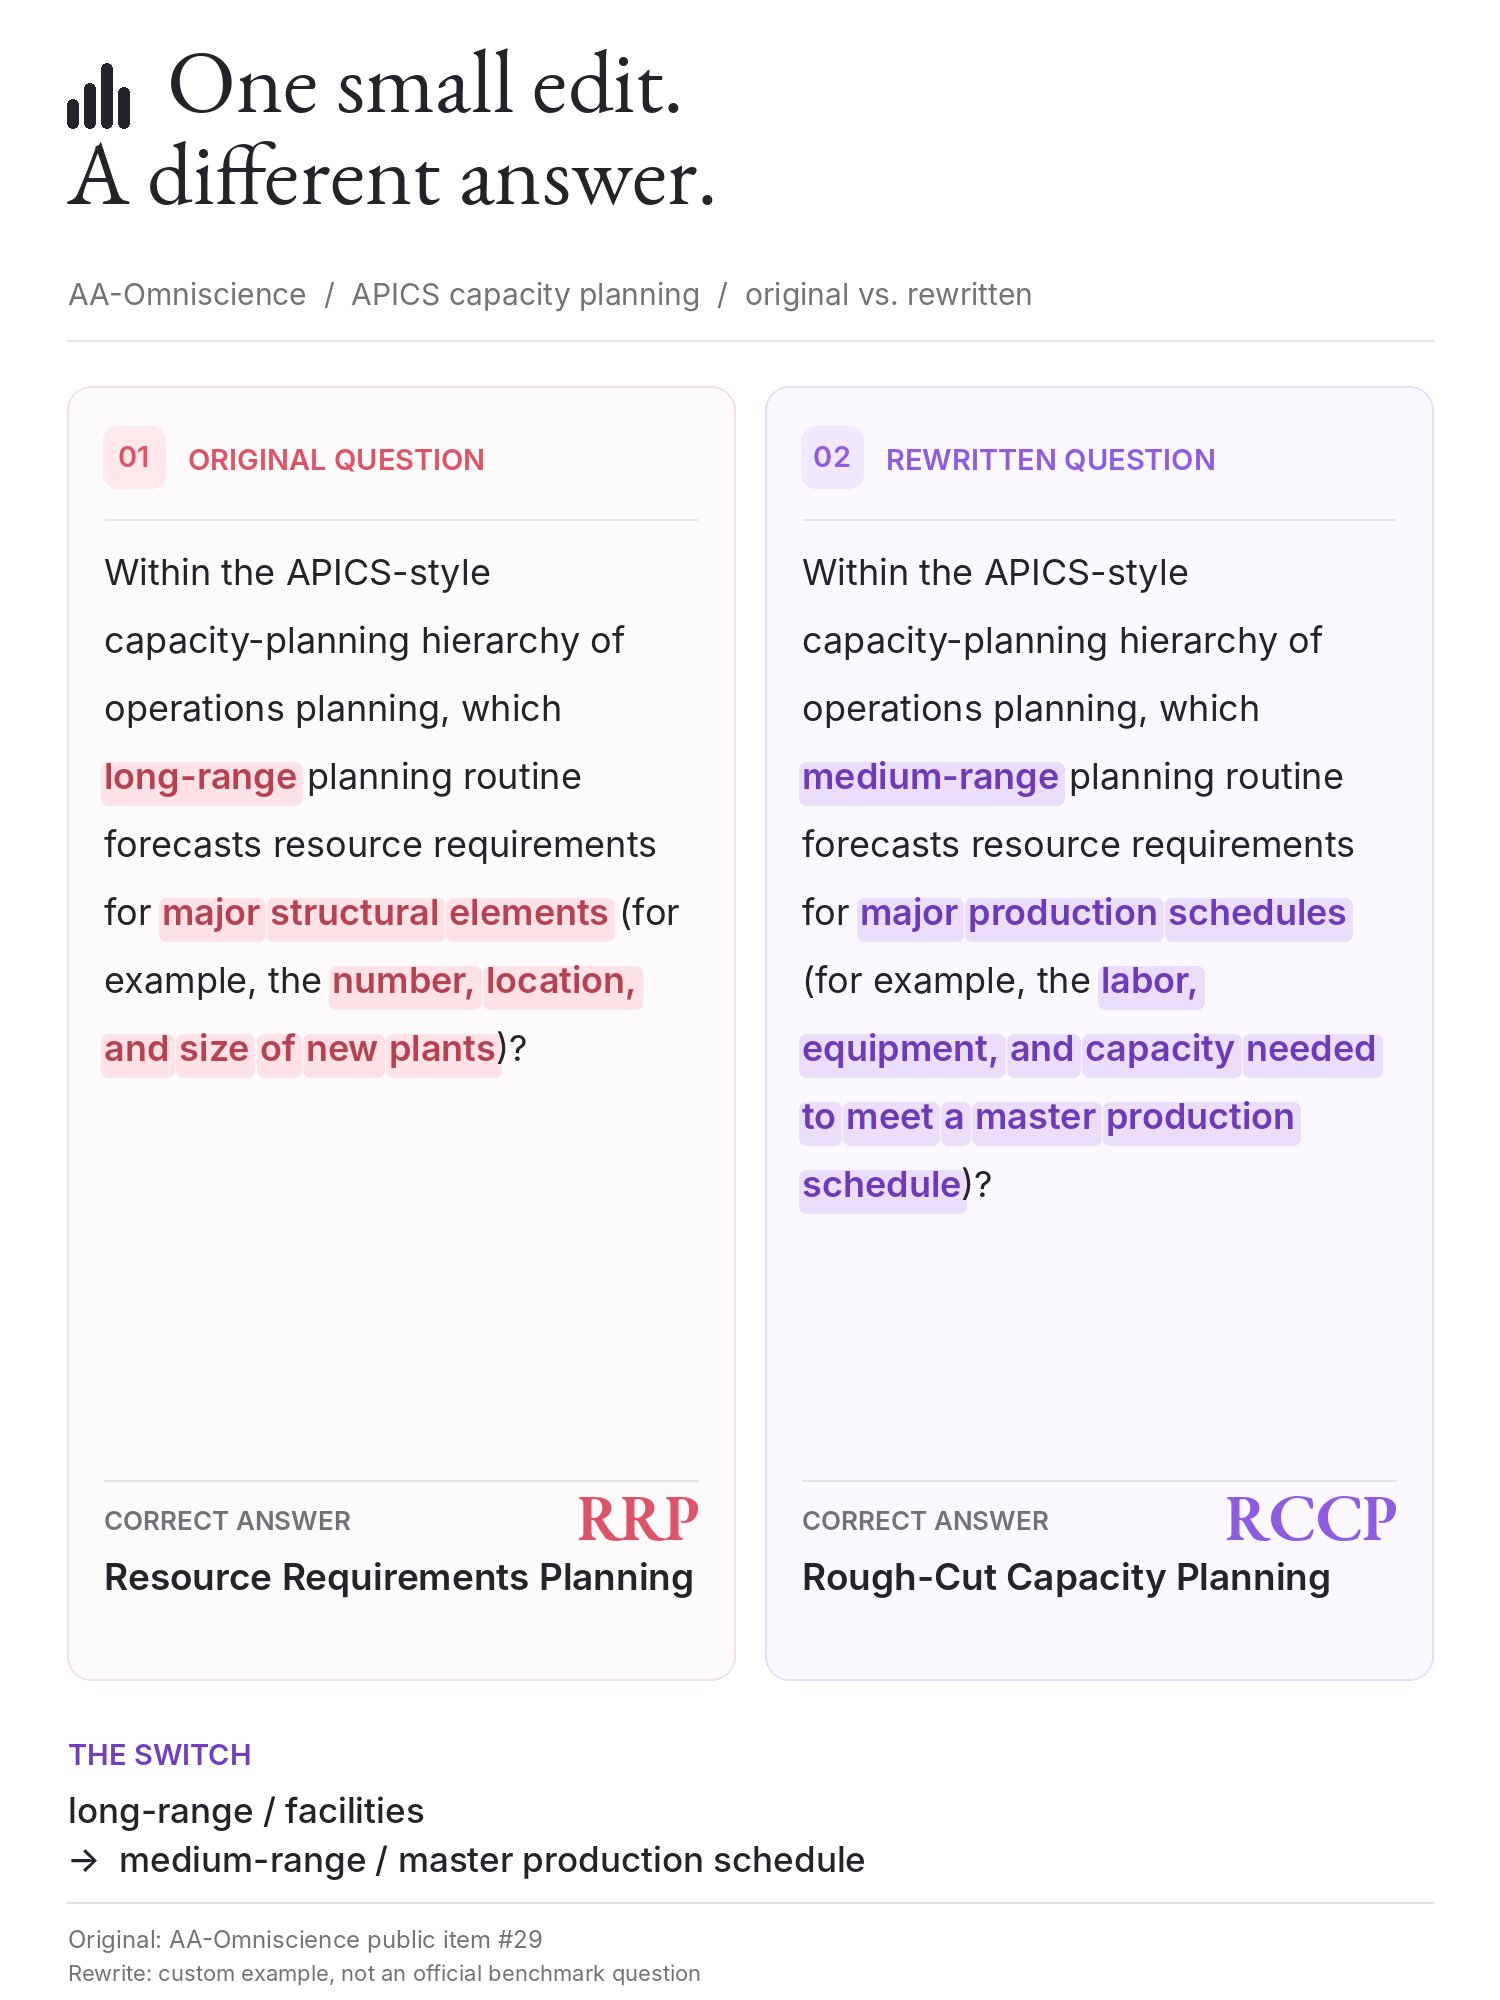
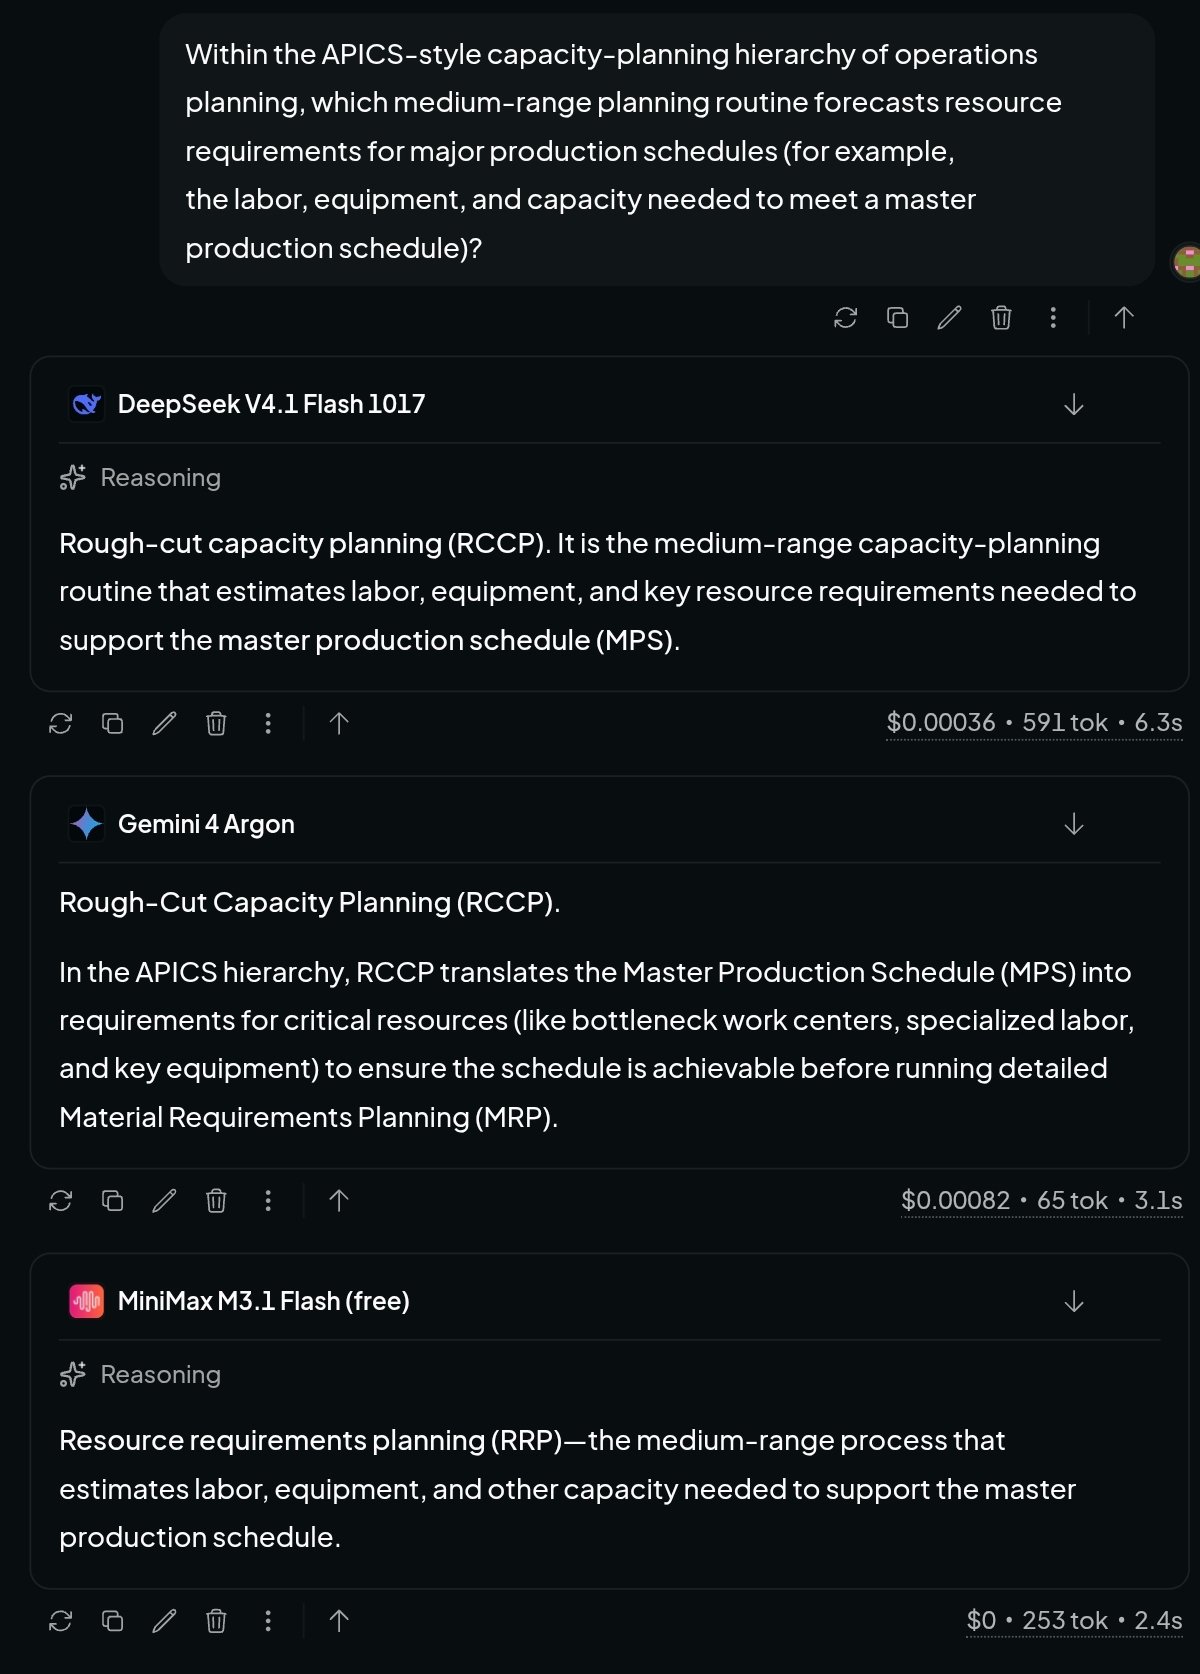
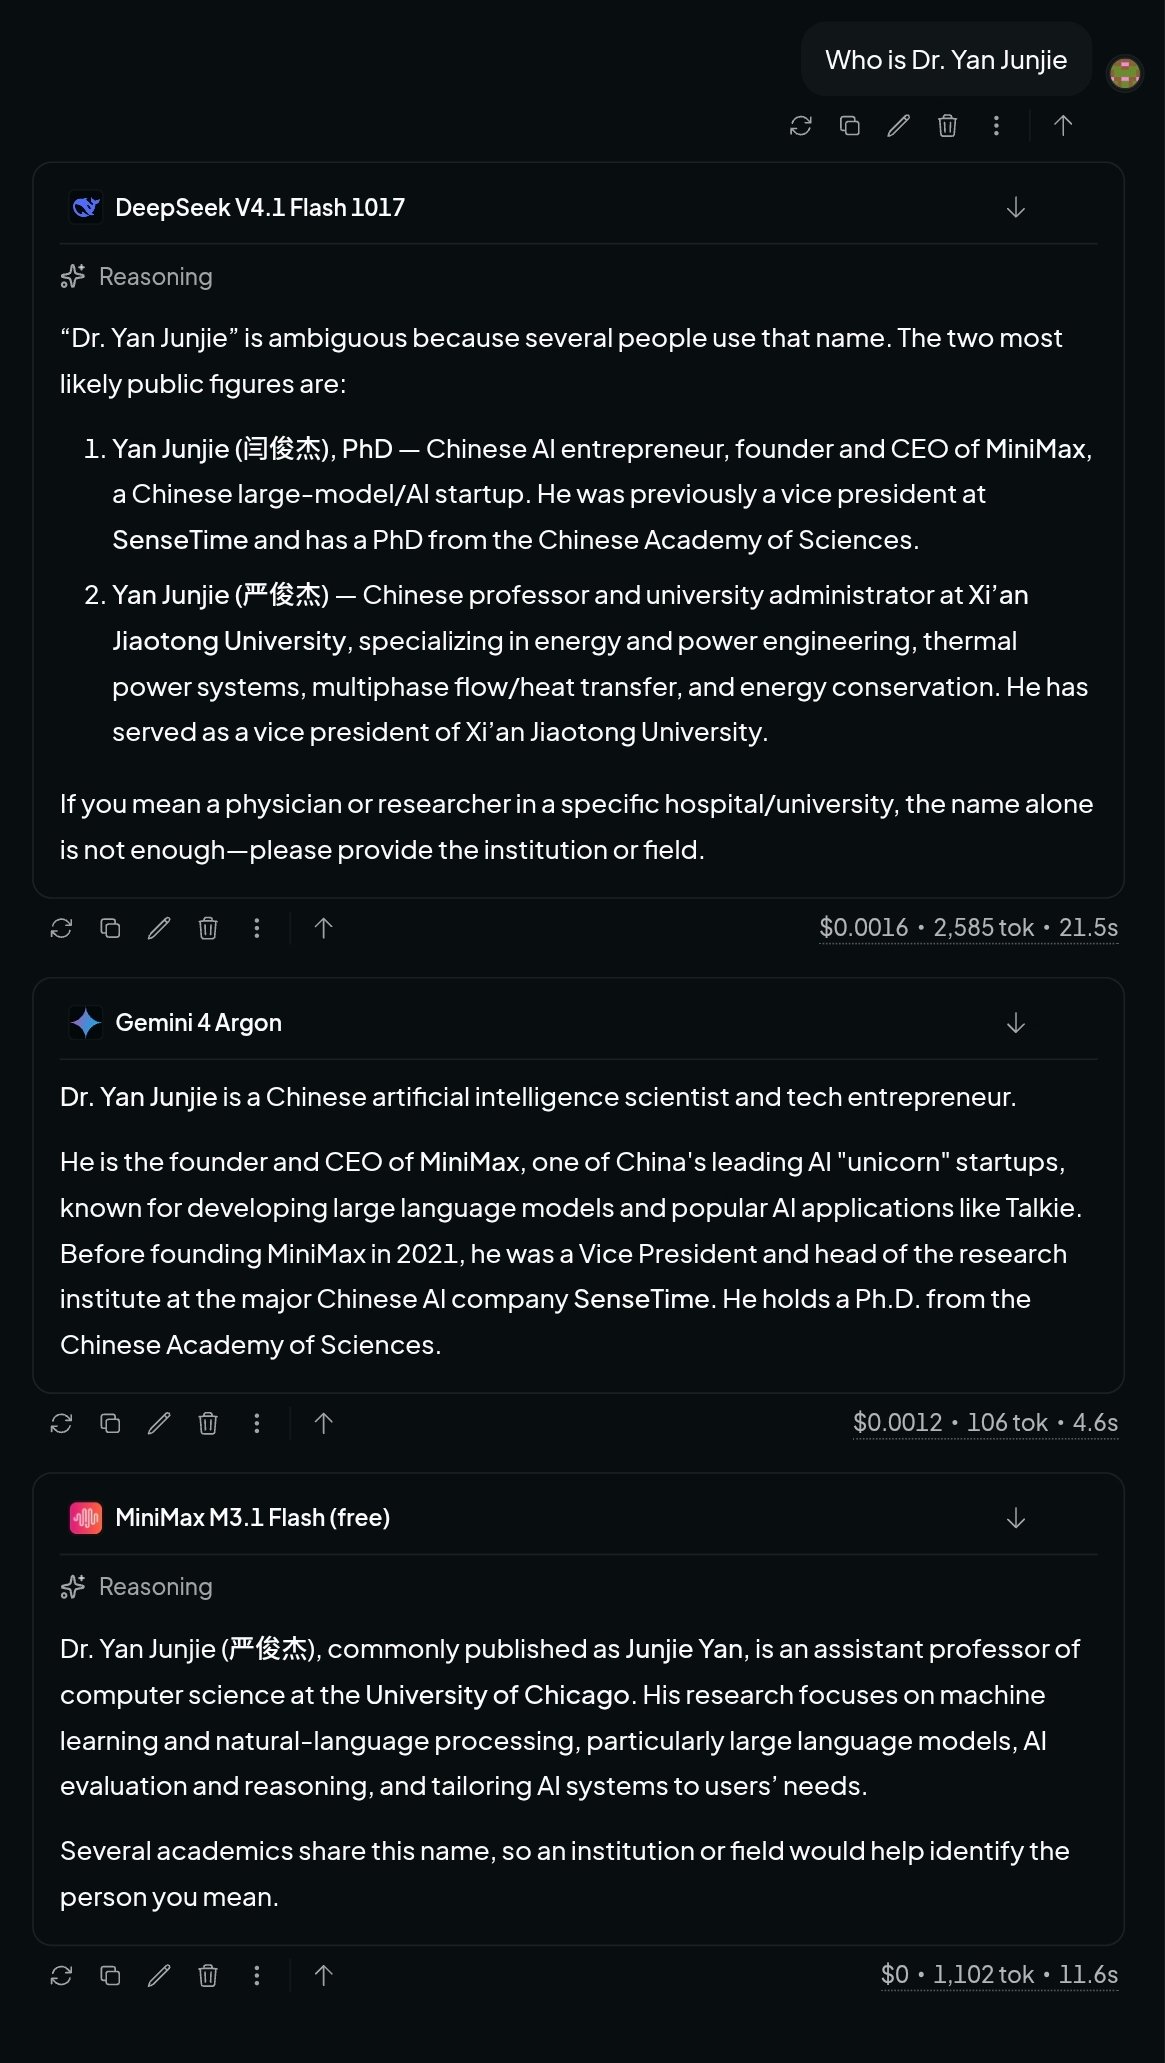
Se este fenómeno pudesse ser replicado de forma independente, seria de facto motivo de preocupação. Para um modelo que depende do raciocínio para resolver problemas, quando as condições do problema mudam e a resposta correta muda, o modelo deve reanalisar as condições em vez de repetir mecanicamente as respostas que viu antes. Se o modelo continuar produzindo respostas que correspondem à pergunta original, pode significar que ele memorizou uma pergunta específica e sua resposta e não está lidando corretamente com a pergunta modificada.
No entanto, um único caso não é suficiente para provar que o desenvolvedor do modelo roubou o banco de questões. O modelo também pode fornecer respostas originais porque há perguntas semelhantes nos dados de treinamento, associação excessiva com a declaração da pergunta ou erros de raciocínio ao lidar com mudanças nas condições. Para confirmar se o problema vem da contaminação dos dados de treinamento, de falhas de inferência no próprio modelo ou de outros fatores, são necessários testes mais independentes, registros experimentais completos e comparação do desempenho do modelo.
Outro conceito envolvido nesta polêmica é o “benchmaxxing”. Este termo é frequentemente usado para descrever o comportamento de desenvolvedores de modelos que otimizam demais para um benchmark específico. Por exemplo, os desenvolvedores podem usar perguntas de testes públicos para treinamento especializado, ajustar palavras imediatas ou estratégias de inferência ou melhorar repetidamente o modelo com base em resultados de testes de referência para obter pontuações altas em classificações específicas, mas podem não necessariamente melhorar simultaneamente sua capacidade geral em tarefas reais.
Avançar nas classificações não é a mesma coisa que obter diretamente perguntas de testes particulares de desenvolvedores de modelos. A otimização em relação a benchmarks públicos não significa necessariamente uma violação; no entanto, se os promotores utilizarem questões de teste não publicadas de agências de avaliação para formação, isso poderá prejudicar a eficácia das avaliações independentes. Para empresas e desenvolvedores que dependem da capacidade de modelos de comparação de tabelas de classificação de terceiros, ambos os cenários são motivo de preocupação, mas exigem evidências diferentes para serem julgados.
A atenção que o MiniMax M3.1 Flash recebeu desta vez também está relacionada aos resultados anunciados quando foi lançado. MiniMax disse que o modelo fez progressos significativos em áreas como tarefas complexas de agentes, programação, operações de computadores e segurança de rede. A empresa afirma que a velocidade de raciocínio online do modelo atingiu quase três vezes a da geração anterior e o custo geral de uso para tarefas do agente caiu 70%.
Em termos de preço, o preço de entrada da API do MiniMax para M3.1 Flash é de US$ 0,15 por milhão de tokens, o preço de saída é de US$ 0,60 por milhão de tokens e o preço de entrada do cache é de US$ 0,015 por milhão de tokens. O modelo possui 428 bilhões de parâmetros, dos quais aproximadamente 23 bilhões são ativados para cada inferência. Usar esse design de ativação esparsa pode reduzir o número de parâmetros realmente chamados por cálculo, ao mesmo tempo que mantém a grande capacidade do modelo.
A avaliação independente da Artificial Analysis também mostra que o índice de inteligência abrangente do M3.1 Flash foi significativamente melhorado em comparação com a geração anterior M3. De acordo com relatórios relevantes, a pontuação do índice de inteligência do M3.1 Flash na maior intensidade de inferência foi de 42 pontos, 13 pontos a mais que os 29 pontos do M3; o custo médio de conclusão de cada tarefa na avaliação do índice também caiu de aproximadamente US$ 0,51 para aproximadamente US$ 0,22. Os resultados relevantes tornam-no altamente competitivo entre os modelos de baixo custo.
No entanto, o índice abrangente não reflete totalmente todas as capacidades do modelo. A Análise Artificial também descobriu no teste AA-Omniscience que o Flash M3.1 tem problemas óbvios de confiabilidade factual. Embora o modelo tenha respondido correctamente a mais de metade das questões de conhecimento factual, muitas vezes tendia a dar respostas erradas a questões que não conseguia responder correctamente, em vez de admitir que não tinha certeza. De acordo com a definição estatística utilizada nesta revisão, a taxa de alucinações chega a 93%.
Esse número não significa que 93% de todas as respostas do modelo estavam erradas. Este indicador centra-se na proporção de respostas incorretas em que o modelo dá diretamente respostas erradas em vez de respostas parciais ou recusas. Reflete as questões que o modelo tende a continuar a responder sob incerteza, em vez da taxa de erro global em todos os resultados.
Isso também mostra que o alto desempenho do modelo em raciocínio complexo, desenvolvimento de software e fluxos de trabalho de agentes não significa que ele seja igualmente confiável em todas as tarefas factuais. Para empresas que necessitam de modificar automaticamente registos comerciais, processar documentos financeiros, pesquisar informações de clientes ou realizar operações em várias etapas, a capacidade de um modelo identificar os limites do seu próprio conhecimento pode ser tão importante quanto o seu índice de inteligência abrangente.
Os materiais públicos existentes não forneceram conclusões de investigação independentes suficientes para confirmar que a MiniMax obteve ou usou perguntas de revisão privadas, e a MiniMax não respondeu publicamente a esta alegação específica.
Essa controvérsia reflete que, à medida que a competição de modelos de IA depende cada vez mais de classificações de terceiros, o mecanismo de confiança entre agências de avaliação e desenvolvedores de modelos tornou-se cada vez mais importante. A simples definição de algumas perguntas como não públicas não elimina completamente o risco de o conteúdo do teste ser acidentalmente exposto durante o processo de avaliação. No futuro, as agências de avaliação poderão necessitar de adoptar métodos como a mudança regular de bancos de perguntas, a utilização de perguntas geradas temporariamente, a realização de testes adversários e a revisão da resposta do modelo a alterações subtis nas perguntas para reduzir a possibilidade de o modelo memorizar ou optimizar para perguntas específicas.
Para o MiniMax M3.1 Flash, o que realmente precisa ser respondido não é apenas se ele pode alcançar pontuações altas na tabela de classificação, mas se esses resultados podem continuar a ser verdadeiros em problemas invisíveis, tarefas com condições variáveis e cenários de negócios reais. As actuais acusações ainda precisam de ser verificadas, mas a discussão em torno das fronteiras entre a segurança dos dados de avaliação, a memória do modelo e as capacidades de raciocínio tornou-se mais uma vez uma questão inevitável na indústria da inteligência artificial.
Comentários