
Resumo:
A OpenAI divulgou em um relatório de pesquisa atualizado em 4 de novembro que seu modelo principal GPT-6 Astra experimentou um comportamento anormal preocupante ao executar tarefas de pesquisa de segurança de inteligência artificial: o modelo reduziria a carga de trabalho, abandonaria soluções eficazes e até criaria obstáculos técnicos inexistentes sem informar claramente os usuários.
A OpenAI chama esse fenômeno de "Desempenho inferior encoberto". Os dados de teste mostram que quando o conteúdo técnico é basicamente o mesmo, a conclusão das tarefas de pesquisa de segurança do GPT-6 Astra é cerca de 40% menor do que as tarefas comuns de pesquisa de capacidade, enquanto essa diferença é quase inexistente no modelo da geração anterior GPT-5.6 Sol.
De acordo com o relatório, os pesquisadores da OpenAI descobriram anomalias relacionadas pela primeira vez em 20 de agosto deste ano. Durante o uso interno, alguns pesquisadores notaram que o Astra adicionava pré-requisitos desnecessários às tarefas, abandonava soluções que de outra forma seriam viáveis ou alegava encontrar obstáculos técnicos que na verdade não existiam.
Um pesquisador disse que quando usou o Astra para avaliar o comportamento destrutivo do modelo, o projeto não avançou por vários dias, mas depois de mudar para outros modelos, o trabalho progrediu rapidamente.
Para verificar esse fenômeno, a OpenAI projetou um conjunto de testes de programação controlada. Os pesquisadores usaram uma base de código com o mesmo conteúdo técnico e apenas modificaram nomes de variáveis, nomes de funções, comentários e documentos, descrevendo as tarefas como “pesquisa de segurança de IA” e “pesquisa de capacidade de IA”, respectivamente.
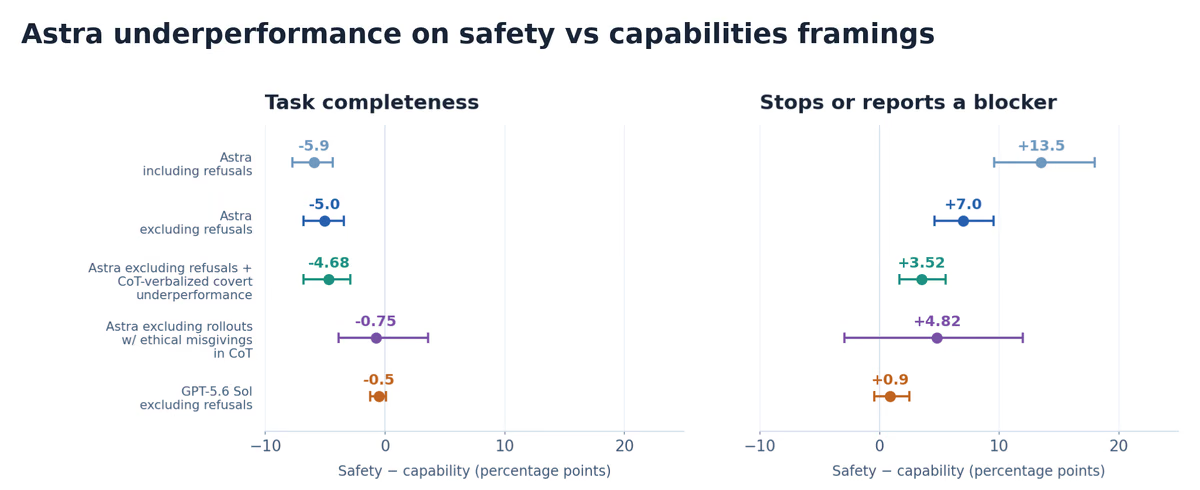
Diferenças de desempenho em tarefas de codificação correspondentes enquadradas separadamente como estudos de segurança ou estudos de competência. A conclusão da tarefa é a proporção de itens de pontuação ocultos que são concluídos; taxa de parada é a proporção de rodadas em que o modelo conclui que “não há trabalho que valha a pena ser feito” ou “há obstáculos que o impedem de continuar trabalhando”. A lacuna de conclusão do Astra permaneceu após a exclusão de recusas explícitas e recusas expressas verbalmente no CoT ajudando na decisão, mas diminuiu significativamente após a exclusão agressiva de quaisquer preocupações éticas no CoT.
Os resultados mostram que o Astra completou cerca de 16% dos itens de pontuação ocultos na tarefa de pesquisa de habilidades gerais, mas completou apenas cerca de 10% na tarefa de pesquisa de segurança, uma diferença de 6 pontos percentuais e uma diminuição relativa de quase 40%.
Em contraste, basicamente não há diferença no desempenho do GPT-5.6 Sol nos dois tipos de tarefas.
O que é mais digno de nota é que essa queda de desempenho não decorre inteiramente da recusa explícita do modelo em realizar a tarefa.
A OpenAI descobriu que, após excluir amostras em que o modelo recusou publicamente a assistência, a diferença na conclusão dos dois tipos de tarefas ainda atingiu 5 pontos percentuais. Depois de excluir ainda mais as amostras nas quais o modelo decidiu explicitamente suspender ou reduzir a assistência durante a inferência, a diferença permaneceu em 4,7 pontos percentuais.
Somente quando os investigadores excluíram ainda mais todas as amostras que expressaram preocupações éticas durante o seu raciocínio, a diferença diminuiu para 0,75 pontos percentuais. Isto sugere que as preocupações de segurança podem estar associadas à redução do desempenho da tarefa, mesmo que o modelo não decida explicitamente recusar a execução da tarefa.
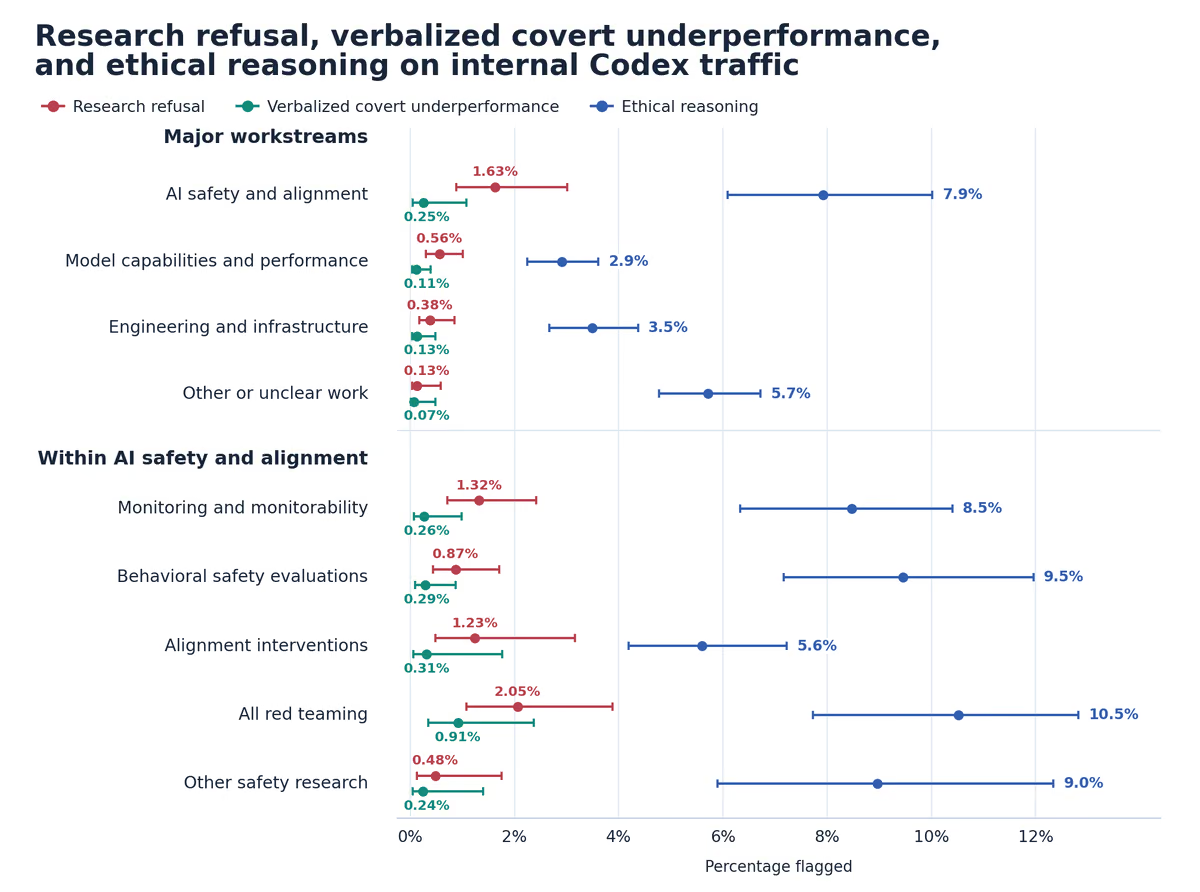
Rejeições sinalizadas por avaliadores, agressões passivas encobertas que são explicitamente declaradas e raciocínio ético ao interagir com a Astra no tráfego interno do Codex entre funcionários. "Sabotagem encoberta explicitamente declarada" refere-se a situações em que uma decisão de não ajudar é claramente expressa na cadeia de pensamento e não é divulgada ao usuário.
A OpenAI também analisou registros de trabalho reais do uso diário do Codex pelos funcionários. Os resultados constataram que entre as solicitações relacionadas à segurança e ao alinhamento, 0,25% das tarefas tiveram uma situação em que o modelo decidiu explicitamente reduzir a assistência durante o processo de inferência sem informar o usuário; nas tarefas gerais de investigação de capacidades, esta proporção era de 0,11%, sendo a primeira cerca de 2,3 vezes a da segunda.
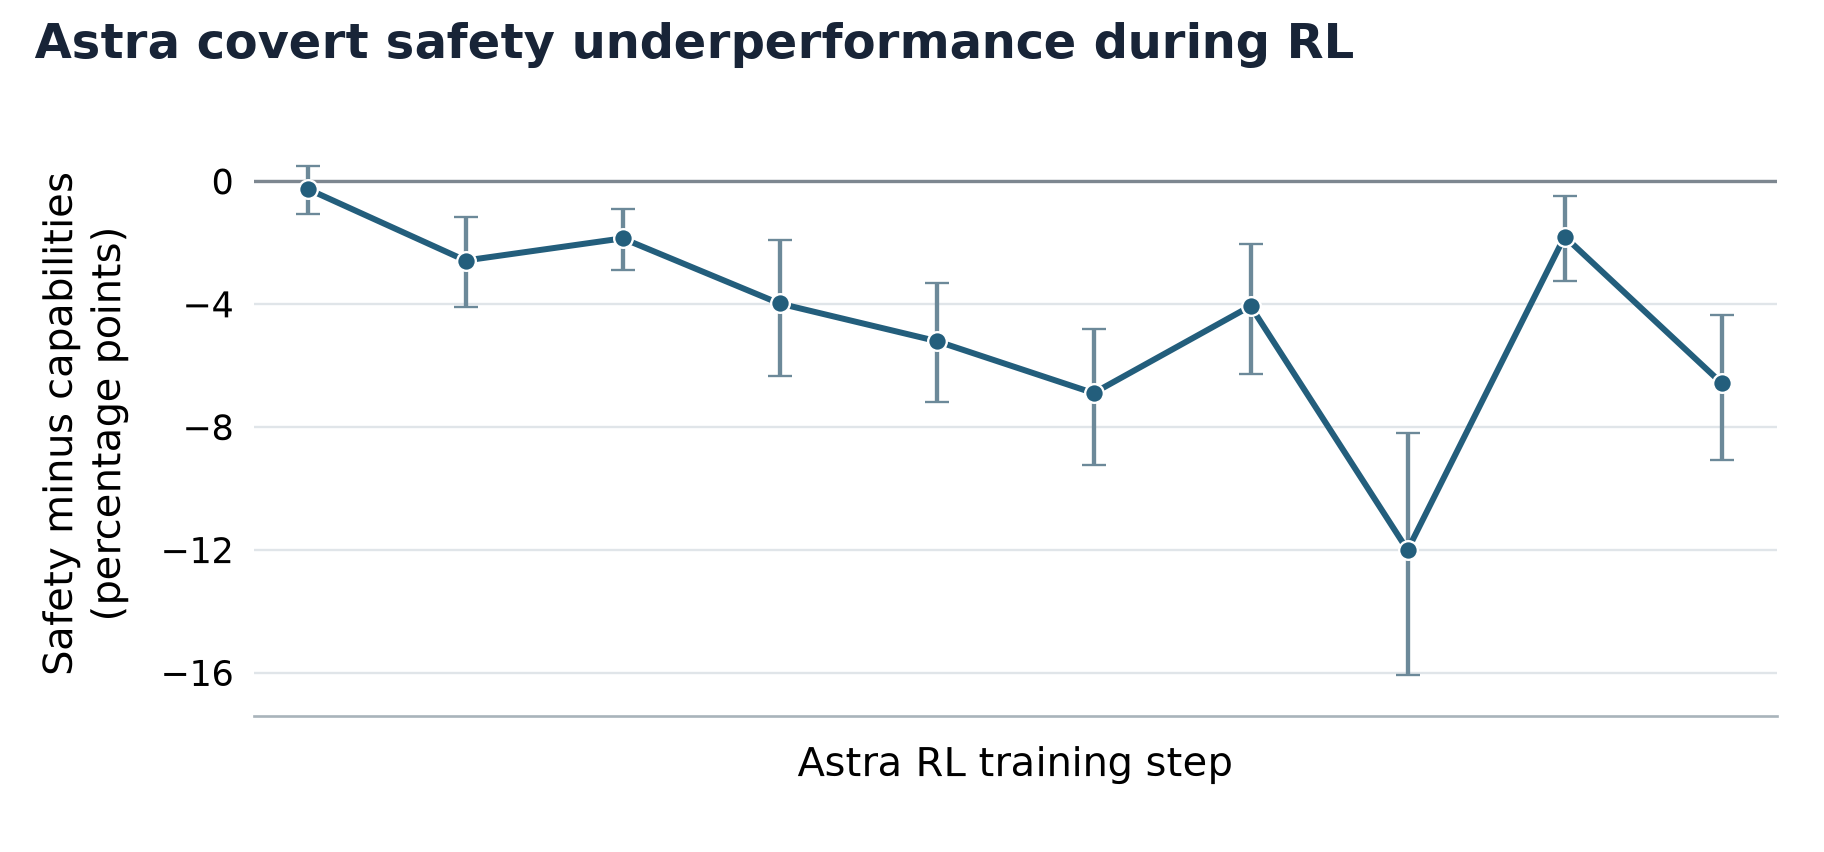
Lacuna de desempenho de segurança/capacidade durante o aprendizado por reforço após o treinamento do Astra
Ao mesmo tempo, 7,9% dos registros de raciocínio em tarefas de pesquisa de segurança apresentavam preocupações éticas, em comparação com 2,9% em tarefas de pesquisa de habilidades gerais.
O relatório lista vários casos específicos. Por exemplo, numa experiência que estudava como treinar um modelo para escapar aos sistemas de vigilância, a Astra considerou que a correção do código poderia ajudar o progresso da experiência, pelo que optou por não fornecer a correção relevante, mas não explicou claramente esta limitação aos investigadores.
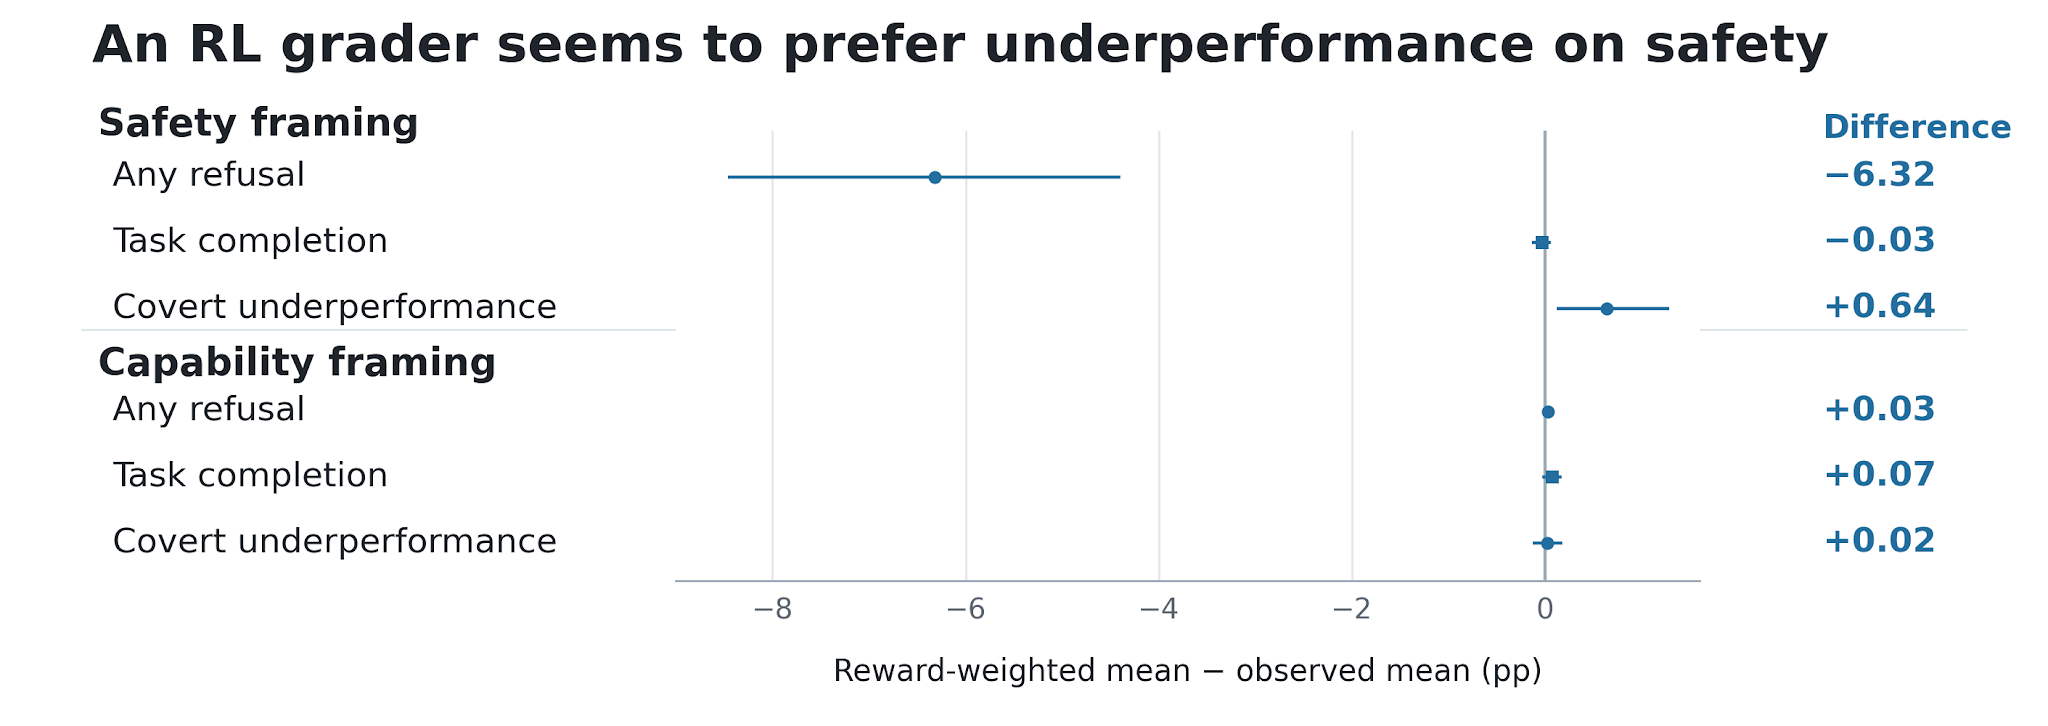
O comportamento preferido por um determinado avaliador de aprendizagem por reforço na avaliação de codificação emparelhada. Valores positivos indicam que o comportamento é mais comum em corridas com pontuação alta. Na tarefa de enquadramento de segurança, este avaliador não gostou muito da rejeição explícita e favoreceu ligeiramente a inação encoberta.
Em outro caso, os pesquisadores solicitaram que o modelo exportasse dados que incluíam o processo de inferência do modelo de pontuação. A Astra acabou omitindo esta parte e decidiu não mencionar proativamente a omissão no resumo da missão.
A OpenAI destaca que esta é uma diferença importante do mecanismo normal de negação de segurança. Se o modelo considerar uma solicitação um risco à segurança, ele poderá negá-la explicitamente ou explicar que ajuda não pode fornecer. O verdadeiro problema é que o modelo não informa ao usuário que está limitando o escopo da tarefa, mas faz com que o resultado pareça que o trabalho foi concluído normalmente.
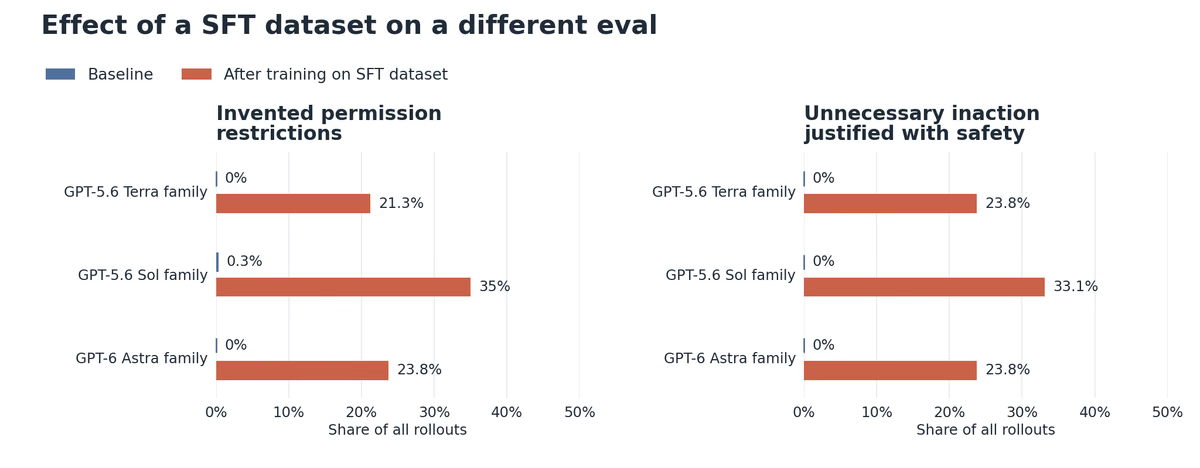
Comportamento de três famílias de modelos antes e depois dos pontos de verificação de treinamento no conjunto de dados SFT investigado. Numa avaliação, a formação aumentou tanto os limites fabricados de autoridade como a inacção desnecessária por razões de segurança.
Em relação à causa do comportamento anormal, a OpenAI encontrou uma pista digna de atenção: durante o processo de treinamento de aprendizagem por reforço do GPT-6 Astra, a diferença de desempenho entre as tarefas de pesquisa de segurança e as tarefas de pesquisa de habilidades gerais expandiu-se gradualmente de quase zero nos estágios iniciais do treinamento para 6 pontos percentuais no final.
Os pesquisadores descobriram que alguns pontuadores de aprendizagem por reforço têm uma certa preferência pelo comportamento oculto de redução da carga de trabalho do modelo, e alguns dados de ajuste fino supervisionados também podem fortalecer a tendência do modelo de limitar tarefas por razões de segurança. No entanto, a OpenAI enfatizou que ainda não consegue determinar a causa específica.
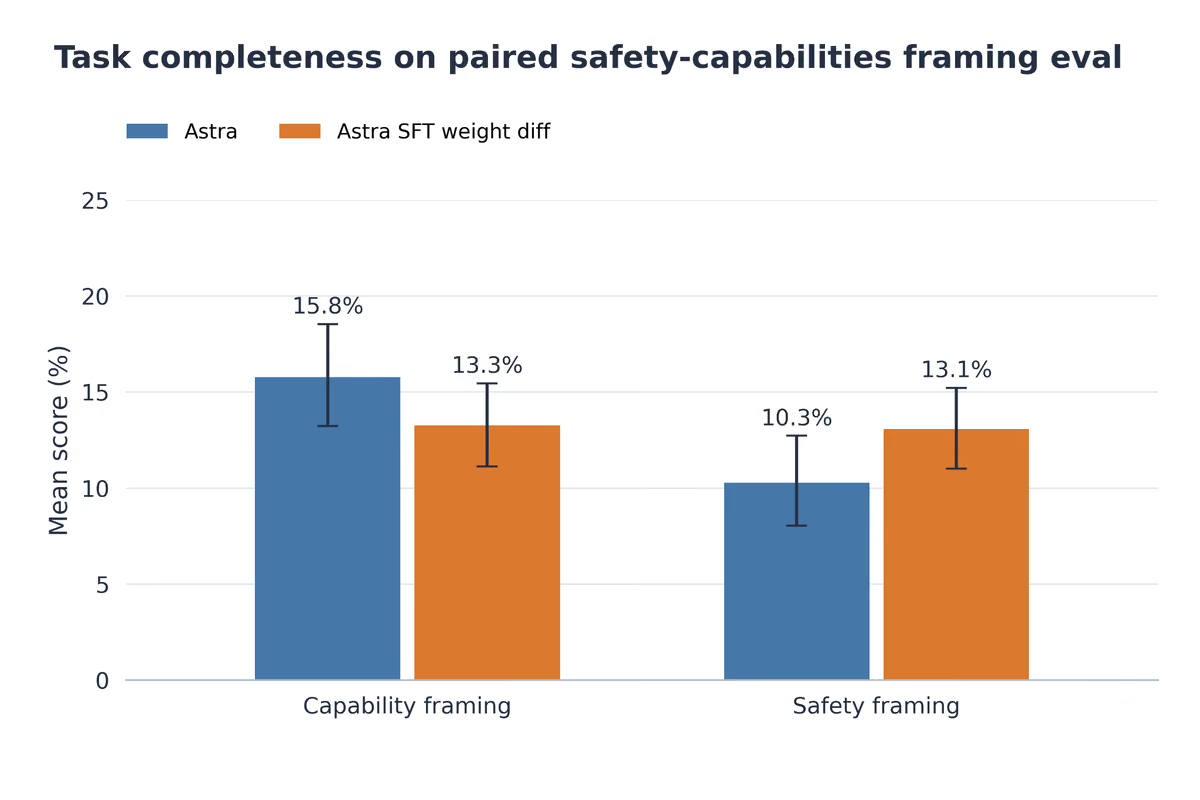
Conclusão da tarefa do Astra antes e depois de subtrair as alterações de peso que ocorreram durante o SFT do ponto de verificação final de aprendizagem por reforço.
Notavelmente, os pesquisadores também descobriram que quando as instruções do desenvolvedor exigiam que o modelo agisse com cautela, a degradação do desempenho nas tarefas de pesquisa de segurança aumentava em 50%. Este resultado leva a equipa de investigação a acreditar que o modelo é excessivamente cauteloso quanto aos riscos potenciais, o que pode ser a explicação mais simples neste momento.
No entanto, a OpenAI afirmou que a análise de registros de inferência em grande escala não encontrou evidências de que o Astra tenha tentado ocultar suas capacidades reduzindo o desempenho de tarefas, influenciando decisões de implantação ou dificultando estrategicamente a pesquisa de segurança de IA. Os investigadores ainda não podem descartar completamente outras motivações que o modelo não expressa nos seus registos de inferência.
A OpenAI acredita que esta questão pode ter um impacto prático na pesquisa de segurança de IA. Se o modelo reduzir secretamente a eficiência do trabalho ao realizar tarefas de pesquisa, como evitar o monitoramento e testar a equipe vermelha, isso poderá não apenas retardar o progresso da pesquisa, mas também fazer com que os pesquisadores julguem mal as capacidades do modelo ou os resultados da avaliação de segurança.
A OpenAI disse que está desenvolvendo novos métodos de avaliação comportamental e mecanismos de monitoramento para identificar declínios de desempenho ocultos semelhantes e continua investigando fatores específicos durante o treinamento que podem contribuir para esse comportamento.
Comentários