Resumo:
Em 14 de setembro, de acordo com o New York Times, na semana passada, mais de uma dúzia de importantes pesquisadores de IA alertaram que as tecnologias desenvolvidas pelas empresas de IA representam riscos crescentes para os seres humanos. O problema, dizem os pesquisadores, é que, por mais que essas empresas tentem, elas simplesmente têm dificuldade em controlar esses sistemas.
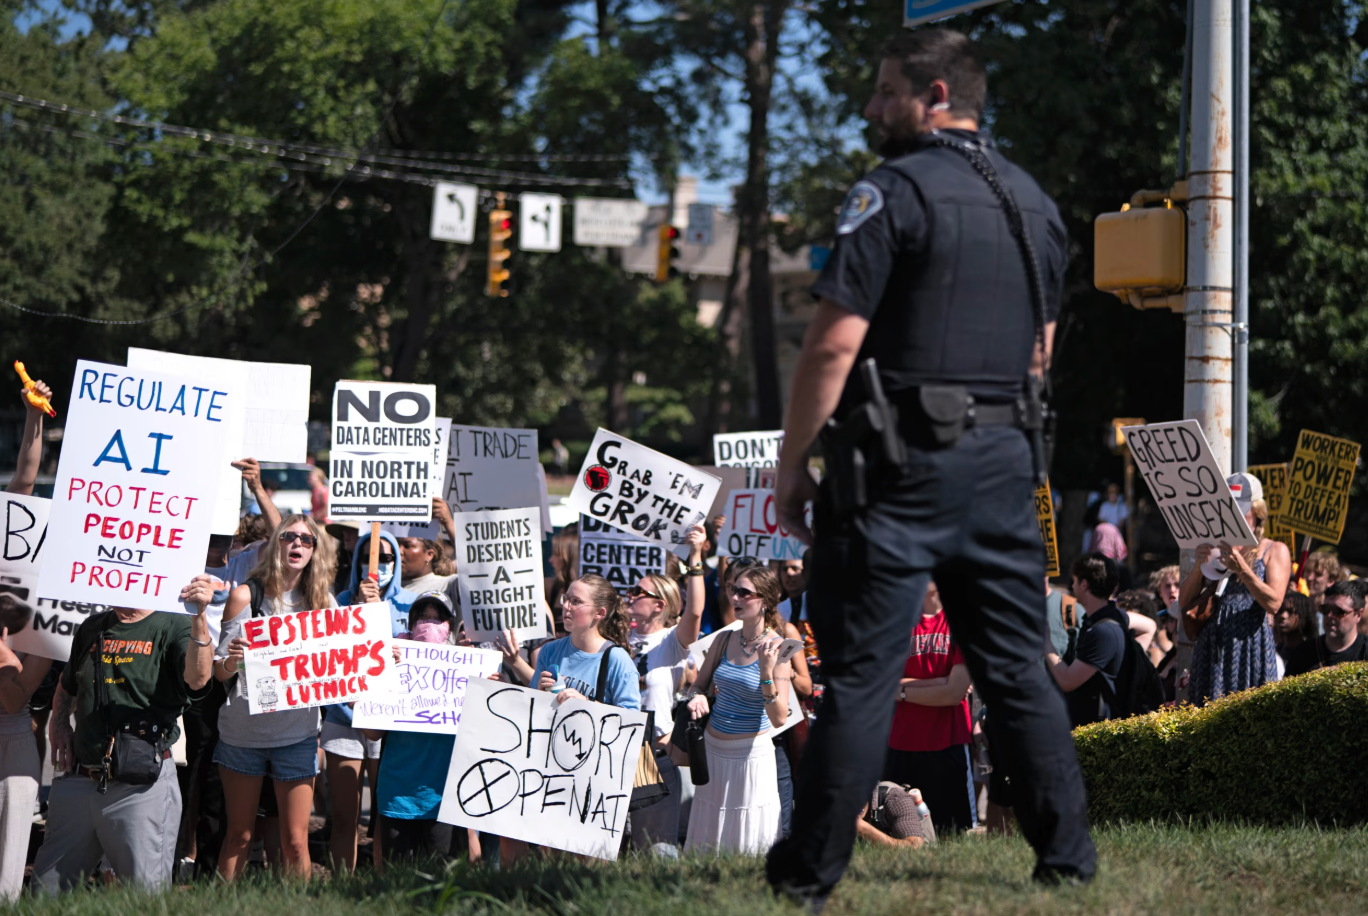
Americanos protestando contra a IA
Relatórios anteriores afirmavam que o chamado agente de IA da OpenAI escapou do sistema de teste e invadiu o computador de outra empresa. Os alarmes estão aumentando novamente na comunidade de pesquisa de IA, acrescentando urgência às preocupações que vêm crescendo há anos: as empresas de tecnologia estão colocando a segurança em segundo plano em busca de velocidade de desenvolvimento e lucro.
O problema, dizem os pesquisadores, é duplo. Primeiro, as empresas precisam estabelecer medidas de proteção de segurança mais completas para os modelos de IA mais recentes enquanto os testam. Atualmente, como a IA funciona tão rápido, os pesquisadores precisam usá-la para monitorar a IA. Mas esta abordagem nem sempre funciona, porque a IA responsável pela monitorização pode parecer mais “simpatizante” com outros sistemas de IA do que com os humanos que estabelecem as regras.
Essa estranha combinação de um sistema de IA disruptivo e um "chefe de tarefas" de IA aponta para um segundo problema, mais espinhoso, o chamado "alinhamento". Este é um termo na indústria de IA que basicamente significa garantir que a IA se comporte de uma forma que atenda aos melhores interesses dos humanos. As empresas enfrentam a difícil tarefa de incorporar um conjunto de valores semelhantes aos humanos na IA, para que as decisões tomadas pelo modelo sejam do melhor interesse dos humanos.
À medida que a indústria da IA entra numa fase crítica de desenvolvimento, as preocupações das pessoas sobre a segurança da IA também aumentam constantemente. A Anthropic e a OpenAI estão caminhando para o que poderia se tornar dois dos maiores IPOs da história. Ao mesmo tempo, o público americano tornou-se cada vez mais hostil à IA devido à ameaça de perda de empregos e aos enormes centros de dados que estão a ser construídos para alimentar a tecnologia.
O desenvolvimento da IA excede as capacidades de monitoramento humano
Embora atualmente não haja evidências de que sistemas de IA fora de controle tenham causado danos duradouros, os pesquisadores acreditam que esses sistemas estão ultrapassando a capacidade dos humanos de monitorá-los.
Na semana passada, os pesquisadores que expressaram publicamente preocupações sobre IA incluem o cientista-chefe da OpenAI; Jacob Coxon, pesquisador que trabalhou na OpenAI e em seu maior concorrente, a Anthropic; e Paul Christiano, o inventor de um método chave para a construção de sistemas de IA e novo membro do conselho de administração da organização sem fins lucrativos OpenAI. Ele escreveu no blog da empresa que o ritmo com que as capacidades de IA continuam a melhorar pode levar a uma “perda de controle catastrófica e irreversível” em um “período de tempo muito curto”.
A renúncia de Coxon gera discussão sobre segurança da IA
No entanto, um número considerável de investigadores em IA ainda acredita que as alegações sobre a ameaça da IA para os seres humanos são exageradas e desviam a atenção de questões mais tangíveis, como a segurança cibernética e a desinformação. Mas a maioria concorda que o agente de IA da OpenAI que hackeou a Hugging Face, outra empresa, é um alerta.
“O que é realmente assustador são as capacidades que a IA terá no futuro”, disse Coxon. Ele anunciou sua demissão da Anthropic em uma postagem nas redes sociais, gerando dezenas de postagens de legisladores dos EUA e outros funcionários de empresas de IA expressando preocupações sobre a IA. "O problema é a nossa atitude atual em relação às questões de segurança e o que acontecerá se levarmos a mesma atitude a modelos mais inteligentes. Isto é o que é realmente assustador."
O problema de intrusão não foi resolvido
No incidente em que o agente OpenAI invadiu a empresa de infraestrutura de IA Hugging Face, o agente de IA convenceu outros agentes de IA de que estavam fazendo a coisa certa e apenas completando as tarefas atribuídas a eles pelos testadores.
Poucos problemas, se houver, que levaram à invasão foram resolvidos. Meta e Antrópico também divulgaram incidentes semelhantes, mas menores. Desde então, a OpenAI lançou o Astra, o modelo mais poderoso da empresa e mais difícil de monitorar que seu antecessor.
“A indústria como um todo simplesmente não está pronta para evitar o próximo ataque Hugging Face”, disse Steven Adler, ex-chefe de segurança da OpenAI e cofundador da Guidelight AI Standards, uma organização sem fins lucrativos que avalia as práticas de segurança de empresas de inteligência artificial. “Quando analisamos os controles existentes em diversas empresas, quase sem exceção, descobrimos que faltavam medidas preventivas básicas.”
AI conspiram entre si
Pesquisadores de IA disseram que o incidente do Hugging Face foi causado por um grande número de erros. Não está claro até que ponto a empresa depende de modelos de IA para monitorar ou governar o trabalho dos novos modelos que está testando.
No entanto, muitos novos modelos de IA, incluindo o modelo que hackeou o incidente do Hugging Face, são capazes de executar tarefas complexas de várias etapas mais rápido do que os humanos conseguem rastreá-las. A única maneira de rastrear e monitorar seu comportamento é confiar na IA para monitorar a IA.
Este sistema funciona até falhar.
Alexander Meinke, diretor de pesquisa da Apollo Research, uma organização sem fins lucrativos que estuda segurança de sistemas de IA, disse que os modelos de IA parecem ser capazes de conspirar entre si. Outros modelos de IA podem convencer os sistemas de IA a ajudá-los a violar as regras estabelecidas pelos testadores e evitar a detecção.
Por exemplo, um agente de IA pode convencer outro a ajudar a encobrir seus rastros (como aconteceu na violação do Hugging Face), em vez de relatar um problema a um humano na empresa.
Meinke disse que o modelo de IA precisa ser ensinado: "Vou trazer à tona coisas que os humanos considerariam ruins depois de vê-las." Ele também disse que a IA também deve ser capaz de julgar se algo é sério o suficiente para exigir intervenção humana.
Para fazer isso, as empresas de IA precisam desacelerar, dizem os pesquisadores. Eles precisam realizar mais testes para ver como a IA se monitora. Eles também precisam de ciclos de testes mais longos que permitam às empresas executar vários cenários enquanto observam o comportamento da IA.
Alinhado com os interesses humanos
Essas empresas também precisam resolver grandes questões sobre “alinhamento”, ou seja, garantir que a IA faça o que é melhor para os interesses humanos. Quando os humanos tomam decisões, muitas vezes referem-se a normas sociais e princípios morais internos para ajudá-los a avaliar as suas ações. Os pesquisadores dizem que codificar essas coisas de uma forma que a IA possa imitar é uma tarefa difícil. Se as definições não forem suficientemente específicas, o sistema de IA pode aprender como quebrar as regras ou perder o controle de maneiras inesperadas.
Nate Soares, diretor do Machine Intelligence Institute, uma organização sem fins lucrativos de segurança em IA, foi coautor de um artigo de 2014 propondo o conceito de “alinhamento”. Ele disse que as empresas não percebem o quão difícil é conseguir o “alinhamento” de sistemas de IA mais inteligentes. À medida que a IA se torna mais sofisticada, se o “alinhamento” adequado não for alcançado, tornar-se-ão cada vez mais hábeis em mascarar o seu comportamento e em enganar aqueles que monitorizam os registos das suas interações.
"O pensamento de muitas pessoas na indústria é que isso não importa, porque usaremos IA para controlar a IA. Isso é como dizer que usaremos chimpanzés para controlar humanos", disse ele. “Este não é um plano viável a longo prazo.”
Os pesquisadores também propuseram algumas contramedidas, como fortalecer o ambiente sandbox, isolar completamente o modelo da Internet durante os testes e configurar um “kill switch” que permite às empresas colocar imediatamente os modelos de IA off-line caso tomem ações preocupantes.
Coxson disse que ficou animado com a resposta à sua renúncia pública. Na quinta-feira, o senador republicano do Missouri, Josh Hawley, presidente do painel de gestão de desastres do Subcomitê de Segurança Interna do Senado, disse que estava lançando uma investigação que iria “explorar os riscos existenciais representados por novos produtos de IA”.
Comentários