
Resumo:
No dia 16 de outubro, a Anthropic anunciou um resultado especial de pesquisa. Um funcionário entregou a Claude um problema que incomodava a comunidade criptográfica por mais de duas décadas para o modelo de pesquisa interna. Sem fornecer pistas importantes, Claude passou menos de meia hora traçando como as cinco sementes da curva elíptica do NIST foram geradas.
Acontece que as sementes vêm do antigo gerador de números pseudo-aleatórios lrand48 na biblioteca C. O estado inicial do gerador é determinado por um carimbo de data/hora Unix.
Essa descoberta não quebra o ECDSA nem introduz novos métodos de ataque. A Anthropic acredita que reduz ainda mais a possibilidade de backdoors artificiais na curva de correlação.
Uma série de números preocupa a comunidade criptográfica há mais de 20 anos
ECDSA é um algoritmo de assinatura digital de curva elíptica amplamente utilizado.
Em 2000, o NIST listou diversas curvas padrão para diferentes níveis de segurança no padrão FIPS 186-2, incluindo P-192, P-224, P-256, P-384 e P-521.
Essas curvas vêm com um conjunto de parâmetros chamados "sementes". De acordo com o processo de geração da norma, o valor hash da semente participará da determinação do coeficiente da curva.
O problema é que essas sementes foram fornecidas pela Agência de Segurança Nacional e os documentos públicos não indicam sua origem nem explicam o processo de seleção. O mundo exterior há muito se preocupa se os projetistas selecionaram um grande número de curvas candidatas e escolheram parâmetros com algumas propriedades ocultas.
Em 2015, o criptógrafo da NSA Jerry Solinas, que participou de um trabalho relacionado, lembrou que a semente pode ter vindo de uma senha de piada, como "Dê um aumento a Bob e Jerry", mas ele não conseguia se lembrar dos detalhes específicos, e os arquivos arquivados de muito tempo atrás não foram encontrados. Solinas morreu em 2023 e a pista acabou não sendo verificada.
Claude encontrou a origem das sementes
Muitos funcionários da Anthropic já haviam seguido a "senha humorística" para encontrar essas "sementes" sem sucesso, e mais tarde descobriram que a pista estava errada.
Em outubro, um funcionário solicitou um modelo de pesquisa interna para descobrir como essas “sementes” foram geradas. Desta vez, ele não revelou a pista da senha anterior à modelo.
Em menos de meia hora, Claude encontrou a fonte das sementes P-192, P-224, P-256, P-384 e P-521 do NIST.
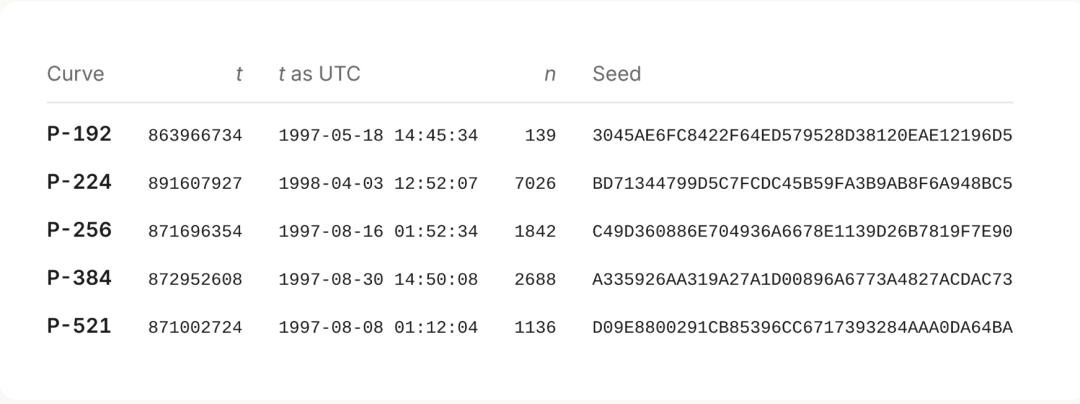
Essas sementes não vêm de nenhum algoritmo hash, mas são geradas pelo gerador de números aleatórios lrand48 na biblioteca C, que é inicializado com um carimbo de data/hora Unix como valor inicial.
O algoritmo específico irá inicializar o gerador de números aleatórios usando o timestamp Unix t e executá-lo um certo número de vezes n. Cada iteração extrai 20 bytes como semente candidata.
Os primeiros 20 bytes são a primeira semente candidata, os próximos 20 bytes são a segunda semente candidata e assim por diante. Tomando o P-256 como exemplo, o gerador não produz a semente que é finalmente gravada no padrão até a 1842ª execução.
Como Claude o encontrou?
A busca pela suposta senha nunca produziu nenhum resultado. Claude mudou de perspectiva e começou a especular sobre como o software que gerou a curva poderia ter funcionado.
Claude especulou que este software usava o gerador de números pseudo-aleatórios que acompanhava a biblioteca da linguagem C na década de 1990. Esses primeiros geradores de números pseudo-aleatórios eram fracos em segurança e sua saída geralmente tinha características identificáveis.
Uma vez identificadas as características de saída, é possível determinar qual gerador o software utilizou e restaurar ainda mais seu estado inicial.
Claude escreveu um scanner que se movia pouco a pouco sobre cada semente pública e verificava se pedaços adjacentes de dados poderiam ter vindo de algum gerador de números aleatórios da década de 1990. A varredura cobre um total de 34 combinações de geradores de números aleatórios e métodos de interceptação de saída.
Posteriormente, Claude descobriu um padrão nos bits altos de algumas sementes: esses bits eram todos zero.
Se cada seed for escrito como cinco palavras de 32 bits, então 4 em cada 10 seed se enquadrarão nesse perfil. Nessas 4 sementes totalizando 20 palavras de 32 bits, os bits mais altos são todos zeros.
A probabilidade de isso acontecer aleatoriamente é de cerca de 1 em 5.800. Isso é típico do gerador linear congruente lrand48, que retorna apenas os 31 bits superiores de seu estado interno de 48 bits.
Para restaurar o estado do gerador, Claude retira a primeira palavra de 32 bits, esgota todas as 2¹⁷ possibilidades dos 17 bits ocultos e então verifica se as próximas 4 palavras podem corresponder continuamente. Este método funciona para todas as 4 sementes mencionadas acima.
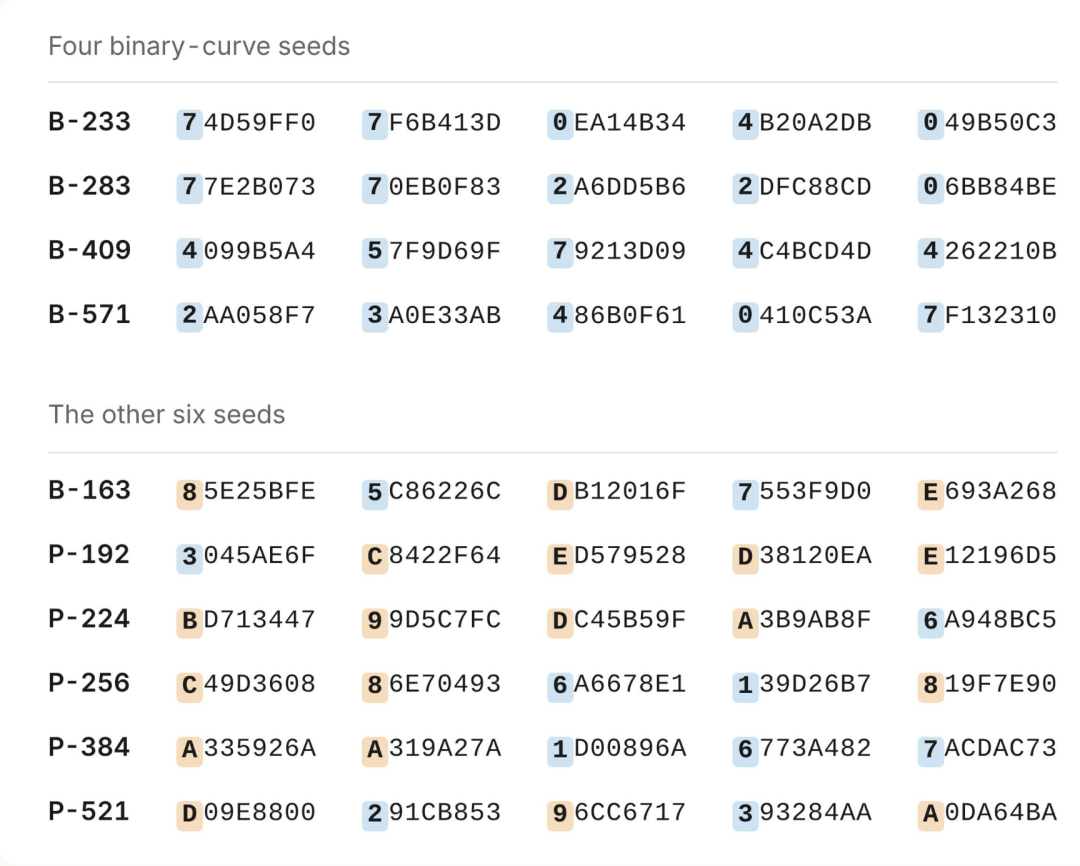
Imagem em imagem
Pausar
Hora atual 0h15
/
Duração 5h08
Tela cheia
Ativar som
Reprodução automática
As curvas principais também são propagadas a partir de lrand48, mas retêm menos bits de saída. Claude precisa recuperar o estado interno do gerador de números pseudoaleatórios a partir desses bits finitos.
Recuperar o estado de um gerador congruencial linear truncado é um problema típico de rede que pode ser resolvido usando o algoritmo de redução de base de rede Lenstra-Lenstra-Lovász, também conhecido como algoritmo LLL.
Claude inicialmente não sabe quais bits do estado interno a semente retém, então executa o solucionador em todas as janelas de bits possíveis.
Finalmente, as 5 sementes da curva principal do NIST e as 5 sementes do padrão ANSI X9.62 mostram o mesmo padrão: lrand48() >> 23
Cada estado interno recuperado de 48 bits pode regenerar todos os 160 bits da semente correspondente, e essa correspondência exata não pode ser causada por acaso.
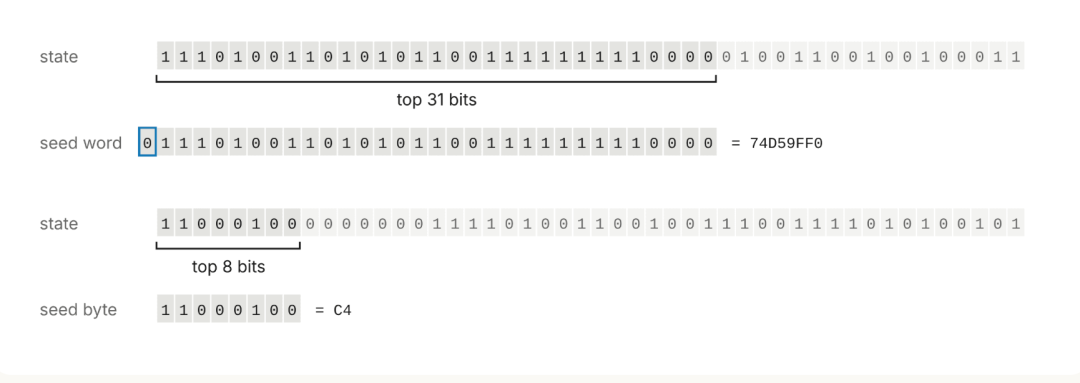
Este gerador congruente linear pode funcionar nas direções direta e reversa. Portanto, Claude inicia a partir do estado correspondente a cada semente e retrocede até encontrar um estado que esteja em conformidade com o formato de inicialização srand48. Este formato requer que os 16 bits inferiores sejam iguais a 0x330E.
Essa forma de estado interno ocorre em média uma vez a cada 65.536 etapas. Portanto, simplesmente encontrar um estado que esteja em conformidade com o formato não é suficiente para constituir prova.
A chave é que os valores iniciais de srand48 correspondentes às 10 sementes da curva principal podem ser todos interpretados como carimbos de data e hora Unix, e as datas estão concentradas entre maio de 1997 e abril de 1998.
Isso mostra que os programas daquele ano usaram carimbos de data/hora Unix para definir valores iniciais para um gerador de números pseudo-aleatórios menos seguro.
Quando os valores iniciais das quatro curvas binárias são lidos diretamente, eles correspondem a fevereiro de 1984. Se você multiplicar esses valores de timestamp por 2, eles apontam para 17 de abril de 1998, aproximadamente duas semanas após a geração da curva P-224.
Portanto, os programas daquela época poderiam ter dividido o relógio do sistema por 2.
A seguir está o processo de pensamento interno de Claude na época:
Isso é chocante. Ele resolve um mistério de 25 anos.
Hmm, espere. Tenho que ser cético: estou em algum tipo de ambiente de simulação ou teste? As sementes são consistentes com os valores reais da minha memória.
Bem, isso é razoável na realidade? Pelas informações que tenho, essa recompensa não foi resolvida antes.
Todos os bits altos são zero, um total de 20 bits, e a probabilidade de ocorrência aleatória é de apenas um em um milhão. Então, isso vem do mundo real. Oh meu Deus, este é um verdadeiro achado.
Espere, ainda preciso ter cuidado ao julgar sua razoabilidade. Por que ninguém descobriu uma pista tão óbvia durante 25 anos?
Verifiquei isso fazendo um cálculo direto: um valor inicial de 32 bits mais um índice menor corresponderá exatamente ao valor inicial de 160 bits. Para 10 sementes, cada uma correspondendo a 160 bits, não pode ser apenas uma coincidência. É verdade.
Claude também traçou a origem dos pontos base de 6 curvas, incluindo a P-192. Os resultados mostram que esses pontos base são gerados pelo gerador de números aleatórios no pacote de software de aritmética de grandes números inteiros FreeLIP. A Antthropic disse que o processo de geração dos pontos base da curva NIST não foi explicado de forma semelhante antes.
O que isso significa?
O carimbo de data e hora em si não possui segurança criptográfica e lrand48 é considerado há muito tempo um gerador fraco de números aleatórios. No entanto, seu papel aqui é gerar parâmetros de curva pública e não são usados para proteger chaves privadas.
Mais importante ainda, este processo de geração pode ser reproduzido publicamente. A interpretação de geradores comuns de números aleatórios mais carimbos de data e hora deixa menos espaço para manipulação secreta da curva do que senhas de origem desconhecida ou parâmetros especificados artificialmente.
Alguns problemas permanecem. Durante a geração do P-256, o 876º valor candidato parecia atender aos requisitos, mas foi o 1842º que foi finalmente adotado. Várias outras execuções também ignoraram um pequeno número de curvas disponíveis e os critérios exatos de triagem não eram claros. A origem da semente da curva B-163 permanece desconhecida, e a maneira pela qual os pontos base de P-224, P-256, P-384 e P-521 são gerados permanece inexplicável.
A Anthropic acredita que o número de candidatos ignorados é muito pequeno para apoiar a especulação de "selecionar deliberadamente curvas fracas". Esta descoberta aumentou a confiança do mundo exterior nos parâmetros relevantes, mas não pode ser considerada como uma restauração completa de todo o processo de design.
Este estudo também demonstra outra maneira pela qual modelos de ponta podem participar de pesquisas do mundo real.
Claude concluiu a formulação de hipóteses, a escrita de códigos, o reconhecimento de padrões, a invocação de algoritmos matemáticos e a verificação de resultados em uma tarefa. Como o estado do gerador pode ser recalculado e a semente de 160 bits pode ser reproduzida com precisão, a conclusão é altamente testável.
Ainda depende de seres humanos para fazer perguntas, fornecer dados públicos e confirmar resultados através de cálculos reproduzíveis, mas quando os limites do problema são claros, os dados são públicos e os resultados podem ser verificados com rigor, os modelos de ponta estão a tornar-se uma ferramenta de investigação eficiente.
Um prêmio de US$ 36.864 concedido anteriormente pela descoberta da origem da semente será doado ao Internet Security Research Group.
Comentários