Resumo:
O desenvolvedor Linux Osama Arif enviou dois patches para a lista de discussão do kernel com o objetivo de reduzir a contenção de solicitações quando o zswap carrega páginas de troca. Zswap é o mecanismo de cache de compactação do Linux. Ele compacta as páginas a serem trocadas e as armazena temporariamente na memória. Se as páginas puderem ser lidas a partir do cache de compactação, o acesso ao dispositivo de troca poderá ser reduzido, o que é especialmente útil para aliviar a pressão de E/S do disco quando a memória estiver limitada.
O problema é que o código existente faz com que gravações compactadas e leituras compactadas compartilhem solicitações de compactação assíncronas por CPU e bloqueios mutex. Se uma tarefa de gravação de baixa prioridade for interrompida durante o período de bloqueio, uma tarefa de leitura de alta prioridade também poderá ser forçada a esperar. O primeiro patch define solicitações, objetos de espera e bloqueios mutex para compactação e descompactação, respectivamente, para que a leitura não seja mais bloqueada por tarefas de gravação; o segundo patch permite que o algoritmo de compactação de software síncrono use solicitações na pilha para contornar ainda mais o bloqueio zswap. Algoritmos que exigem processamento assíncrono ou contexto de solicitação adicional ainda usam solicitações por CPU e bloqueios mutex.
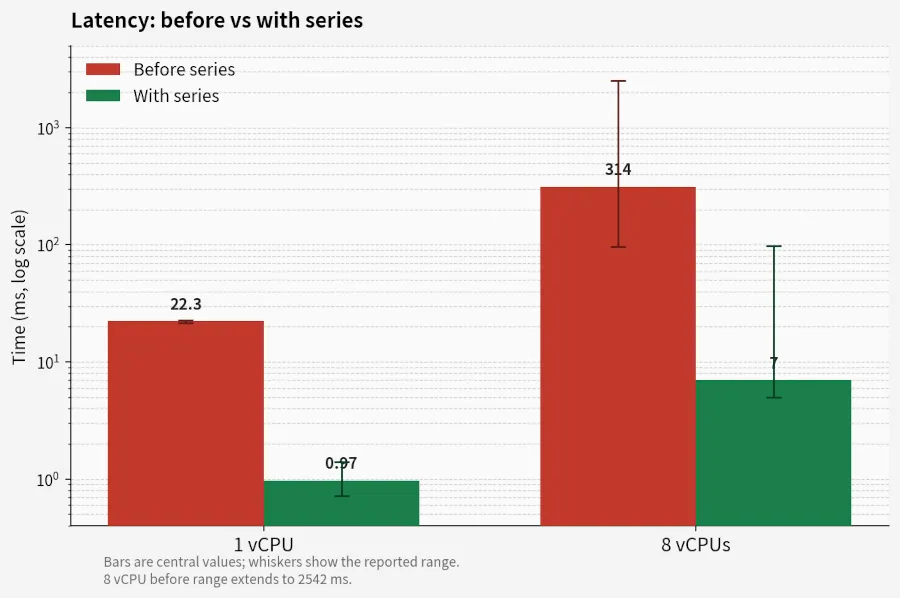
Testes de benchmark publicados pelo autor do patch mostram que em um único ambiente de CPU virtual, a latência média de leitura mais lenta por rodada caiu de 22,3 milissegundos para 0,97 milissegundos; em um ambiente de 8 CPUs virtuais, caiu de 314 milissegundos para 7 milissegundos. Cada teste foi executado por 5 rodadas, usando compressor zstd, máquina virtual e disco de memória como dispositivos de comutação e criando carga por meio de diferentes tarefas prioritárias; o número de leituras superiores a 10 milissegundos também foi reduzido de 26 para 35 vezes por rodada em um único núcleo para zero, e em um ambiente multi-core foi reduzido de 3 para 18 vezes por rodada para no máximo uma vez. Os autores afirmam que benchmarks e programas de teste são escritos com a ajuda de grandes modelos de linguagem.
Esses números refletem melhorias na latência de leitura em testes de estresse específicos e não significam que todos os dispositivos Linux ou cargas de trabalho diárias terão a mesma aceleração geral.
O patch ainda está no estágio de revisão da lista de discussão do kernel e ainda não foi incorporado ao kernel principal:
https://lore.kernel.org/lkml/
[email protegido]
/
Comentários