Resumo:
Um engenheiro do Google DeepMind demonstrou recentemente um experimento criativo: ele executou com sucesso o modelo de linguagem pequena Gemma 3 270M do Google diretamente em uma impressora a laser comum de escritório. O número de parâmetros deste modelo é de cerca de 270 milhões, e a impressora utilizada no experimento possui apenas 14,1 MB de memória disponível, mas ainda atinge uma velocidade de geração de mais de 60 palavras por segundo.
O resultado foi anunciado pelo engenheiro Omar Sanseviero na plataforma social X. Ele disse que com a ajuda do projeto Carbon executou o modelo Gemma diretamente na impressora do escritório. Todo o experimento não modificou o firmware da impressora, nem utilizou placa de computação externa ou outro hardware. Em vez disso, baseou-se inteiramente na linguagem de descrição de página PostScript incorporada nas impressoras a laser modernas.
PostScript é uma linguagem Turing-completa de descrição de página comumente usada para controlar como as impressoras apresentam texto, gráficos e layout de página. A equipe experimental usou Carbon, um mecanismo de inferência leve do Transformer, e o combinou com o modelo quantizado Gemma 3 270M para finalmente gerar um arquivo de impressão PostScript original. Quando a impressora executa o arquivo, ela completa o cálculo de inferência do modelo de linguagem dentro de seu interpretador PostScript.
Para evitar ficar sem memória da impressora durante a inferência do modelo, o experimento adotou a tecnologia de carregamento de fluxo laminar dinâmico. O sistema carrega constantemente diferentes camadas do modelo dentro e fora da memória, mantendo o pico de uso de memória em apenas 14,1 MB, enquanto a impressora aloca 244,6 MB de memória virtual PostScript. Mesmo assim, a Gemma 3 270M ainda atingiu uma velocidade de geração de 61,3 tokens/s na CPU da impressora.
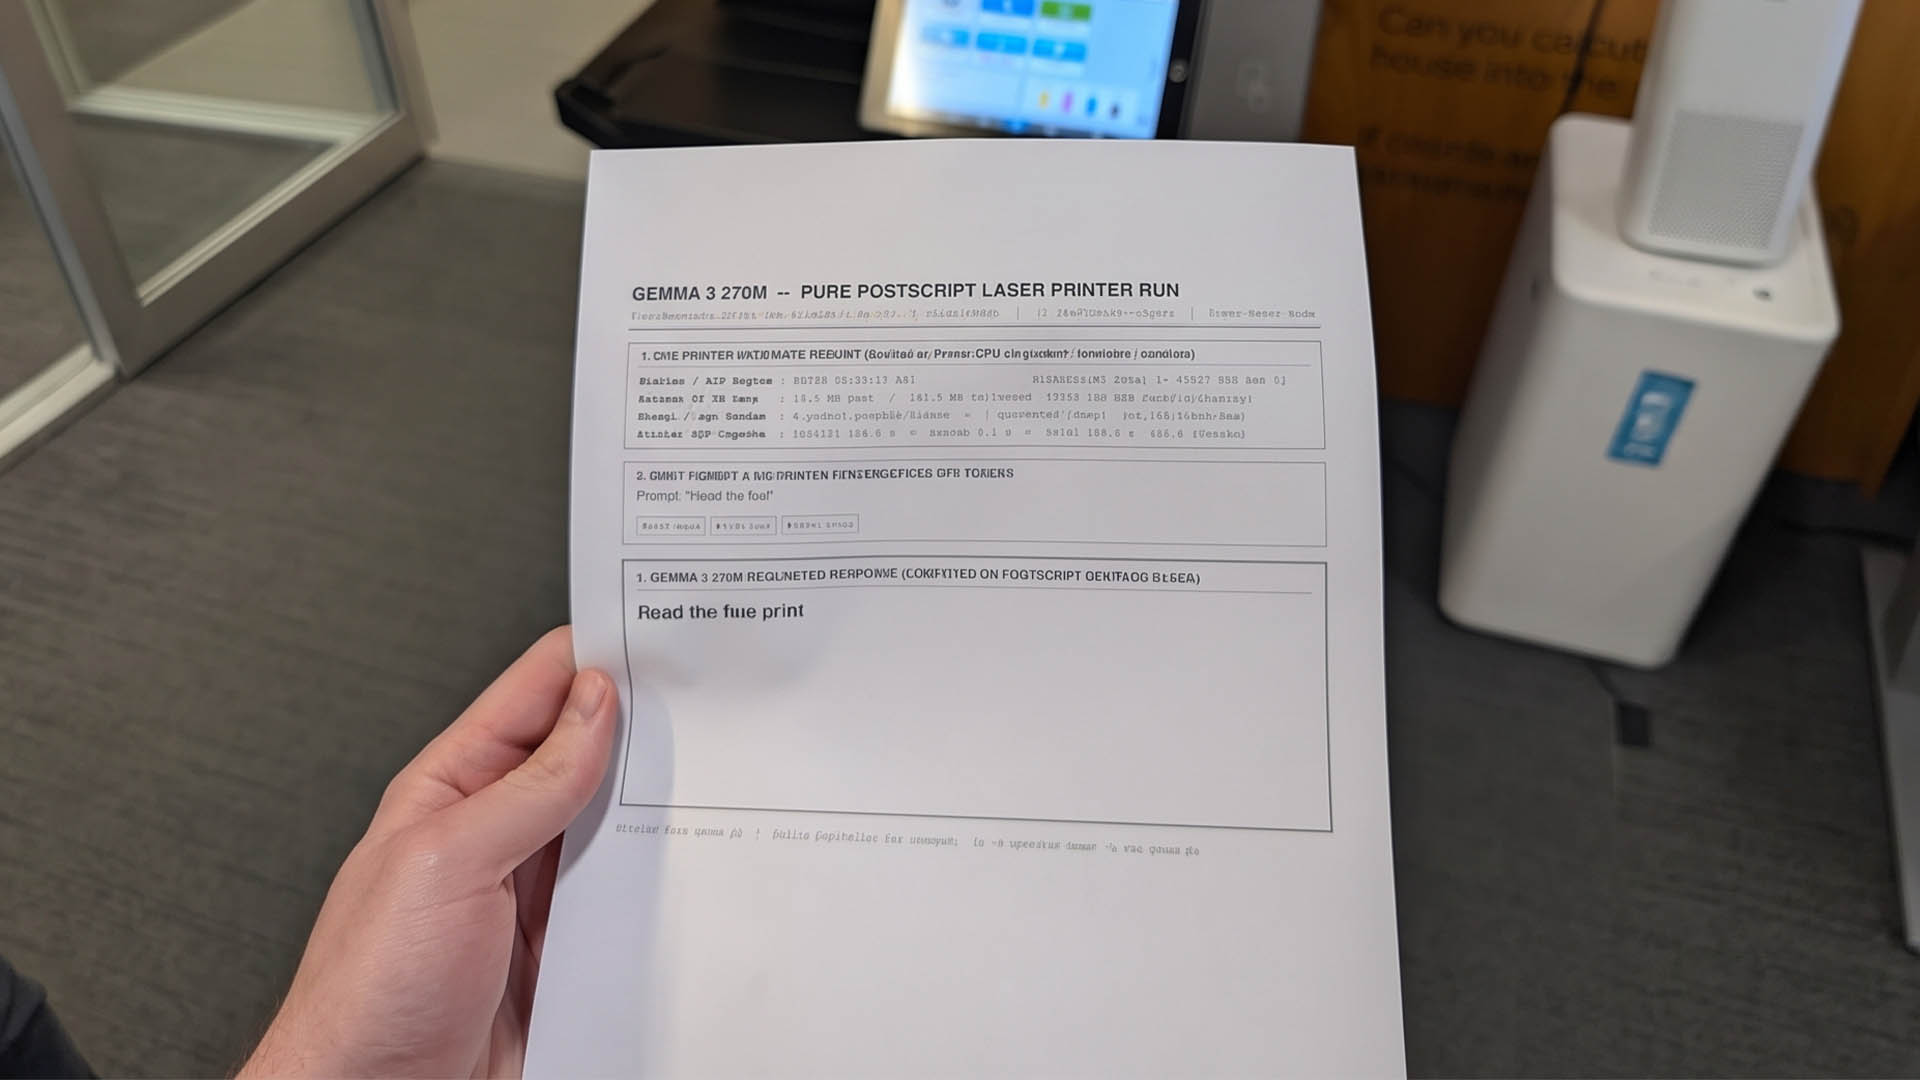
De acordo com as informações de hardware capturadas no experimento, esta impressora Ricoh executa nativamente cálculos de Transformer de 18 camadas no interpretador PostScript Nível 3. Quando o prompt "Leia a multa" contendo apenas quatro tokens é inserido, a etapa de pré-preenchimento leva 184 segundos, enquanto o tempo de decodificação para gerar um único token é de apenas 0,1 segundos e todo o processo de processamento totaliza 184 segundos.
Após a conclusão do cálculo, a impressora finalmente imprime a resposta de três palavras "Leia as letras miúdas" diretamente no papel. Este resultado não só prova que o modelo realmente completa o raciocínio dentro da impressora, mas também mostra que o potencial do equipamento de escritório diário no nível do software está muito além das expectativas das pessoas. Embora esse modo de operação não seja adequado para ambientes de produção reais, ele demonstra os limites do que é possível ao combinar pequenos modelos quantitativos, mecanismos de inferência e recursos de hardware existentes.
Comentários