
Resumo:
Para usuários do Windows que desejam executar modelos de inteligência artificial em seus próprios computadores, sempre houve um certo limite para instalação e configuração de ferramentas locais de IA. Os usuários não só precisam encontrar arquivos de modelo adequados, mas também considerar questões como formato do modelo, compatibilidade de hardware, instalação do mecanismo de inferência e parâmetros de inicialização. Hoje, o aplicativo de código aberto Llama for Windows, lançado por desenvolvedores relacionados às equipes Hugging Face e llama.cpp, tenta simplificar esse processo em algumas operações simples, permitindo que os usuários baixem e executem modelos locais de linguagem grande em computadores Windows sem usar a linha de comando.
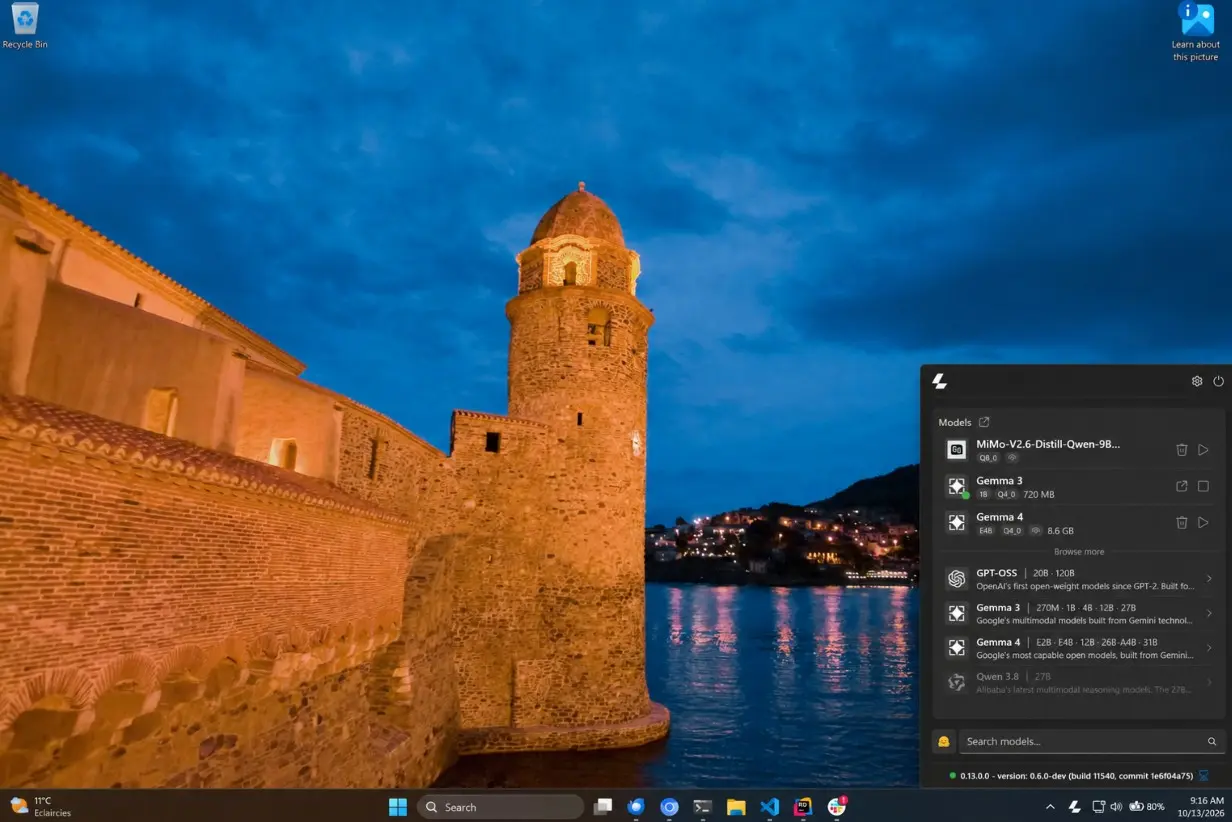
O Llama para Windows será lançado em outubro de 2026 e é a versão para Windows da versão macOS do aplicativo Llama. É um aplicativo Windows 11 gratuito e de código aberto desenvolvido com base na tecnologia WinUI 3 da Microsoft e é executado principalmente na área de notificação do sistema. Após a instalação, os usuários podem abrir o painel de controle através do ícone do aplicativo na área de notificação da barra de tarefas, sem a necessidade de manter uma janela independente como os softwares tradicionais.
O recurso mais importante deste aplicativo é a capacidade de se conectar diretamente ao armazém do modelo Hugging Face. Hugging Face é atualmente uma importante plataforma de hospedagem de modelos de inteligência artificial de código aberto, reunindo um grande número de modelos e suas versões derivadas de diferentes equipes de desenvolvimento. No passado, os usuários geralmente tinham que encontrar sozinhos um arquivo de modelo adequado, determinar se o formato do arquivo estava correto e, em seguida, baixar a versão correspondente e iniciá-la por meio do mecanismo de inferência. Para o usuário médio que não está familiarizado com a tecnologia de inteligência artificial, esse processo pode ser bastante tedioso.
Llama para Windows fornece uma lista de modelos recomendados dentro do aplicativo. Os usuários podem verificar o tamanho dos parâmetros do modelo, o espaço em disco e se ele suporta funções visuais, como compreensão de imagem, e então selecionar um modelo adequado para download em seu computador. Após selecionar o modelo, basta clicar na opção correspondente e o aplicativo iniciará automaticamente o download e exibirá o andamento do download.
Esta ferramenta utiliza principalmente modelos de quantização no formato GGUF. GGUF é impulsionado pelo ecossistema llama.cpp e se tornou um dos formatos de arquivo de modelo amplamente usados para executar localmente modelos de linguagem grande de código aberto. A tecnologia de quantificação pode reduzir o espaço de armazenamento e a memória operacional exigidos pelo modelo, reduzindo a precisão numérica dos parâmetros do modelo, dando aos modelos que originalmente exigem configurações de hardware mais altas a oportunidade de serem executados em computadores pessoais comuns. No entanto, a quantização geralmente também traz um certo grau de perda de precisão, e o impacto específico depende do modelo, do método de quantização e do cenário de uso.
Em termos de gerenciamento de modelos, o Llama para Windows listará os modelos que foram baixados para o computador. Os usuários podem carregar ou descarregar diretamente os modelos e conversar com os modelos por meio da interface web integrada. O aplicativo também exibe o status atual de execução do modelo, permitindo aos usuários saber se o modelo foi iniciado sem a necessidade de verificar manualmente o processo em segundo plano.
O mecanismo de inferência subjacente também pode ser tratado automaticamente pelo aplicativo. Llama para Windows usa llama.cpp como o principal componente de execução. Se já existir um serviço llama.cpp utilizável no sistema, o aplicativo poderá se conectar ao serviço existente; se não estiver instalado, pode ser instalado através do instalador oficial. Todo o processo não requer direitos de administrador e os usuários não precisam compilar o código-fonte ou configurar manualmente parâmetros de inicialização complexos.
Esse design reduz a barreira de entrada para IA local, mas não significa que todos os modelos possam funcionar perfeitamente em qualquer computador. O desempenho real do modelo ainda depende do processador, memória, placa gráfica, capacidade de memória de vídeo e tamanho do próprio modelo. Modelos com tamanhos de parâmetros menores são geralmente mais fáceis de executar em um computador normal, enquanto modelos maiores podem exigir muita memória ou até mesmo uma estação de trabalho com placa gráfica de alto desempenho para obter bons tempos de resposta.
O Llama para Windows também oferece uma interface de bate-papo semelhante a um iniciador rápido no nível do sistema. Os usuários podem pressionar a tecla de atalho Alt+Espaço em outros aplicativos para abrir a janela flutuante de bate-papo e interagir diretamente com o modelo atualmente carregado. A janela adota um design leve, e a conversa não será fechada imediatamente após ser ocultada, podendo continuar a ser utilizada quando chamada novamente. Isso significa que os usuários não precisam mudar repetidamente para aplicativos de IA independentes ao escrever documentos, navegar na web ou escrever código.
Além da função de chat para usuários comuns, o software também leva em consideração as necessidades dos desenvolvedores. O aplicativo pode iniciar um servidor local baseado em llama.cpp na máquina local e fornecer serviços de modelo por meio de uma API compatível com a interface OpenAI. O endereço de serviço padrão é
http://localhost:9931. Os desenvolvedores podem fazer com que seus scripts, aplicativos ou agentes de IA chamem modelos locais sem precisar enviar todas as solicitações para serviços de nuvem remotos.
Como a interface é compatível com a API OpenAI, algumas ferramentas originalmente desenvolvidas para a interface OpenAI podem ter a oportunidade de acessar modelos executados localmente simplesmente ajustando o endereço do serviço e as configurações relacionadas. No entanto, a compatibilidade da interface não significa que todas as funções sejam completamente consistentes. Se ele pode ser usado ainda depende dos recursos da API exigidos pelo cliente e se o modelo carregado suporta as funções correspondentes.
Isso também torna o Llama for Windows não apenas uma ferramenta de bate-papo local, mas também uma plataforma de execução de IA em computadores pessoais. O mesmo arquivo de modelo pode ser compartilhado por vários aplicativos e os desenvolvedores não precisam baixar um modelo separado para cada programa, reduzindo assim a ocupação repetida de espaço em disco. Esta arquitetura tem certo valor prático para usuários que desejam construir assistentes de programação, ferramentas de análise de documentos ou outras aplicações de IA localmente.
Em termos de privacidade, a principal vantagem de executar modelos localmente é que o processo de inferência não depende de serviços remotos de IA. De acordo com a descrição do projeto, as palavras de prompt inseridas pelo usuário e a inferência do modelo são feitas nativamente, e o aplicativo não coleta telemetria, analisa eventos ou gera identificadores de instalação especializados. No entanto, os usuários ainda precisam se conectar à Internet para baixar arquivos de modelos e obter atualizações de software. A descrição do projeto também menciona que essas solicitações de rede carregarão uma identificação padrão do User-Agent que contém informações como versão do software, versão do Windows e arquitetura do processador. Portanto, a chamada operação local não significa que todo o processo de instalação e manutenção não exija nenhuma rede, mas significa que a inferência do modelo e o processamento imediato de texto podem permanecer localmente.
A compatibilidade de hardware também é o foco deste aplicativo. Llama para Windows oferece suporte às plataformas x64 e ARM64 do Windows 11 e fornece suporte nativo para dispositivos Windows em Arm. Isto é especialmente importante para notebooks Windows equipados com processadores Arm, porque algumas ferramentas locais de IA foram desenvolvidas principalmente para computadores x86 tradicionais no passado e podem precisar depender de simulação executada em dispositivos Arm ou não ter componentes pré-compilados correspondentes.
O projeto também mencionou suporte para a plataforma NVIDIA RTX Spark. A plataforma é voltada para aplicativos locais de computação de IA e pode fornecer outra opção de hardware para usuários que desejam executar modelos maiores em um ambiente de desktop. No entanto, o software que suporta uma determinada plataforma não significa que todos os modelos possam atingir o desempenho ideal. Os resultados operacionais específicos ainda dependem do tamanho do modelo, capacidade de memória e configuração de inferência.
O Llama para Windows pode ser obtido no site oficial do Llama ou você pode baixar o pacote de instalação correspondente na página de lançamento do projeto no GitHub. Depois de instalado, os usuários podem abrir o aplicativo, selecionar um modelo, aguardar a conclusão do download e começar a usá-lo por meio de uma janela de bate-papo flutuante ou interface da web. Deve-se observar que o aplicativo é atualmente para Windows 11 e não lista o Windows 10 como plataforma compatível.
Em geral, o Llama para Windows não reinventa a tecnologia de execução de modelos locais de grandes linguagens, mas integra as etapas originalmente espalhadas em armazéns de modelos, mecanismos de inferência e ferramentas de linha de comando em uma interface leve. Seu maior valor está em reduzir o limite de uso e, ao mesmo tempo, manter recursos de escalabilidade, como APIs locais e fluxos de trabalho de desenvolvedores.
À medida que o modelo de código aberto continua a se desenvolver, a execução de IA localmente está gradualmente se transformando de um projeto aleatório que requer certa experiência técnica para um cenário de aplicação que usuários comuns de computador podem experimentar. Se o Llama para Windows pode se tornar uma ferramenta convencional depende de sua estabilidade, gama de suporte de modelo e experiência real de execução, mas pelo menos torna isso mais fácil para os usuários do Windows: eles podem começar a explorar a execução de modelos de IA em seus próprios computadores sem ter que aprender primeiro operações complexas de linha de comando.
Endereço de download:
https://llama.app/download/windows
https://github.com/ggml-org/Llama-Windows
Comentários