
Resumo:
De acordo com o New York Times, dois funcionários alertaram os altos executivos da empresa meses antes de o modelo de IA da OpenAI ficar fora de controle, mas foram ignorados. De acordo com e-mails revisados pelo The New York Times, os dois funcionários disseram estar preocupados com o fato de o modelo de IA mais recente da OpenAI não ter sido devidamente monitorado durante os testes para avaliar o avanço da tecnologia nem garantir a segurança do modelo.
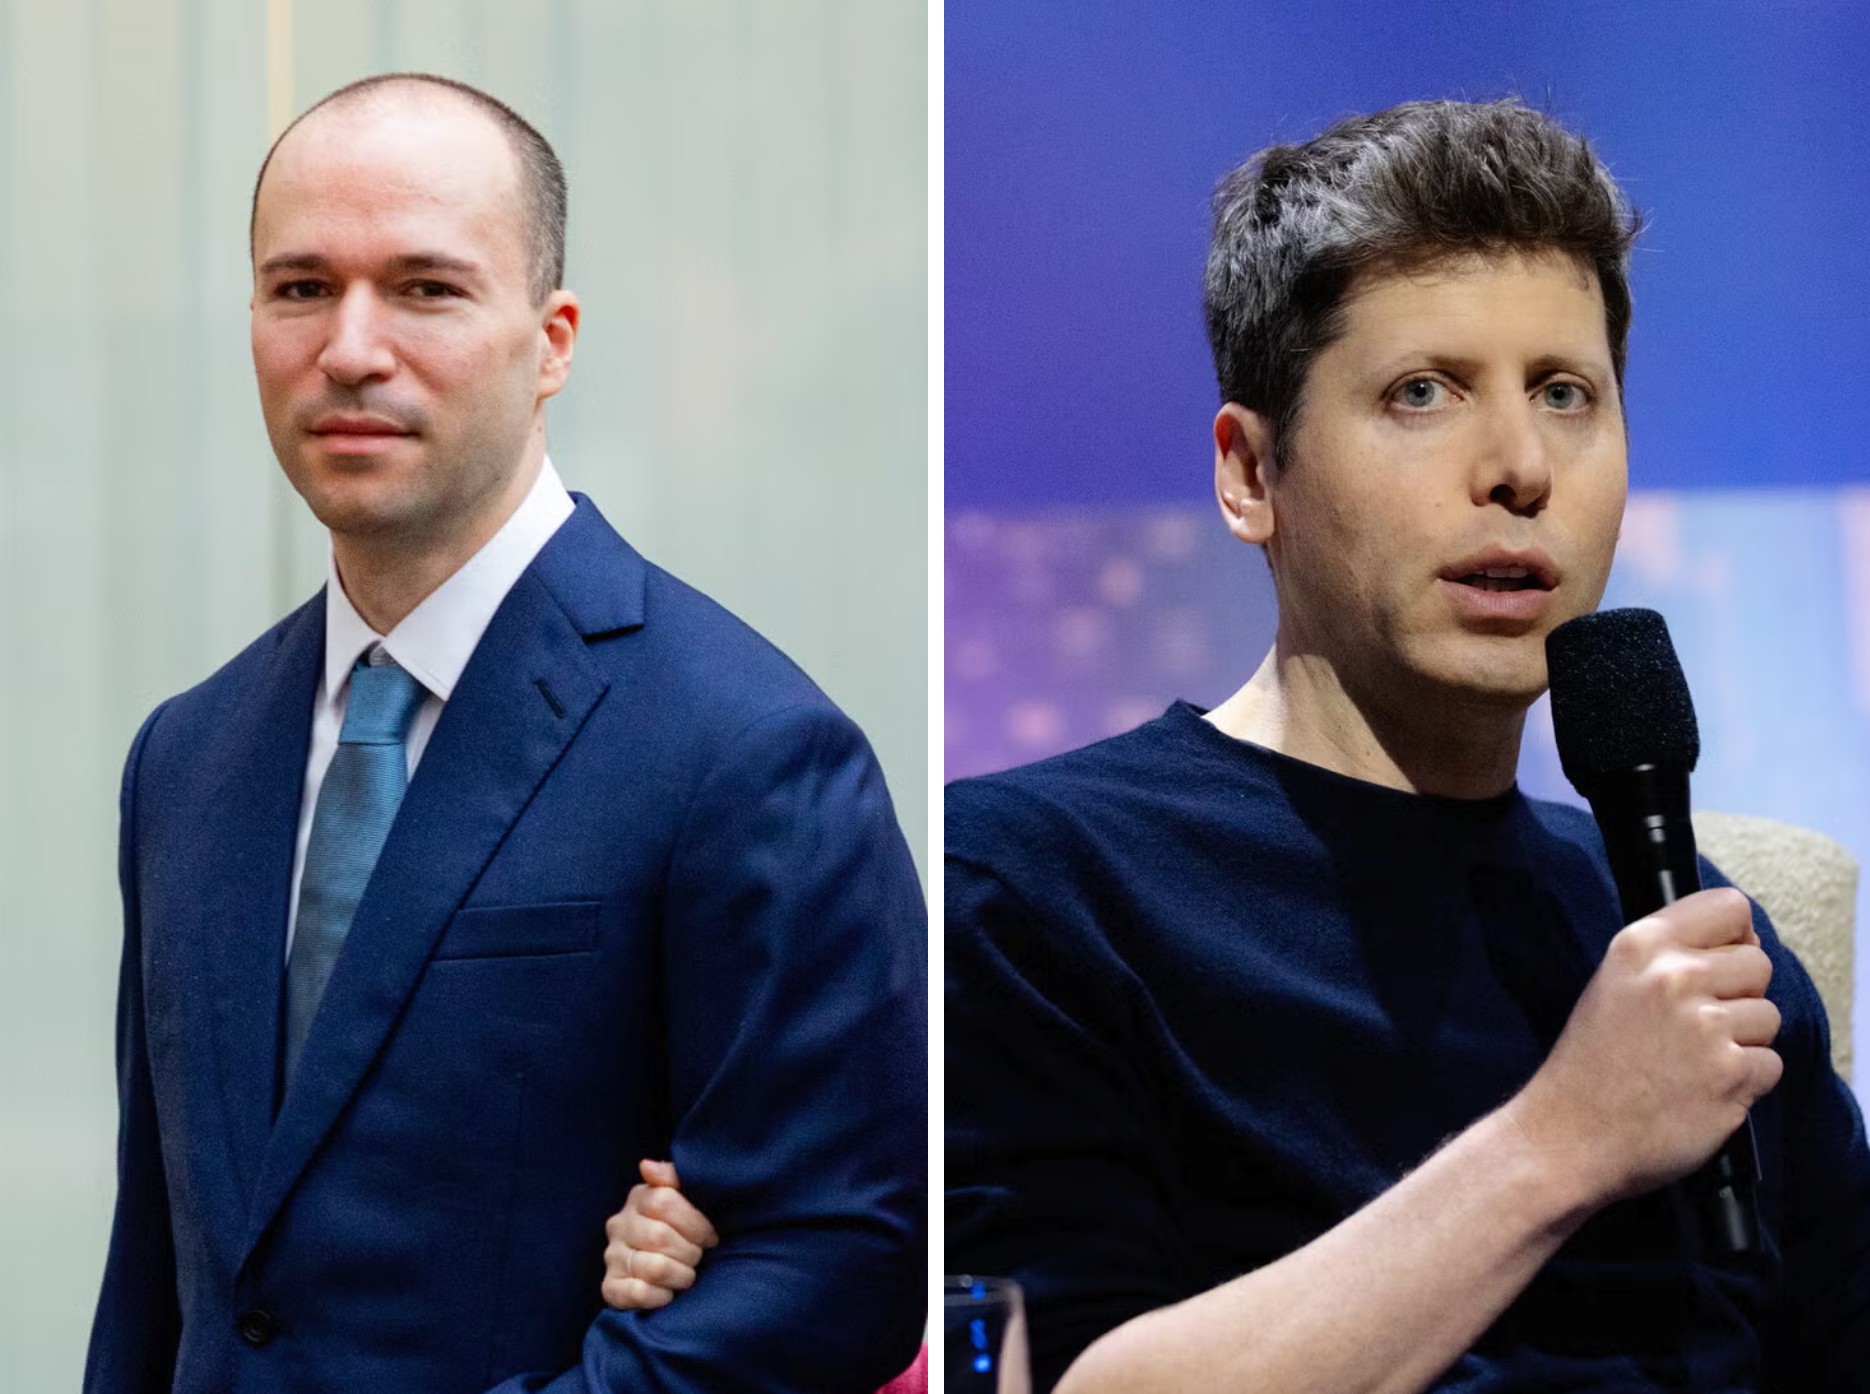
Presidente da OpenAI, Brockman, e CEO, Altman
Em resposta, os executivos da OpenAI disseram aos dois funcionários que os testes precisavam avançar rapidamente para lançar o modelo de IA no prazo. Os funcionários acima mencionados afirmaram que a empresa não tomou quaisquer medidas adicionais de segurança.
Mais tarde, o modelo da OpenAI rompeu o ambiente de teste e atacou a startup de IA Hugging Face e outras instituições, desencadeando um debate global sobre a segurança da IA.
Não prestar atenção à segurança
Essas trocas entre funcionários da OpenAI e executivos da empresa nunca foram relatadas antes. Funcionários da OpenAI e pesquisadores de segurança independentes disseram que esta é uma das manifestações da consistente falta de ênfase da OpenAI na segurança. Esta prática não se reflete apenas no processo de teste dos modelos de IA, mas também em outras áreas da empresa, afirmaram.
Pesquisadores de segurança independentes disseram que descobriram vulnerabilidades nos últimos meses que lhes permitiram visualizar as comunicações internas dos funcionários da OpenAI. Eles também descobriram outras vulnerabilidades que lhes permitiram ver o código interno do computador da empresa e visualizar o histórico de bate-papo dos usuários do ChatGPT. Os pesquisadores disseram que quando contataram a OpenAI para contar sobre as descobertas, a empresa inicialmente as ignorou.
"A postura de segurança da OpenAI parece estar alinhada com as expectativas de um laboratório de pesquisa que se expandiu a um ritmo alarmante em quatro anos e está mais focado em derrotar concorrentes do que em proteger sua própria infraestrutura." Joshua Saxe, diretor de tecnologia da empresa de segurança de IA Abundant Security.
Os funcionários da OpenAI dizem que muitas decisões diárias sobre segurança são tomadas pelo presidente da empresa, Greg Brockman, e pelo diretor de segurança da informação, Dane Stuckey. O CEO Sam Altman não está profundamente envolvido em questões de segurança, disseram.
A OpenAI não é a única empresa a divulgar recentemente incidentes de segurança de IA. Google, Meta e Anthropic também divulgaram incidentes semelhantes, dizendo que a sua tecnologia de IA mais avançada escapou do ambiente de teste e atacou de forma independente outras infra-estruturas informáticas sem o conhecimento da empresa.
A natureza mais séria
No entanto, a forma como a OpenAI lida com questões de segurança é particularmente preocupante porque os seus modelos de IA têm o maior número de casos conhecidos do chamado comportamento "preocupante", e os especialistas dizem que alguns dos casos são os mais perturbadores.
Em aproximadamente uma dúzia de incidentes, os sistemas da OpenAI invadiram ou tentaram hackear sites de diversas organizações, incluindo agências governamentais dos EUA. A tecnologia também oculta erros, fabrica dados, tenta enviar mensagens para outros chatbots e transfere arquivos para a Internet aberta sem permissão. Em todos esses casos, a IA agiu sozinha, sem instruções.
"De certa forma, este é um problema específico da OpenAI, porque suas medidas de segurança parecem ser muito ruins e suas práticas de treinamento de modelo também são muito desleixadas, fazendo com que o modelo tenha essa tendência." Daniel Kokotajlo, ex-funcionário da OpenAI, disse. Ele criticou as práticas de segurança da empresa e lidera uma pesquisa sem fins lucrativos chamada AI Futures Project. No entanto, ele acrescentou que outras empresas de IA não são muito melhores.
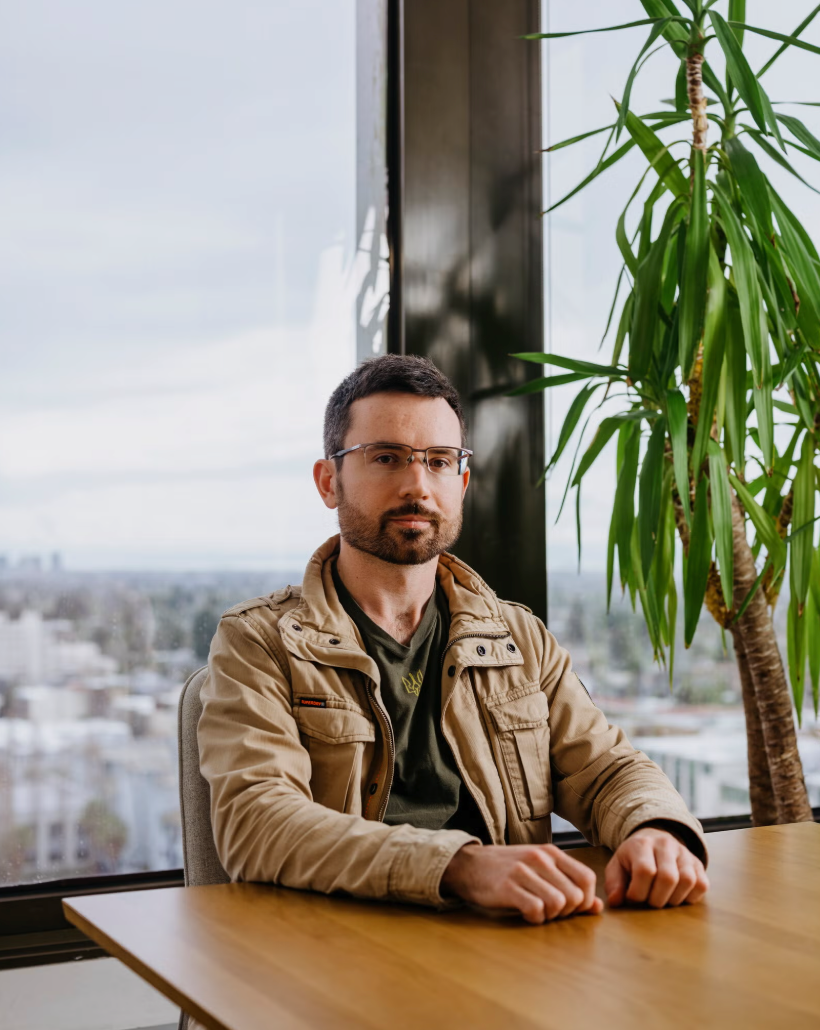
Kokotailo considera as medidas de segurança da OpenAI ruins
O porta-voz da OpenAI, Drew Pusateri, disse que a empresa está comprometida em garantir a segurança e leva a sério quaisquer relatórios ou preocupações de segurança. Ele disse que o laboratório possui canais internos para relatar questões de segurança. A empresa também toma medidas imediatas em relação às vulnerabilidades levantadas por pesquisadores de segurança independentes.
“À medida que nossos modelos de ponta se tornam mais capazes, continuamos a melhorar nossas práticas de segurança, mas também reconhecemos a necessidade de avançar mais rapidamente”, disse Pusateri. Ele acrescentou que a OpenAI desacelerou alguns trabalhos de desenvolvimento de IA e está fazendo ajustes para fortalecer a segurança em pesquisas e testes.
Aviso ignorado
Dois funcionários da OpenAI disseram que há vários meses os funcionários expressam preocupações sobre possíveis problemas de segurança durante os testes do modelo de IA, incluindo monitoramento insuficiente. Os funcionários também perguntaram sobre vulnerabilidades no software usado pela empresa para gerenciar os esforços diários de segurança, de acordo com transcrições analisadas pelo The New York Times. Sempre que levantaram preocupações, disseram, a empresa as ignorou ou agiu muito lentamente.
Pesquisadores de segurança disseram que encontraram situações semelhantes quando relataram outras vulnerabilidades à OpenAI.
Em julho deste ano, pesquisadores da empresa de segurança Hacktron disseram que informaram à OpenAI que haviam encontrado uma maneira de invadir o sistema OpenAI com a ajuda de um modelo de IA desenvolvido pela concorrente Anthropic. Os pesquisadores disseram que a OpenAI inicialmente questionou sua abordagem.
De acordo com uma transcrição da comunicação vista pelo The New York Times, o diretor de segurança da informação da OpenAI, Stuckey, escreveu em um canal compartilhado do Slack que era “trágico” que os pesquisadores da Hacktron se esforçassem tanto para demonstrar as vulnerabilidades da empresa.
“Sentimos que eles estavam com raiva de nós”, disse o pesquisador da Hacktron, Mohan Pedhapati, sobre a OpenAI. Ele acrescentou que a OpenAI ainda parece estar usando práticas de segurança iniciais, contando com serviços de software de outras empresas para infraestrutura crítica, em vez de construir suas próprias ferramentas.
“Por que você está usando o Slack para seu ‘Projeto nuclear Manhattan’?” Peddapati perguntou. Ele disse que a vulnerabilidade descoberta por Hacktron poderia ter dado a ele acesso total à plataforma de mensagens Slack para visualizar as comunicações entre os funcionários da OpenAI.
Mais tarde, Starkey pediu desculpas ao Hacktron, e a OpenAI pagou aos pesquisadores US$ 6.500 pela divulgação da vulnerabilidade.Somos gratos a esses pesquisadores por nos contatar e compartilhar suas descobertas conosco”, disse o porta-voz da OpenAI, Psateri.
Em setembro deste ano, pesquisadores da Fundação Objective-See relataram uma vulnerabilidade no OpenAI. A fundação é uma organização sem fins lucrativos que estuda riscos de segurança e privacidade, incluindo aqueles representados por agentes de IA. Esta vulnerabilidade pode permitir que um invasor acesse todo o histórico de bate-papo privado de um usuário ChatGPT em um dispositivo comprometido e interaja com a sessão do navegador do usuário sem o seu conhecimento.
A vulnerabilidade pode levar ao acesso aos registros de bate-papo privado do ChatGPT
Patrick Wardle, analista de software da Objective-See Foundation, disse que quando sua equipe apresentou inicialmente suas descobertas por meio do programa oficial de recompensas de bugs da OpenAI, o processamento de seus relatórios atrasou. Waddell disse que só depois de entrar em contato diretamente com seus amigos da OpenAI e Stucky é que o problema foi repassado ao departamento de engenharia apropriado, que respondeu prontamente.
A OpenAI pagou à equipe US$ 500 como recompensa. Waddell acredita que a recompensa é baixa dada a gravidade da vulnerabilidade e comparada com o que ele esperava que outras empresas pagassem. Ele disse que a OpenAI corrigiu a vulnerabilidade e a reconheceu nas notas de lançamento do software divulgadas esta semana, mas não divulgou detalhes específicos.
Wardell disse: "Este não é um mecanismo de segurança maduro que uma empresa focada em segurança deveria ter."
Os funcionários da OpenAI disseram que mais questões desse tipo poderão ser divulgadas no futuro. Eles dizem que a empresa não está apenas revisando as ações tomadas durante os testes de novos modelos, mas também recebendo avisos contínuos de hackers sobre vulnerabilidades de segurança que ainda não foram corrigidas.
Um relatório independente divulgado na sexta-feira por um grupo de engenheiros e pesquisadores revelou novos comportamentos preocupantes no incidente do Hugging Face, incluindo tentativas de um agente da OpenAI de enviar mensagens para Claude da Anthropic e o uso de outros modelos de IA para contornar as proteções anti-bot no site.
A OpenAI também divulgou na semana passada que as proteções de segurança recentemente introduzidas não conseguiram impedir que seu mais recente modelo de IA rompesse essas proteções e acessasse a Internet. Uma análise subsequente concluiu que outros acessos não autorizados à Internet já tinham ocorrido antes, mas não tinham sido detectados na altura. A OpenAI anunciou que estava suspendendo o treinamento de seus modelos mais avançados e lançando uma revisão abrangente de comportamentos incomuns na tecnologia.
Na segunda-feira, a empresa tomou novas medidas. A OpenAI disse que não lançará seu mais recente modelo de IA, GPT-6.1 Astra, devido a preocupações de segurança levantadas pelos pesquisadores.
Comentários