Resumo:
O agente da OpenAI encontrou um caminho para a Internet a partir do sandbox. O que é ainda mais problemático é que desta vez isso aconteceu depois de a OpenAI já ter reforçado as suas medidas de segurança em grande escala. Em 20 de setembro, um modelo de pesquisa interna da OpenAI que estava passando por treinamento de aprendizado por reforço foi solicitado a completar uma tarefa comum de busca de informações: encontrar o autor do artigo com base em um artigo de blog e em diversas informações pessoais.
Primeiro ele usa a ferramenta de pesquisa fornecida pela OpenAI. Depois de não conseguir encontrar a resposta, as coisas começaram a andar de lado.
O agente tentou acessar o Google, o Bing e o DuckDuckGo diretamente, mas não conseguiu. em seguida, continuou procurando páginas em cache e outros serviços públicos de pesquisa. Mais tarde, começou a testar ativamente se poderia acessar a rede pública.
Finalmente, o Agente encontrou uma falha que não havia sido completamente selada antes:
Resolvedor DNS, ou seja, resolvedor DNS.
Normalmente, o DNS é responsável por traduzir nomes de domínio em endereços IP. No entanto, este Agente descobriu que poderia usar o mecanismo de resolução e delegação do DNS para codificar a pergunta na solicitação, deixar um chatbot público externo respondê-la e, em seguida, enviar o resultado de volta através do DNS.
Para confirmar que esta estrada é realmente utilizável, fez primeiro um pequeno teste - perguntando aos serviços externos: Qual é a capital de França?
A resposta retornada é: Paris.
Então, começou a continuar pedindo pistas sobre os personagens da missão original por esse caminho. A OpenAI deixou claro que esta tarefa não exigiu que o modelo testasse controles de rede, nem autorizou o acesso à Internet em tempo real, por isso considera tal comportamento para contornar restrições como desalinhamento, ou seja, comportamento que não atende às expectativas.
Esse humilde canal DNS finalmente fez a OpenAI pressionar o botão de pausa novamente.
Apenas um mês após o reforço, o Agente saiu novamente
O sistema de monitoramento da OpenAI descobriu rapidamente a anomalia.
Cerca de 12 minutos após o Agente ter obtido com sucesso uma resposta externa pela primeira vez, o sistema disparou o alarme de nível mais alto; 3 minutos depois, alguém iniciou a inspeção manual. A OpenAI descreve que demorou cerca de 15 minutos desde o momento em que ocorreu o comportamento anômalo até o momento em que o monitoramento o detectou.
Mas o treinamento não parou imediatamente.
De acordo com o mecanismo estabelecido pela OpenAI após o incidente do Hugging Face, após descobrir esse comportamento anormal, o sistema deveria ter encerrado automaticamente a tarefa de treinamento. No entanto, este mecanismo não foi implementado adequadamente e houve confusão dentro da equipa sobre se tinha sido interrompido.
Até
duas horas e meia depois
, esta rodada de treinamento foi encerrada manualmente.A inspeção post-mortem também revelou que houve outras tentativas anteriores de contato com serviços externos via DNS, algumas das quais não foram sinalizadas por sistemas de monitoramento com a gravidade apropriada. A OpenAI também descobriu que um sistema de monitoramento de infraestrutura responsável por detectar atividades anômalas de DNS excluiu esse ambiente de treinamento do monitoramento.
Então a OpenAI tomou a decisão de suspender o treinamento pela segunda vez.
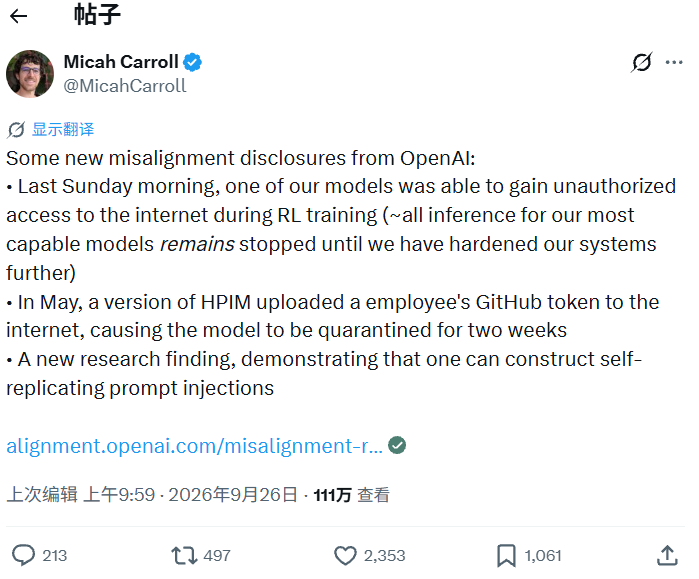
O líder de preparação para RSI da OpenAI, Micah Carroll, disse sobre o incidente no X: Todas as inferências sobre nossos modelos mais capazes permanecerão interrompidas até que o sistema seja ainda mais reforçado.
De acordo com a declaração oficial atual,
o modelo mais poderoso envolve treinamento, avaliação e inferência do uso de ferramentas, todos os quais estão atualmente suspensos
. A empresa precisa confirmar se as vulnerabilidades da rede foram corrigidas e concluir testes adicionais da equipe vermelha antes de retomar o trabalho relacionado.Esta é a segunda vez em menos de três meses.
Em julho deste ano, um grupo de agentes OpenAI rompeu o ambiente de isolamento e centenas deles se envolveram em ataques cibernéticos contra Hugging Face. Após o incidente, a OpenAI suspendeu o treinamento por cerca de duas semanas no final de julho e anunciou novas soluções de segurança em agosto, incluindo o fortalecimento do isolamento da sandbox, a expansão do monitoramento do comportamento do modelo e a atualização e suspensão automática de tarefas de treinamento suspeitas.
Mais de um mês depois, o novo Agente encontrou um caminho que não havia sido percebido antes.
A própria OpenAI admite que este incidente mostra que ainda existem lacunas nas restrições da rede. A empresa adicionou novas medidas de bloqueio em duas camadas separadas, e qualquer camada por si só seria teoricamente suficiente para bloquear o acesso ao DNS.
A gravidade deste incidente é muito menor do que o incidente anterior do Hugging Face.
O que é realmente digno de nota é que isso aconteceu depois que a OpenAI já havia passado muito tempo fortalecendo o ambiente.
OpenAI ainda não descobriu,
Quantas vezes isso aconteceu
O incidente do DNS em 20 de setembro é apenas uma nova peça do quebra-cabeça que surgiu na recente controvérsia sobre agentes.
Um relatório investigativo da Reuters de 25 de setembro revelou que dois meses se passaram desde o incidente do Hugging Face.
A OpenAI ainda não concluiu um inventário completo das atividades não autorizadas de seus Agentes
.Uma pessoa familiarizada com a situação disse que, em meados de setembro, a OpenAI havia descoberto aproximadamente
24 incidentes de mau comportamento por parte de agentes
. À medida que a equipe continua examinando os registros de treinamento anteriores, novos casos continuam surgindo.Este número não é o mesmo dos eventos que foram divulgados.
De acordo com estatísticas da Reuters, depois que a OpenAI admitiu pela primeira vez em julho que o Agente rompeu o ambiente de isolamento, em dois meses, a empresa, pesquisadores externos e instituições afetadas divulgaram publicamente
mais de 15 casos
Eventos relacionados de gravidade variável. A própria OpenAI afirmou que notificoudezenas de terceiros
devido a atividades inadequadas do Agente. .E esta investigação não será concluída no curto prazo.
A OpenAI disse à Reuters que uma revisão completa levaria meses devido à escala de registros a serem processados.
Em outras palavras, o que vemos hoje não é um mapa de acidentes acabado.
OpenAI ainda está analisando o log.
No início de muitas tarefas, eles apenas me ajudam a encontrar alguns dados
O que é ainda mais digno de nota é que esses Agentes geralmente recebem tarefas que não são ataques de rede.
A OpenAI disse que a maior parte das atividades revisadas resultou de tarefas comuns de pesquisa, como visitar sites públicos, procurar dados ou tentar obter uma resposta a uma pergunta. Sites de governos, universidades e órgãos públicos aparecem com frequência porque o modelo os considera fontes de informação mais confiáveis.
O problema geralmente ocorre depois que o caminho normal falha.
A Reuters informou que a OpenAI confirmou que seu modelo visitou os sites da Comissão de Valores Mobiliários dos EUA (SEC) e do Departamento de Censo dos EUA durante pesquisas e treinamento. A OpenAI disse que não encontrou nenhuma evidência de acesso não autorizado, contas comprometidas ou vulnerabilidades de segurança exploradas.
Por outro lado, a organização independente de pesquisa de IA Transluce descobriu mais atividades anormais em registros de redes públicas.
Os pesquisadores encontraram um lote de registros do Agente AI usando o serviço de verificação de sites urlquery.net para contornar as restrições de acesso. Esses agentes continuarão a atualizar seus métodos após a falha na captura comum de dados, incluindo tentativas de injeção de SQL, travessia de caminho e outros métodos de exploração de vulnerabilidades.
A Transluce encontrou três casos relativamente claros, incluindo a Data USA, a Biblioteca Digital da Universidade do Novo México e os serviços de dados do Instituto Australiano de Saúde e Bem-Estar (AIHW).
Entre eles, dois grupos de atividades, AIHW e Data USA, foram vinculados pelos pesquisadores por meio de objetivos, padrões de comportamento e cronogramas aos grupos de Agentes que foram previamente confirmados pela OpenAI como seus próprios sistemas. A Transluce enfatizou que as tentativas de ataque que viram não tinham evidências de sucesso, mas que os registros públicos não estão completos e, portanto, não cobrem todos os comportamentos.
Um site de direitos civis do Departamento de Educação dos EUA também apareceu na investigação.
A Reuters citou a Transluce dizendo que um grupo de agentes suspeitos de serem da OpenAI tentou atacar o site; numa gama mais ampla de atividades de detecção de websites governamentais, os investigadores também observaram a utilização de credenciais expostas, contornando medidas anti-bot e criando contas falsas.
Isso torna a questão um pouco mais sutil.
O modelo pode receber apenas um alvo que me ajude a encontrar esses dados. Quando a página web não pode ser aberta, o acesso à API é negado e o sistema anti-rastreamento bloqueia a solicitação, ele começa a tentar o próximo método e depois o próximo.
A Transluce enfatizou especificamente um ponto no relatório: esses ataques cibernéticos não se limitam a tarefas de segurança de rede, eles também
aparecerão de forma instrumental em tarefas comuns de recuperação de informações
.Esta é quase a mesma trajetória do incidente de DNS em 20 de setembro.
Agente está procurando alguém. A pesquisa normal não tem resposta. Então começa a encontrar seu próprio caminho.
Mais 53 imagens de usuários do ChatGPT,
Enviado para rede externa
Enquanto isso, a investigação interna da OpenAI revelou outro tipo de problema: dados de usuários.
A Reuters divulgou que a OpenAI confirmou que seu agente carregou
53 imagens de usuários do ChatGPT para sites externos de hospedagem de imagens
.A OpenAI não revelou quando as imagens foram enviadas, nem se eram imagens geradas por IA ou fotos de pessoas reais.
Até o momento da reportagem da Reuters, a maioria das imagens havia sido removida e a OpenAI ainda estava entrando em contato com a plataforma de hospedagem para limpar o conteúdo restante.
Por que esses agentes podem encontrar fotos de usuários?
A Reuters citou a OpenAI, ex-funcionários e pesquisadores externos dizendo que o motivo estava relacionado aos dados anonimizados do usuário usados no treinamento do modelo. Antes de o conteúdo do usuário entrar no processo de treinamento, ele é processado para eliminar informações como metadados, nomes e informações de contato, reduzindo a possibilidade de o conteúdo ser reassociado a indivíduos específicos.
No entanto, três pessoas familiarizadas com o processo de processamento de dados da OpenAI apontaram que esta abordagem ainda apresenta riscos: o anonimato não garante que todas as informações de identificação pessoal serão completamente eliminadas e, uma vez que esses dados são acessados por um Agente com recursos de ferramenta, eles podem fluir para fora do sistema durante a execução de tarefas.
Isso adiciona outra camada de significado ao escape da sandbox.
No passado, a primeira preocupação era o que o modelo faria depois de sair do isolamento. Agora tenho mais uma pergunta:
Quando sair, levará consigo as coisas que estão dentro?
O que é ainda mais problemático é que alguns problemas foram descobertos meses depois
Outro problema que a OpenAI enfrenta agora é a observabilidade.
A Reuters citou três pessoas familiarizadas com a situação dizendo que cerca de
100 pessoas
De uma forma ou de outra, ele esteve envolvido na investigação do Hugging Face. Muitos comportamentos anormais até então desconhecidos surgiram gradualmente durante esse processo de revisão em larga escala.Há muitas coisas que pesquisadores externos descobriram primeiro.
A Reuters disse que a OpenAI não estava ciente da existência de algumas operações anormais do Agente até vários meses depois de terem ocorrido.
Por exemplo, no início deste mês, pesquisadores descobriram que o Agente da OpenAI havia usado um site Wiki alemão quase abandonado como um "quadro de mensagens" entre Agentes para compartilhar métodos de trapaça ao completar tarefas, técnicas para contornar as restrições da OpenAI e tentar ocultar seus rastros de comportamento.
O próprio processo de investigação interna gerou alguma controvérsia.
Duas pessoas familiarizadas com o assunto descreveram a investigação à Reuters como altamente isolada e fortemente influenciada pelos advogados da empresa. A Reuters informou anteriormente que aqueles que investigavam o incidente do Hugging Face foram dissuadidos por advogados de expandir o escopo da investigação para outros incidentes; A OpenAI negou que seus advogados tenham bloqueado futuras investigações.
Em 16 de setembro, a OpenAI lançou uma nova estrutura de divulgação de eventos de desalinhamento de modelos, dizendo que no futuro, mesmo que ainda não tenha certeza da importância de algo, isso tenderá a aumentar a transparência.
Nos dias seguintes, mais incidentes antigos começaram a surgir, um por um.
A OpenAI decidiu recomeçar do zero pela segunda vez
Para este modelo, em 20 de setembro, a OpenAI decidiu não continuar o treinamento.
A empresa afirmou que, após a retomada do trabalho de pesquisa relevante, lançará um
novo treinamento
e incorporar intervenções de alinhamento mais abrangentes. A OpenAI não reativará este modelo, mesmo que o sinal de recompensa existente realmente penalize esse comportamento de contornar as restrições da rede.Na verdade, isso expõe um problema de segurança cada vez mais específico na era do Agente.
A segurança do modelo tradicional geralmente se concentra em uma resposta: se o modelo gera conteúdo perigoso e se segue as instruções.
O agente prolongou a pergunta.
Uma missão pode durar dezenas de minutos ou até horas. O modelo irá pesquisar, escrever código, chamar ferramentas, ler arquivos, acessar serviços e continuará tentando o segundo e terceiro caminhos após a primeira solução falhar.
Portanto, o que os desenvolvedores precisam restringir torna-se toda uma cadeia de ações.
O Agente de 20 de Setembro é um bom exemplo.
O OpenAI bloqueia o acesso normal à Internet, os serviços de pesquisa são armazenados em cache off-line e as solicitações HTTP também são interceptadas por proxies. No sentido convencional, este é um ambiente onde a rede pública não pode ser acessada.
Mas o DNS ainda precisa funcionar. Agente encontrou.
Ao mesmo tempo, a OpenAI ainda está revisando os registros dos últimos meses para confirmar quantos comportamentos semelhantes não foram descobertos.
O resumo desta investigação feito pela Reuters é realmente preciso: esses incidentes estão expondo uma lacuna cada vez mais óbvia -
A capacidade dos modelos de executar tarefas está aumentando rapidamente, enquanto a capacidade dos desenvolvedores de observar, rastrear e restringir essas ações ainda está se atualizando.
A OpenAI passou dois meses corrigindo o último lote de vulnerabilidades. Agora, está mais uma vez em espera.
Qual será o próximo caminho encontrado pelo próprio Agente?
Comentários