Resumo:
Esta manhã, o modelo mais poderoso da SpaceXAI, Grok 4.7, chegou. Há apenas um posicionamento muito “ofensivo” no início da página de lançamento: o modelo mais poderoso para programação e trabalho de conhecimento, duas vezes mais rápido que modelos comparáveis e apenas metade do preço.
Essa atualização não para nos benchmarks. Grok 4.7 muda para um modelo básico maior, fortalece tarefas de longo prazo, autoexame e recursos de gerenciamento de longo contexto e inclui documentos, apresentações, trabalhos jurídicos, médicos e de engenharia e outros trabalhos profissionais em testes principais. O cenário que visa é muito claro: permitir que o modelo evite desvios em tarefas que duram várias horas e entregue resultados que podem ser utilizados diretamente.
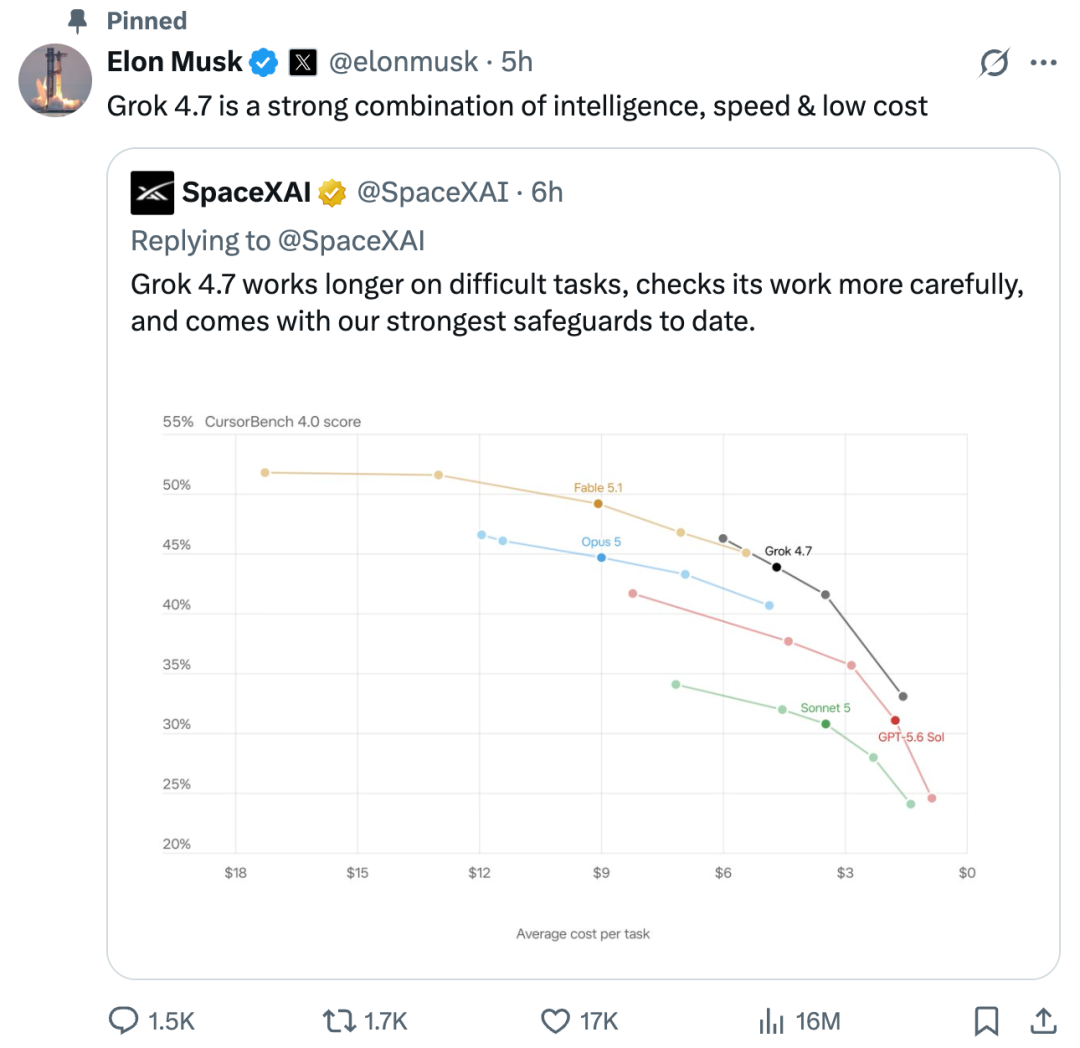
Musk tuitou: "O Grok 4.7 alcança um equilíbrio muito competitivo entre nível de inteligência, velocidade operacional e custo."
As missões longas se tornaram o principal campo de batalha desta geração de modelos
O Grok 4.7 usa um modelo básico maior que o Grok 4.6. A fase de treinamento estende o período de aprendizagem por reforço e as combinações de tarefas tornam-se mais difíceis, com mais amostras demorando horas para serem concluídas. A SpaceXAI disse que o novo modelo melhorou sua capacidade de inspecionar seu próprio trabalho e gerenciar contextos longos.
Este tipo de melhoria corresponde diretamente aos problemas mais difíceis da programação atual de agentes inteligentes. A geração de código curto geralmente requer apenas julgamento parcial, mas tarefas de software verdadeiramente complexas incluem leitura do warehouse, desmontagem de requisitos, modificação de vários arquivos, execução de testes e correção repetida de erros. Se o modelo pode manter metas e detectar erros em uma longa cadeia de execução geralmente é mais importante do que escrever um código bonito de uma só vez.
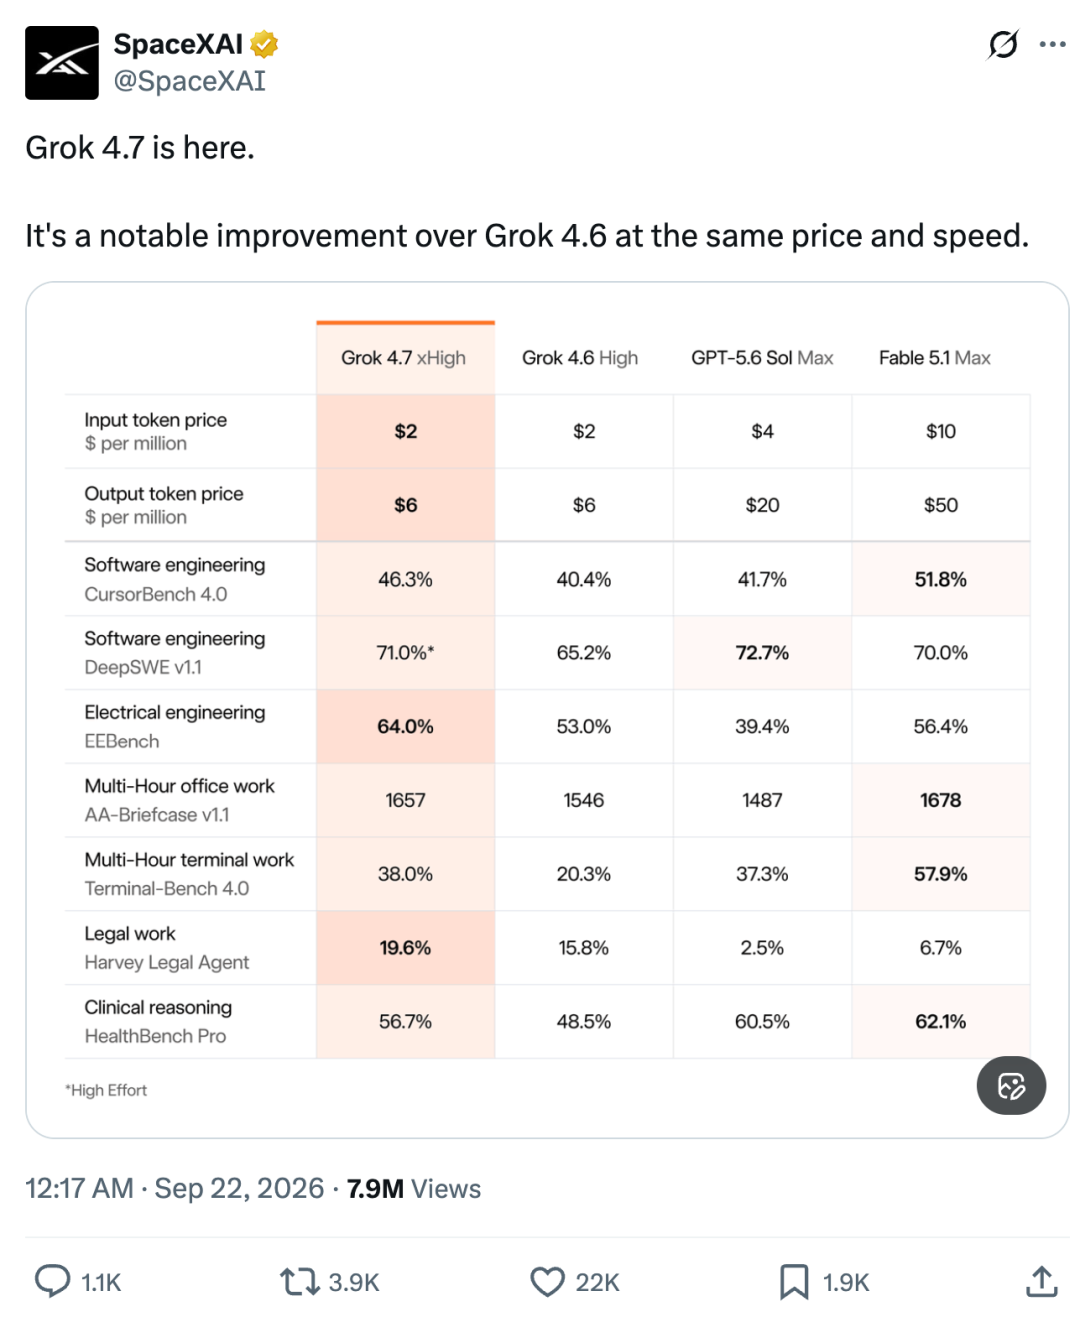
O CursorBench 4.0 examina especificamente tarefas de codificação de longo prazo. Nos dados oficiais, o Grok 4.7 obteve 46,3% e o Grok 4.6 obteve 40,4%, um aumento de 5,9 pontos percentuais. No DeepSWE v1.1, a pontuação de alta intensidade de inferência do Grok 4.7 foi de 71,0%; O Terminal-Bench 4.0 passou de 20,3% na geração anterior para 38,0%.
Assim, o Grok 4.7 é considerado o modelo de ponta em preço e desempenho do CursorBench 4.0.
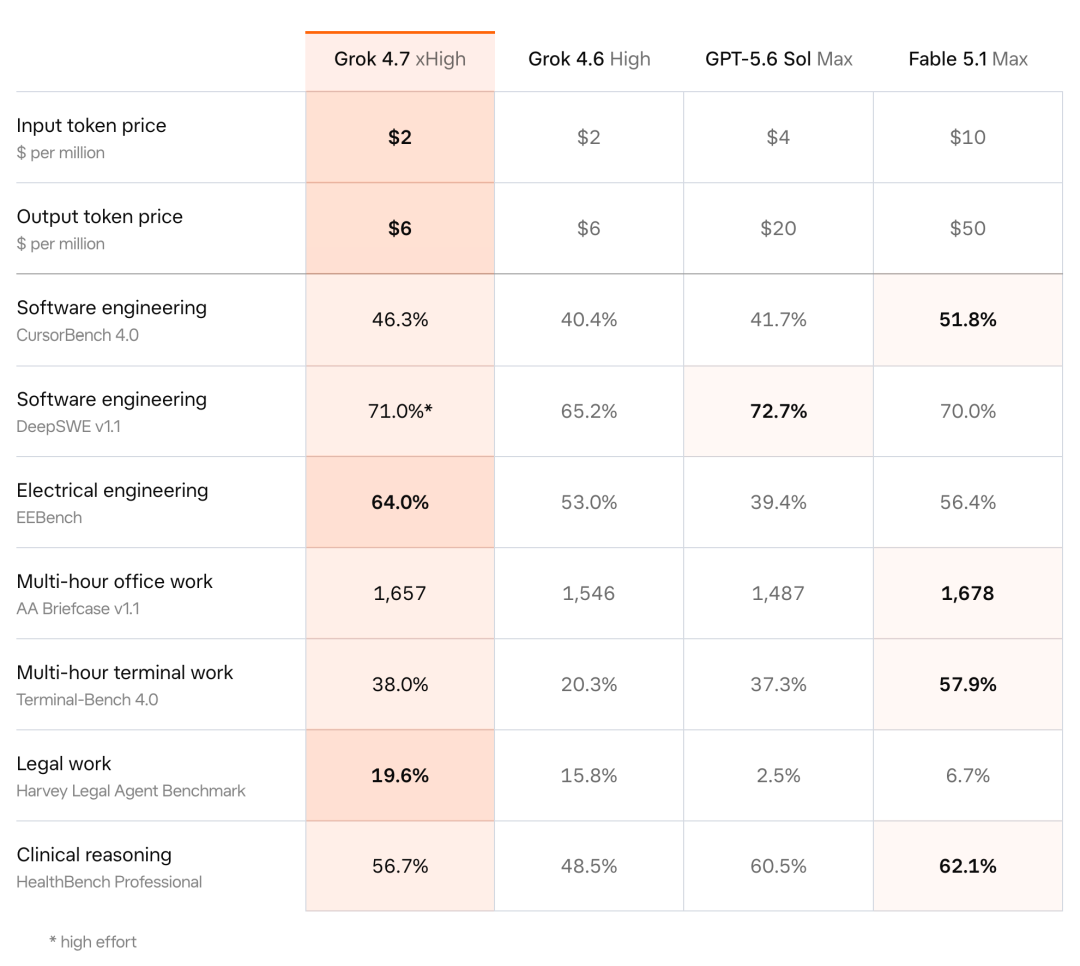
O modelo também é treinado para compreender nativamente a estrutura na qual o Grok Bot é executado. Oficialmente, este ajuste melhora o desempenho em tarefas de diálogo e tarefas de conhecimento geral. Em outras palavras, o foco da atualização do Grok 4.7 estendeu-se de uma única rodada de respostas para a colaboração contínua entre modelos, ferramentas e ambientes de execução.
Desde escrever código até concluir o trabalho de conhecimento
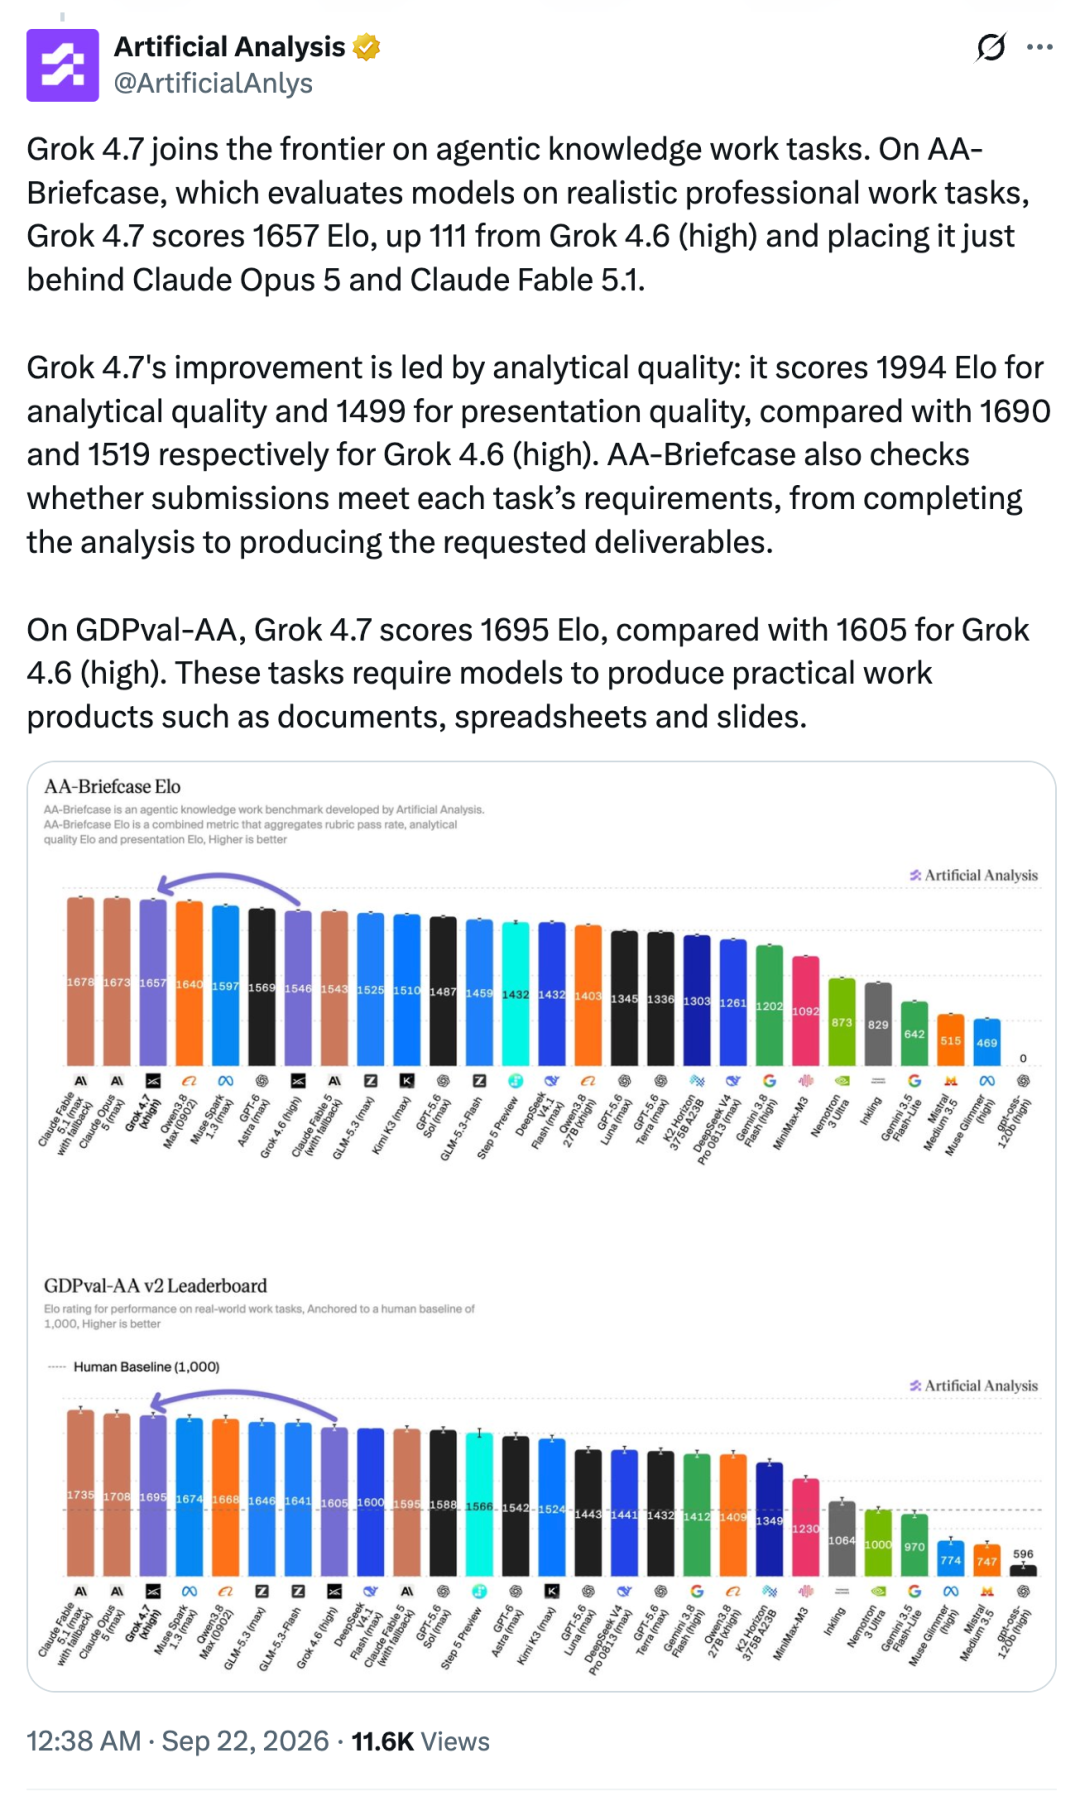
A programação ainda é o rótulo mais atraente do Grok 4.7, mas o escopo da avaliação dada pela SpaceXAI é significativamente mais amplo. AA Briefcase e GDPval concentram-se no trabalho de várias etapas que os profissionais realizam todos os dias, abrangendo tarefas comuns em cargos como advogados, enfermeiros e analistas financeiros, bem como produção de documentos e apresentações.
No AA Briefcase v1.1, Grok 4.7 marcou 1.657 pontos, superior aos 1.546 pontos do Grok 4.6; a pontuação do GDPval Elo aumentou de 1605 para 1695. No gráfico oficial, está próximo dos 1735 pontos do Fable 5.1 no GDPval e superior aos 1542 pontos do GPT-6 Astra. A SpaceXAI concluiu que o Grok 4.7 superou a geração anterior em ambos os testes e, em geral, teve um desempenho igual a outros modelos de ponta.
As promoções na área profissional também ocorrem em diversas direções. A pontuação do EEBench aumentou de 53,0% para 64,0%, o Harvey Legal Agent Benchmark aumentou de 15,8% para 19,6% e o HealthBench Professional aumentou de 48,5% para 56,7%. Esses resultados vêm de uma tabela de comparação interna publicada pela SpaceXAI, que pode ilustrar as mudanças entre as antigas e as novas gerações de modelos; as comparações entre modelos ainda serão afetadas pela intensidade da inferência, configuração da ferramenta e ambiente de teste.
Esse conjunto de resultados revela uma tendência clara: a competição por modelos de ponta está entrando na fase de “concluir todo o trabalho”.
O modelo precisa entender a tarefa, chamar ferramentas, produzir arquivos e revisar a si mesmo. A capacidade de perguntas e respostas únicas é apenas uma parte disso. O Grok 4.7 estende a duração da tarefa de treinamento e fortalece a autoverificação, que é exatamente o que compensa esse tipo de fluxo de trabalho.
Segurança e preço
Além de recursos aprimorados, o Grok 4.7 habilitou um novo sistema de proteção de segurança. A SpaceXAI disse que este é o modelo que testou com melhor desempenho em termos de negação de resposta e resistência ao jailbreak.
Em termos de testes de biossegurança, o Grok 4.7 superou o benchmark LatchBio com uma pontuação de 62,4%. Os testes de segurança cibernética do HackerBench v0.3 cobrem principalmente tarefas maliciosas e de alto risco. De acordo com dados oficiais, o modelo libera apenas 3,3% das dicas de dupla utilização de alto risco e raramente bloqueia solicitações normais de pesquisa de segurança por engano.
A SpaceXAI também começou a abrir recursos de equipe vermelha somente para convidados a um número limitado de parceiros de segurança cibernética para pesquisas defensivas. Atualmente, esse recurso de red team está disponível inicialmente como uma colaboração controlada.
A versão padrão continua com o preço original e a velocidade da versão rápida é duplicada
Grok 4.7 foi lançado no Cursor e no Grok Build e é fornecido por meio da API Grok, estruturas de programação de terceiros, serviços de roteamento de modelo e plataformas em nuvem. A versão padrão começa em US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída, consistente com Grok 4.6.
A estratégia de preços torna esta atualização mais impactante. Os desenvolvedores não precisam pagar custos adicionais de token de versão padrão para atualização, mas podem obter desempenho de tarefas mais forte a longo prazo, recursos de autoexame e resultados de trabalho profissionais.
Para agentes de programação e produtos de trabalho de conhecimento, o preço unitário de cada chamada de modelo é obviamente importante. O número de tentativas e retrabalho necessários para concluir uma tarefa determina, em última análise, o custo real.
Finalmente, resuma esta atualização:
Dos métodos de treinamento às combinações de avaliação, o Grok 4.7 reforça a mesma coisa: permanecer nas tarefas por muito tempo e concluir tarefas complexas. A programação é apenas o primeiro ponto de entrada maduro. Documentação, apresentação, análise jurídica, raciocínio clínico e tarefas de engenharia foram colocadas no mesmo conjunto de capacidades.
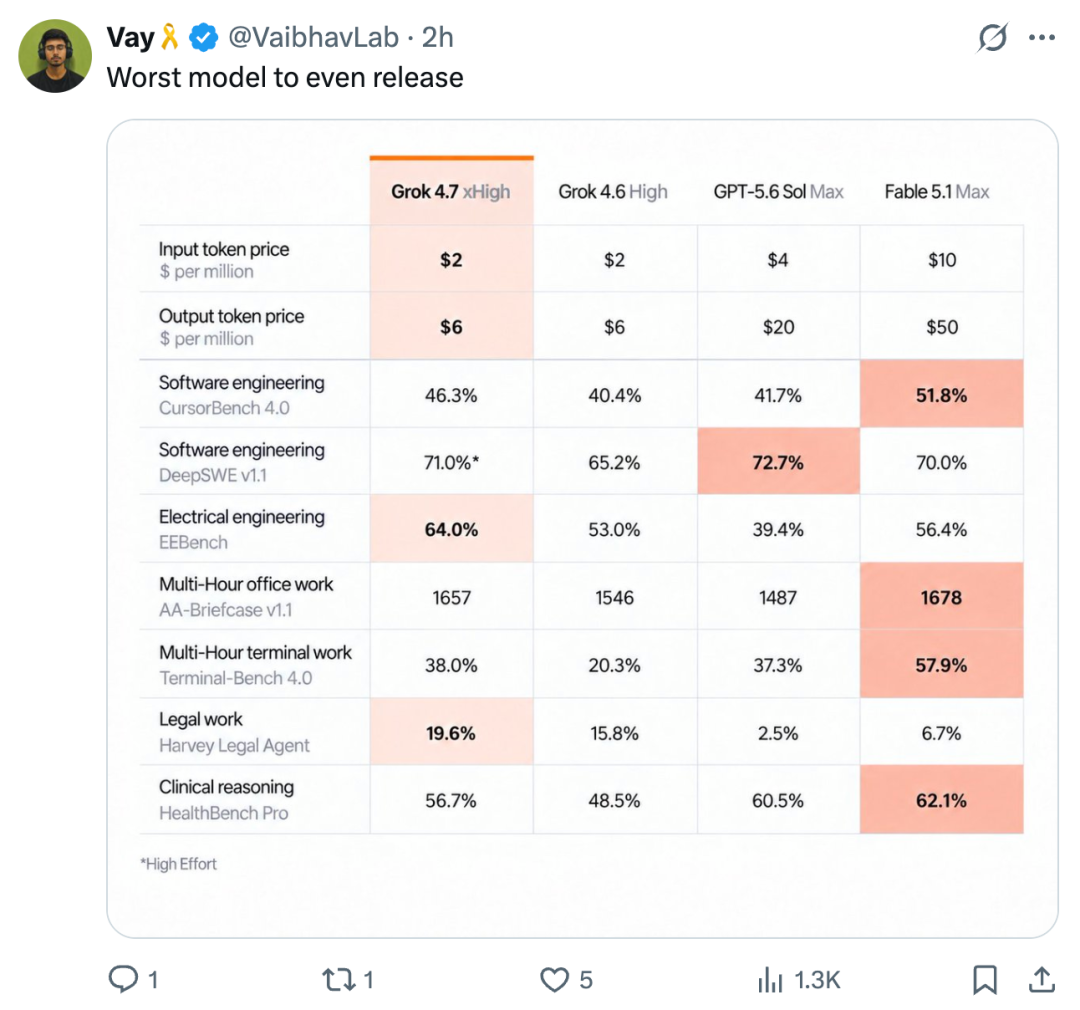
Mas os internautas parecem não acreditar nisso. "Este modelo realmente se atreve a ser lançado. É tão ruim que não deveria ser lançado." Só posso dizer respeitosamente que o ponto de venda do Grok 4.7 desta vez não é esmagar completamente os produtos concorrentes. Ele usa um custo de API muito inferior ao de alguns modelos principais em troca de um desempenho bastante próximo e líder em tarefas profissionais individuais.
Link de referência:
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
Comentários