
Resumo:
O Sony PlayStation 5 foi originalmente projetado como um console para videogames, mas um projeto de desenvolvimento de código aberto está tentando encontrar outro uso para esse dispositivo de jogos: executar modelos locais de inteligência artificial em grandes linguagens. Ao quebrar as limitações do sistema do PS5, os desenvolvedores transplantaram o mecanismo de inferência de código aberto llama.cpp para o console e usaram ainda sua GPU para executar modelos grandes. A última demonstração mostra que um PS5 comum crackeado já pode rodar o modelo Qwen 3.8 com 27 bilhões de parâmetros. Usando quantização de baixo bit, a velocidade de geração de texto atinge cerca de 20 tokens por segundo.
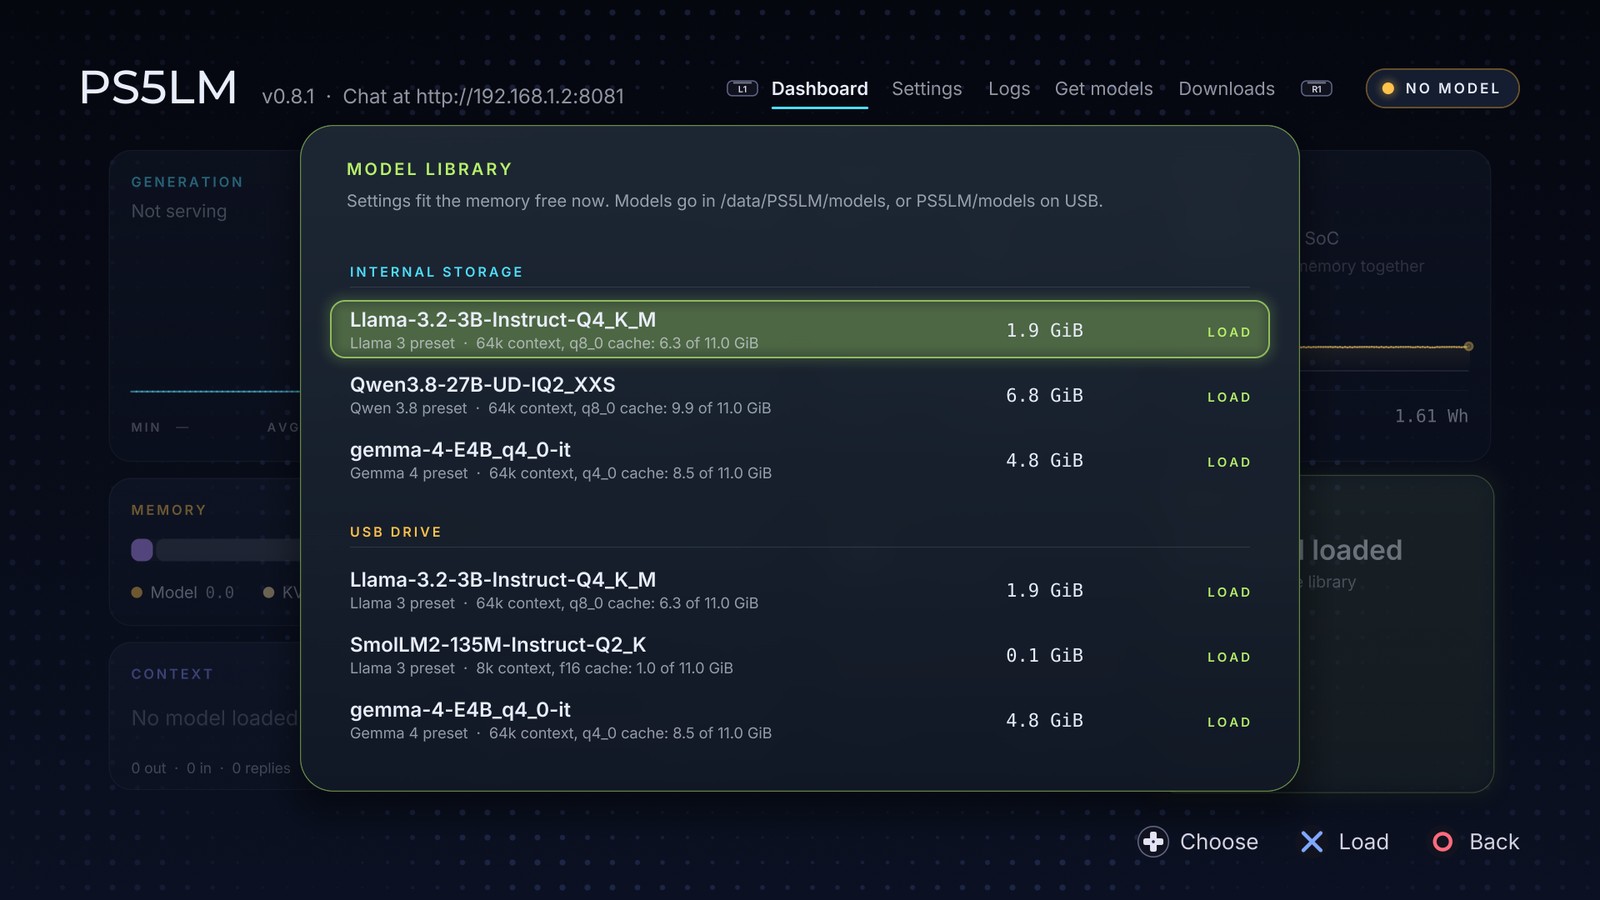
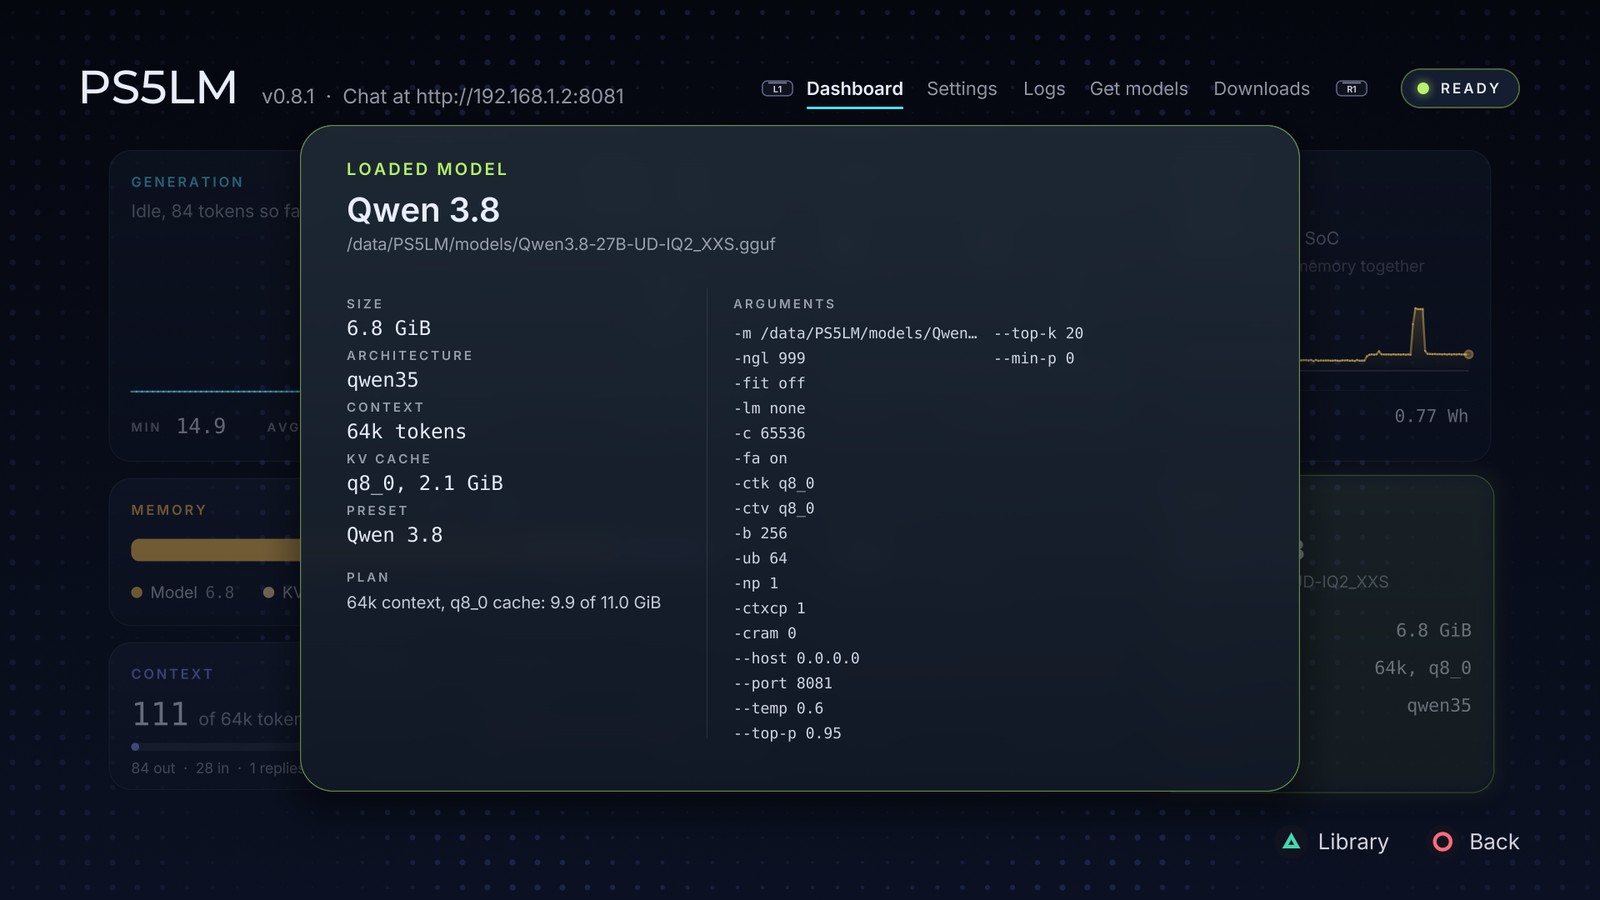
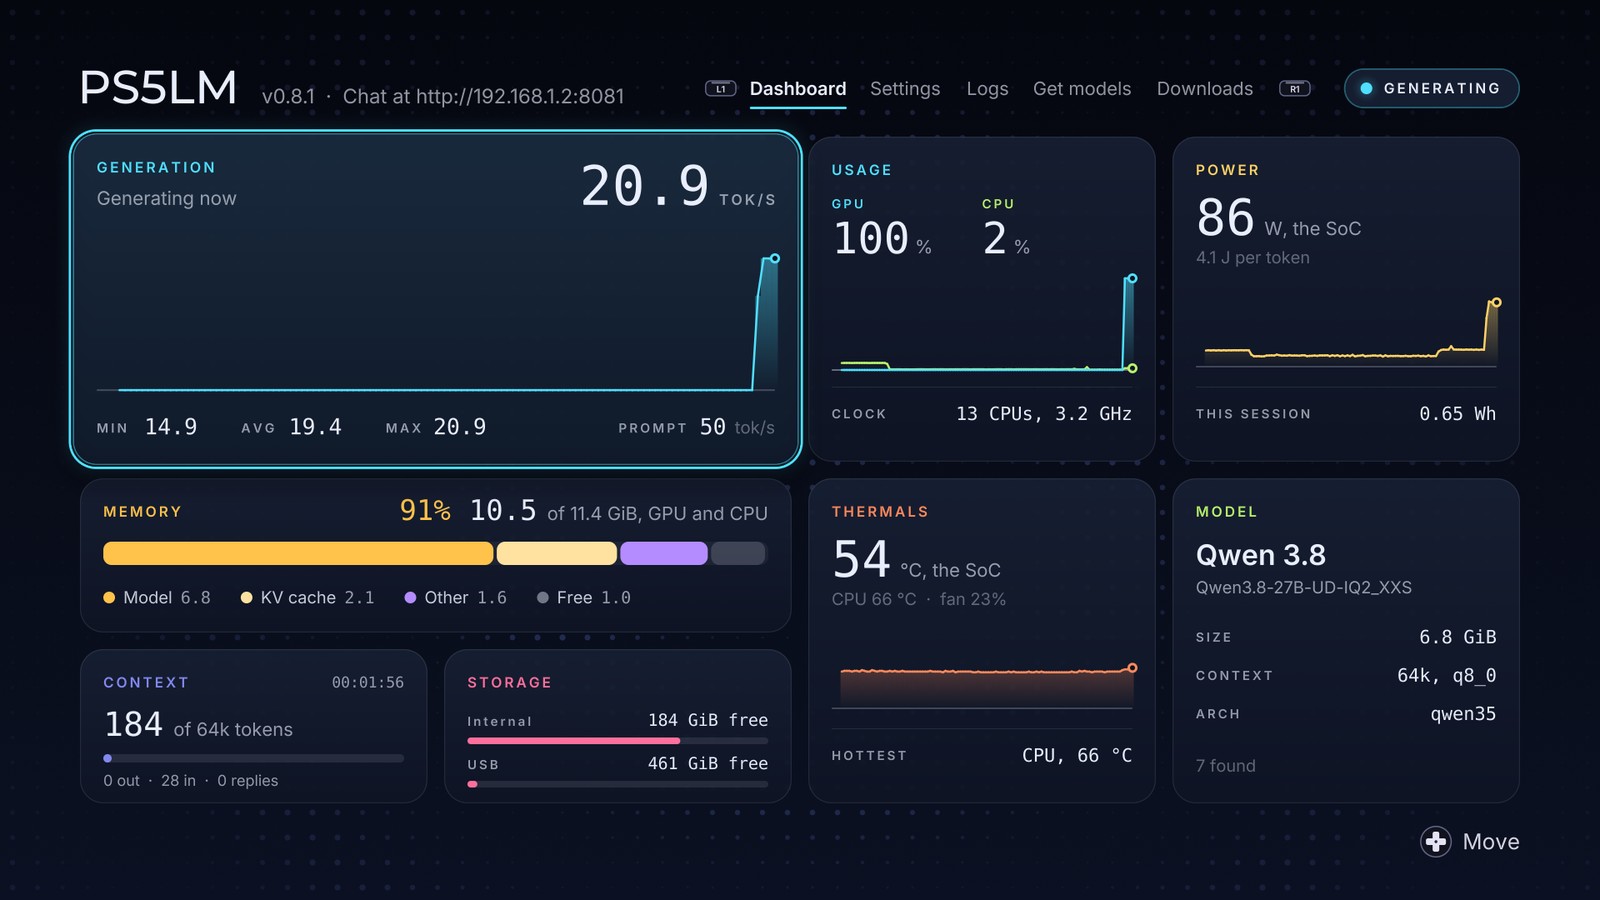
Isso significa que um host originalmente usado para executar jogos também pode atuar como um servidor local de modelo de linguagem grande sem depender de serviços de IA em nuvem. Os usuários podem acessar os serviços no host através de um computador ou celular na mesma LAN e conversar com o modelo. No entanto, este não é um recurso fornecido oficialmente pela Sony, mas sim um aplicativo experimental que depende de vulnerabilidades do sistema, software não oficial e resultados de desenvolvimento da comunidade.
O projeto se chama PS5LM e foi iniciado pelo desenvolvedor do GitHub, cobanov. A ideia central do projeto não é escrever uma nova estrutura de raciocínio de inteligência artificial do zero, mas transplantar a ferramenta de código aberto llama.cpp, que tem sido amplamente utilizada para executar grandes modelos locais, para a plataforma PS5 e, em seguida, resolver gradualmente os problemas de compatibilidade no sistema operacional host, alocação de memória e interface de computação GPU.
O PS5 usa o processador personalizado da AMD. A CPU usa arquitetura Zen 2 e possui 8 núcleos; a GPU é baseada na arquitetura AMD RDNA. O host está equipado com memória unificada GDDR6 de 16 GB e a CPU e GPU precisam compartilhar esses recursos. Embora o PS5 não seja um dispositivo projetado especificamente para inferência de inteligência artificial, sua GPU e memória de vídeo de alta largura de banda fornecem a base de hardware para a execução de modelos em idiomas locais.
PS5LM inicialmente adotou um modo de operação relativamente simples, permitindo que o modelo de linguagem realizasse inferências através da CPU host e usando o próprio navegador do PS5 para fornecer uma interface de chat. Os usuários podem baixar o modelo no host, inserir perguntas por meio do controlador DualSense e do teclado na tela e, em seguida, visualizar as respostas geradas pelo modelo.
Esta versão inicial demonstrou a capacidade do PS5 de executar grandes modelos de linguagem, mas rapidamente enfrentou limitações de desempenho e memória. Como o programa é executado na forma de carga útil, a memória que pode ser usada é restrita pelo ambiente do sistema. Inicialmente, apenas modelos menores podem funcionar de forma estável. Os documentos do projeto mostram que a versão inicial suporta principalmente modelos com tamanhos de parâmetros de aproximadamente 0,8B e 2B, com a velocidade de geração do modelo 2B sendo de aproximadamente 9 Tokens por segundo.
Para desenvolvedores que desejam rodar modelos maiores no PS5, simplesmente deixar o programa rodar na CPU não é suficiente. Para utilizar totalmente o desempenho do hardware do host, o mecanismo de inferência deve ser capaz de chamar a GPU e obter espaço de memória suficiente para armazenar parâmetros do modelo, cache e outros dados em execução.
O verdadeiro avanço vem da aceleração da GPU. Os desenvolvedores implementaram ainda um ambiente de execução de aplicativo nativo no PS5 e, por meio do driver gráfico e da interface de computação Vulkan desenvolvida pela comunidade, llama.cpp pode chamar a GPU host para realizar cálculos de rede neural. Comparada com a solução anterior que dependia apenas da CPU, essa mudança não apenas melhora a velocidade de inferência, mas também permite que o programa obtenha mais memória disponível para tentar executar modelos maiores.
Na última demonstração, o PS5 executou com sucesso o modelo Qwen 3.8 27B lançado pela equipe Alibaba Tongyi Qianwen. O modelo possui 27 bilhões de parâmetros e utiliza uma arquitetura de atenção híbrida. O objetivo do projeto é fornecer forte compreensão da linguagem, raciocínio e recursos de geração de código em recursos de hardware relativamente limitados.
No entanto, o PS5 não carrega 27 bilhões de parâmetros diretamente na memória com total precisão. Para adaptar o modelo às condições de hardware do host, os desenvolvedores usaram tecnologia de quantização de baixo bit para compactar os parâmetros do modelo em um espaço de armazenamento menor. A demonstração usa versões quantizadas, como IQ2_XXS, e o arquivo do modelo tem cerca de vários GB a 7 GB, e o tamanho específico depende do esquema de quantização.
A quantificação é uma tecnologia fundamental na execução de grandes modelos locais. Normalmente, os parâmetros do modelo são armazenados usando um formato de dados de maior precisão, mas isso consome muita memória. Ao compactar parâmetros em valores de largura de bits mais baixos, você pode reduzir significativamente os requisitos de memória e a quantidade de transferência de dados durante a inferência. O custo é que algumas informações precisas serão perdidas, o que pode afetar a qualidade da resposta do modelo, a capacidade de raciocínio ou o desempenho de tarefas específicas. Portanto, ser capaz de executar um modelo de 27 bilhões de parâmetros não significa que o PS5 possa executar um modelo do mesmo tamanho com precisão total.
Dados de teste divulgados pelo desenvolvedor mostram que ao usar a GPU para realizar inferências, a velocidade de geração de texto do Qwen 3.8 27B pode atingir cerca de 20 Tokens por segundo. Token é a unidade básica para grandes modelos de linguagem processarem texto. Não é estritamente equivalente a um caractere chinês ou a uma palavra inglesa. Portanto, 20 Tokens por segundo não podem ser entendidos simplesmente como a geração de 20 caracteres chineses por segundo. Ainda assim, isso é rápido o suficiente para que as conversas interativas tenham alguma praticidade, em vez de serem apenas uma demonstração técnica para provar que um modelo pode decolar.
Além do modelo Qwen, o mesmo projeto também anunciou os resultados dos testes de outros modelos. Gemma 4 E4B gera aproximadamente 61 tokens por segundo, enquanto Llama 3.2 3B atinge aproximadamente 124 tokens por segundo. Modelos pequenos têm menos parâmetros, exigem menos cálculos e leituras de dados e, portanto, geralmente alcançam velocidades de geração mais altas.
Esses resultados ainda devem ser considerados como resultados de testes publicados por desenvolvedores sob configurações específicas de software e hardware, em vez de benchmarks do setor verificados por uma plataforma de testes unificada. Diferentes modelos têm diferentes escalas de parâmetros, métodos de quantificação, comprimentos de contexto e tarefas de computação. Suas capacidades abrangentes não podem ser avaliadas com base apenas no número de tokens gerados por segundo.
O projeto também demonstra a possibilidade de transformar o PS5 em um servidor LAN AI. Ao executar uma interface de serviço compatível com a API OpenAI no host, outros dispositivos podem enviar solicitações pela mesma rede e obter respostas geradas pelo modelo. Dessa forma, os usuários nem sempre precisam ficar de frente para a tela da TV para operar o console, podendo também ligar para o modelo local no PS5 através do computador ou celular.
Essa abordagem é atraente para usuários que desejam implantar serviços locais de IA em suas redes domésticas. Quando o modelo é executado localmente, em princípio, o conteúdo das conversas diárias não precisa ser enviado para serviços de IA em nuvem de terceiros, e os usuários não precisam pagar taxas de inferência na nuvem com base no número de chamadas. No entanto, a proteção real da privacidade ainda depende do software instalado, da configuração da rede e se o dispositivo possui outros comportamentos de transmissão de dados. O sistema não pode ser considerado absolutamente seguro apenas por “executar localmente”.
Ao mesmo tempo, o desenvolvimento do PS5LM ainda depende de uma série de tecnologias não oficiais. Os usuários precisam ter um PS5 que possa executar o programa de cracking relevante e usar firmware de sistema compatível e ferramentas de carregamento de carga útil. A faixa de firmware aplicável listada no documento do projeto é de 7,00 a 13,60, mas funções específicas, desempenho e compatibilidade podem variar dependendo do modelo do host e da versão do software.
Quebrar o console não significa que todos os usuários do PS5 possam instalar o programa diretamente. A versão comercial comum do PS5 não pode baixar e executar o PS5LM através da PlayStation Store como os jogos normais. Os usuários precisam primeiro resolver problemas como permissões de acesso ao sistema, carregamento não oficial de programas e ambiente operacional, o que ainda representa um certo limite para usuários que não estão familiarizados com cracking de host e desenvolvimento de software.
Além disso, a modificação do sistema anfitrião pode trazer riscos de segurança e estabilidade, pode também afetar a utilização de serviços online e envolver os termos de serviço relevantes da Sony. Os desenvolvedores recomendam realizar pesquisas apenas em dispositivos de sua propriedade ou autorizados. Para usuários de console que o usam principalmente para jogos normais, especialmente aqueles que se conectam frequentemente à PlayStation Network, não há necessidade de hackear o dispositivo precipitadamente apenas para executar a IA local.
Do ponto de vista do hardware, a importância deste experimento não é apenas permitir que o console de jogo responda a perguntas. Ilustra ainda que a GPU e a memória de vídeo de alta velocidade instaladas em equipamentos de jogos para consumidores também podem realizar parte do trabalho normalmente realizado por equipamentos de computação de IA dedicados após a adaptação apropriada do software.
A inferência de modelos de linguagem grande geralmente é significativamente afetada pela capacidade de memória e largura de banda. Quando o modelo gera texto, ele precisa ler continuamente um grande número de parâmetros e manter caches sensíveis ao contexto. A arquitetura de memória unificada do PS5 permite que CPU e GPU compartilhem recursos de memória de alta velocidade, mas o próprio sistema também precisa ocupar parte dela, então o espaço disponível para os modelos é bem menor que a capacidade nominal de 16GB.
É por isso que os desenvolvedores devem resolver simultaneamente questões como quantização, gerenciamento de memória e interfaces de computação GPU. Simplesmente ter uma GPU poderosa o suficiente não garante que um modelo funcionará perfeitamente; se a arquitetura do modelo é suportada, se o driver pode realizar as operações de cálculo necessárias e se o sistema pode fornecer memória suficiente para o programa de inferência, tudo isso afetará o resultado final.
Este resultado também fornece uma referência interessante para a seleção de hardware local de IA. Tradicionalmente, os usuários que desejavam executar modelos de linguagem maiores em casa muitas vezes precisavam comprar um computador com placa gráfica discreta e pagar mais pela capacidade de memória e pelo custo geral da máquina. O PS5 já possui uma GPU relativamente poderosa e memória de alta velocidade, então os desenvolvedores esperam provar que o hardware de jogos existente também pode ser reutilizado sem a necessidade de comprar uma estação de trabalho de IA dedicada.
Mas isso não significa que o PS5 possa substituir completamente os computadores com IA. Seus recursos de hardware ainda são limitados por configurações fixas, espaço ocupado pelo sistema e ambientes de software não oficiais. Comparado com computadores com maior memória gráfica, drivers maduros e ferramentas de desenvolvimento ricas, o PS5 requer mais trabalho de adaptação subjacente para executar modelos grandes, e os usuários não podem atualizar livremente a placa gráfica ou expandir a memória gráfica como computadores comuns de IA.
Do ponto de vista prático, este tipo de projeto é atualmente mais adequado para entusiastas de tecnologia, desenvolvedores de código aberto e usuários interessados em IA local para estudar raciocínio de modelo, computação GPU e ambientes operacionais embarcados. Para empresas que precisam executar de forma estável serviços de IA em nível de produção, servidores GPU dedicados ou computadores otimizados por pilhas de software maduras são ainda mais adequados.
O desenvolvimento do PS5LM também reflete uma tendência no ecossistema de IA de código aberto: estruturas de inferência de modelos e modelos de peso aberto reduziram gradualmente o limite para executar inteligência artificial, enquanto os desenvolvedores da comunidade continuam tentando portar essas ferramentas para diferentes plataformas de hardware. No passado, os consoles de jogos eram vistos principalmente como dispositivos fechados de entretenimento; agora, graças aos esforços das comunidades de cracking e engenharia reversa, eles também se tornaram plataformas para explorar a computação GPU e aplicações nativas de inteligência artificial.
Em geral, é uma tentativa técnica representativa de permitir que um PS5 crackeado execute um grande modelo de linguagem com 27 bilhões de parâmetros a uma velocidade de cerca de 20 tokens por segundo. Ele demonstra o uso potencial do hardware de console de jogos e também prova que, por meio da adaptação de software e da compactação de modelos, modelos de linguagem de uma determinada escala podem ser executados em dispositivos de IA não tradicionais. No entanto, esta conquista ainda é um projeto comunitário que depende de um ambiente crackeado, e ainda há uma distância considerável entre ela e as funções oficiais que usuários comuns podem usar sem operações complicadas.
Comentários