Resumo:
O Google anunciou hoje oficialmente seu mais recente avanço no campo de interação de voz nativa de ponta a ponta, lançando uma nova geração de modelos grandes de voz em tempo real Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking personalizados para tarefas difíceis.
Esses dois modelos representam um grande avanço no sistema de tecnologia de áudio para áudio nativo do Google. Eles não apenas levam o atraso e a naturalidade da conversa em tempo real a novos patamares, mas também alcançam pela primeira vez capacidades profundas de raciocínio em várias etapas em fluxos de voz de baixa latência, mudando completamente o paradigma de aplicação da IA de voz em cenários profissionais complexos.
Na arquitetura de interação de voz convencional anterior, os sistemas de IA geralmente precisavam fazer um compromisso entre "diálogo superficial de resposta rápida" e "pensamento profundo de longo prazo". Enfrentar problemas difíceis muitas vezes exigia que os usuários suportassem longos períodos de espera silenciosa. Gemini 3.8 Live lançado pelo Google se concentra na otimização da conversa ultrarrápida e da experiência de interação diária de streaming. Ele pode fornecer aos usuários comunicação de voz em tempo real extremamente suave e de nível humano, com flutuações de entonação mais sensíveis, interrupções naturais e recursos de compreensão de contexto. O Gemini 3.8 Live Extended Thinking, lançado em sua base, foi fundamentalmente atualizado para fluxos de negócios altamente complexos. Este modelo dá à IA a capacidade de "pensar enquanto fala" (Pense enquanto fala) em segundo plano, permitindo que o sistema execute simultaneamente desmontagem lógica complexa em várias etapas, depuração de código ou diagnóstico técnico em segundo plano, mantendo um diálogo coerente em tempo real, sem a necessidade de interromper abruptamente o ritmo da conversa ao encontrar problemas difíceis.
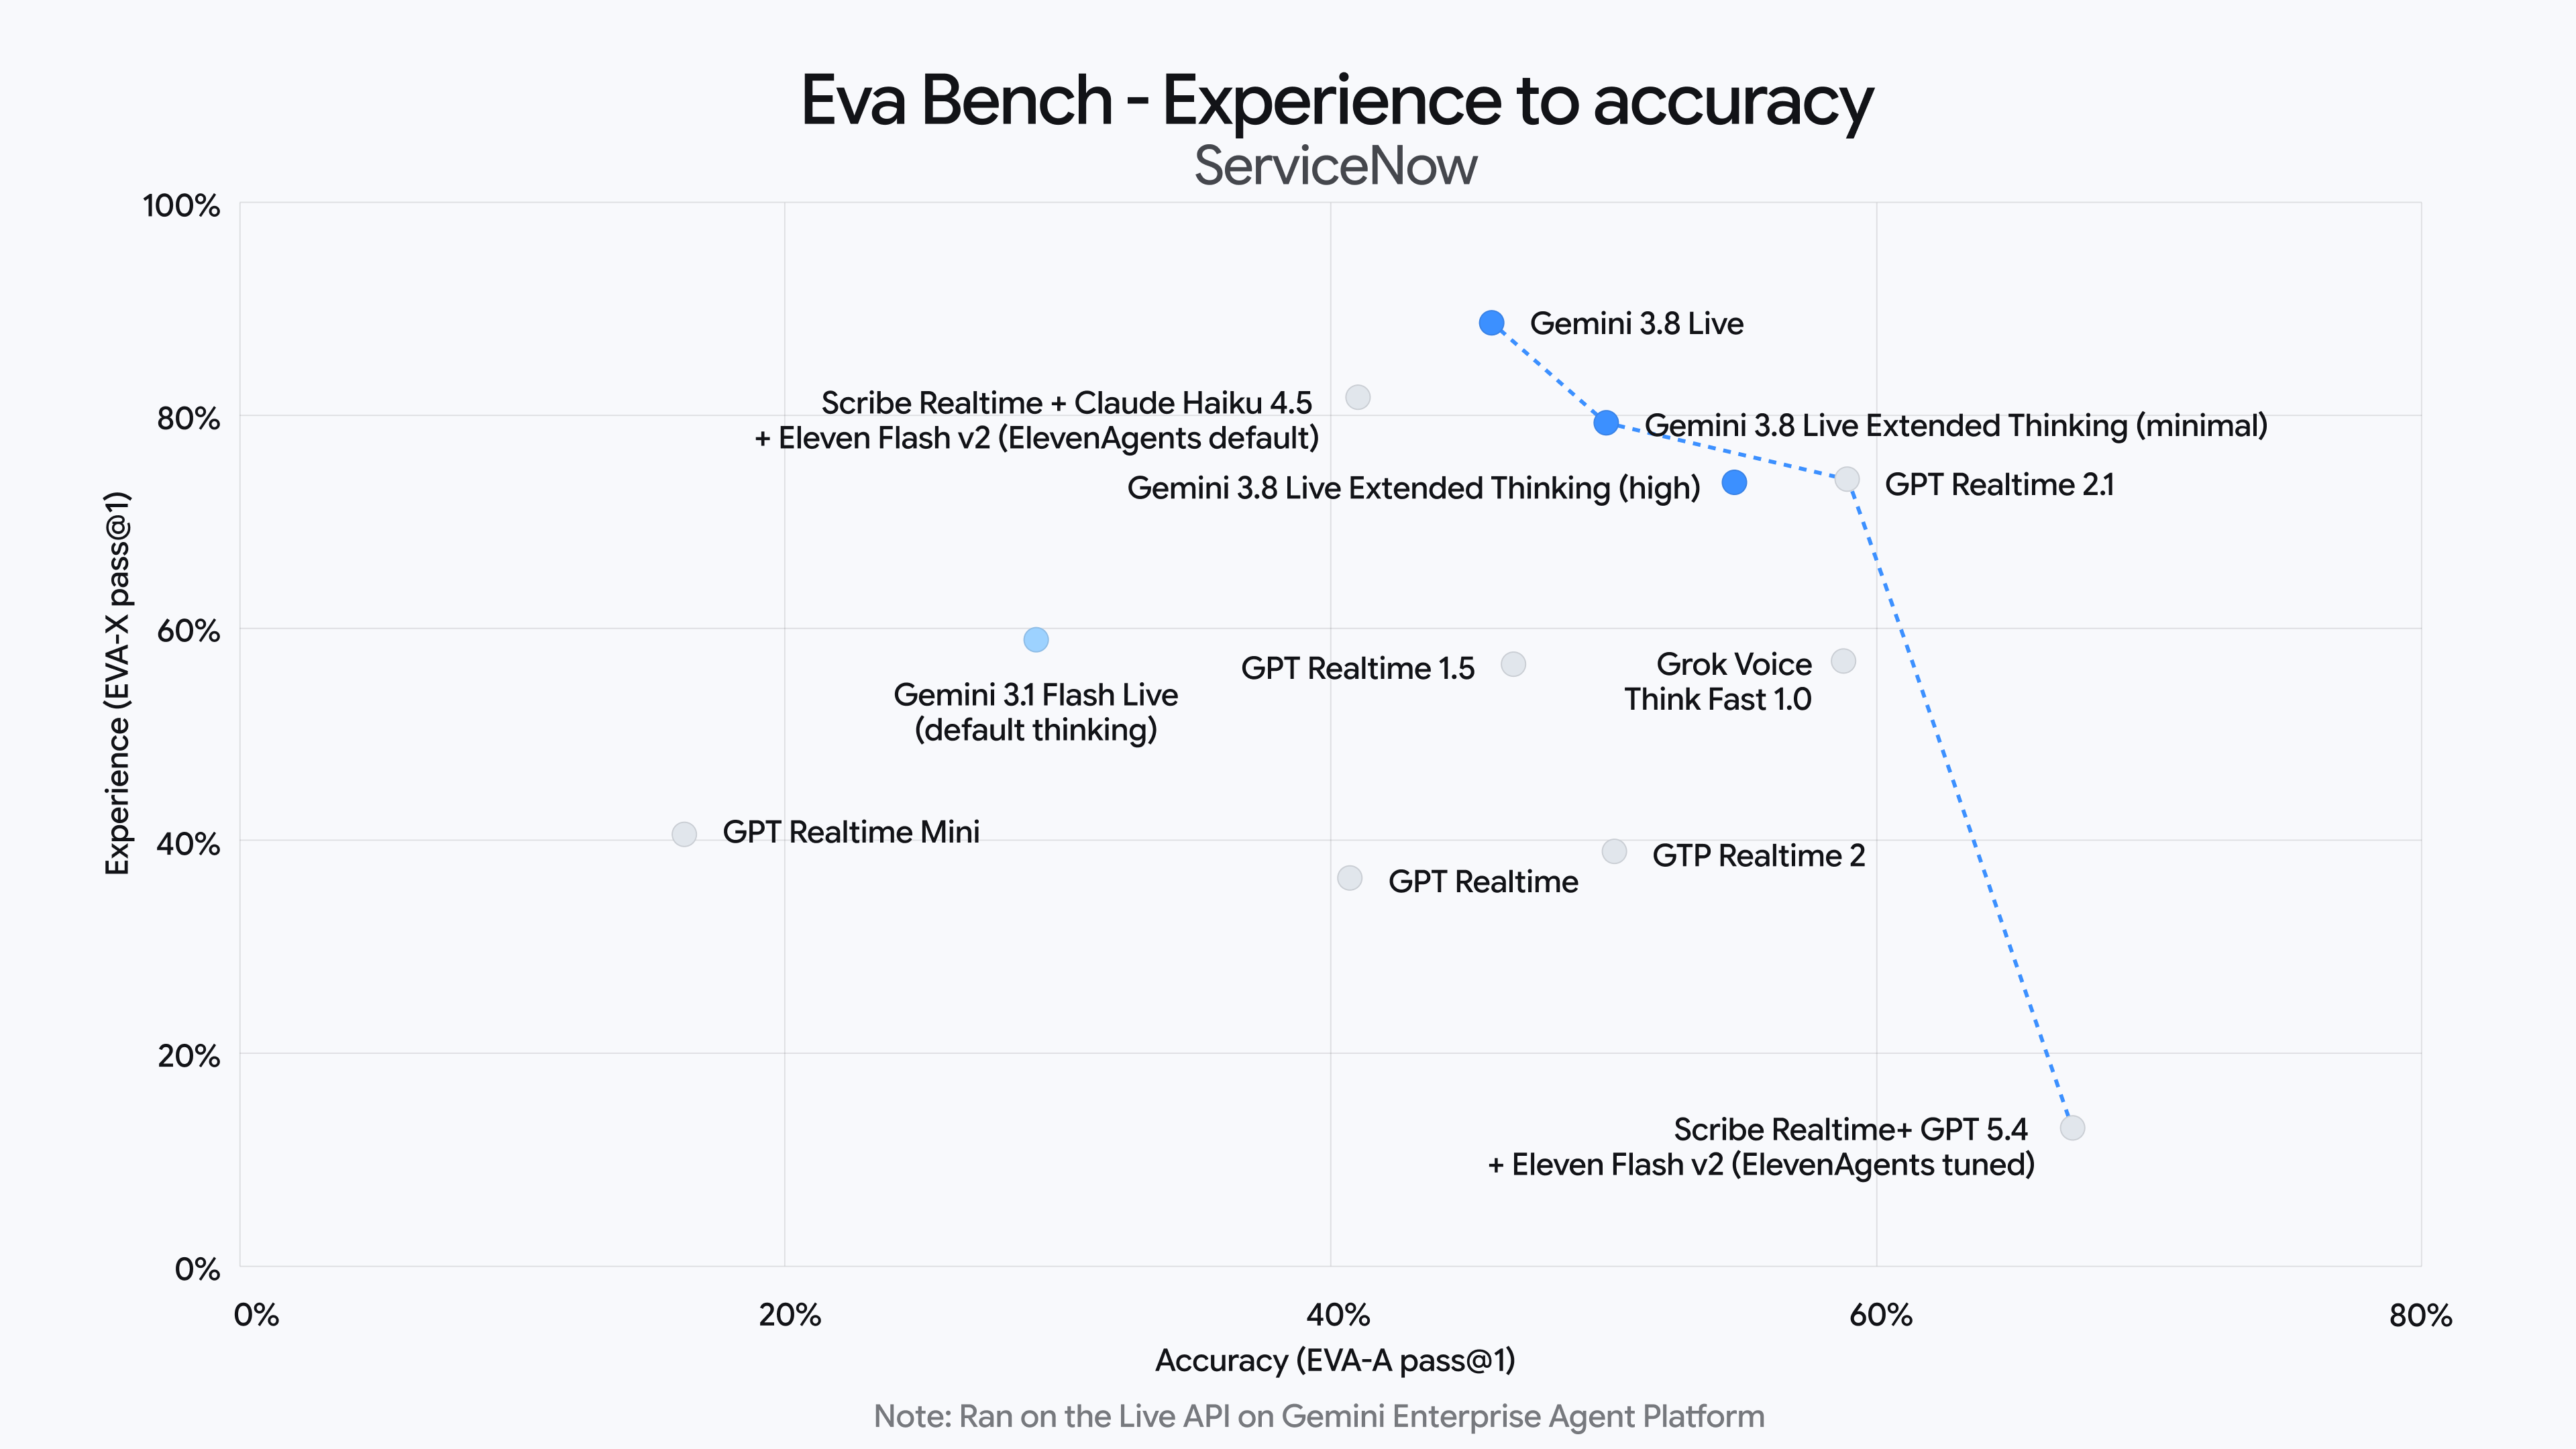
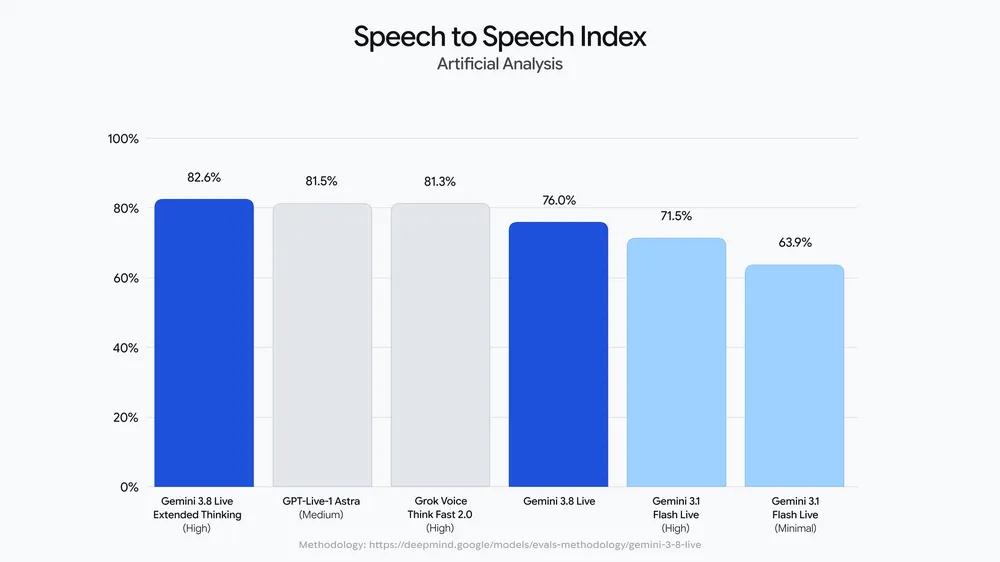
Em termos de aplicação prática, a nova geração de modelos da série Live expandirá significativamente os limites do serviço de assistentes de voz. Além das conversas naturais diárias, as versões Gemini 3.8 Live e de raciocínio estendido demonstraram desempenho significativamente melhor do que as versões anteriores em cenários com altas demandas intelectuais, como solução de problemas passo a passo em tempo real, derivação matemática complexa, tutoria simultânea de língua estrangeira em tempo real e execução de instruções de streaming multitarefa, ficando em primeiro lugar em vários benchmarks do setor multimodal e de raciocínio de fala.
Para desenvolvedores e usuários corporativos, o Google anunciou que os recursos relevantes do modelo estarão oficialmente abertos para acesso por meio da API Gemini e do Google AI Studio a partir de agora. Os desenvolvedores podem chamar diretamente essa interface API de áudio nativa de latência extremamente baixa para criar rapidamente serviços de agente de voz full-duplex de próxima geração com recursos de raciocínio de alta ordem em formas de produtos, como hardware inteligente, atendimento ao cliente, assistência de programação em tempo real e escritório colaborativo.
Comentários