
Resumo:
Da mesma forma, para realizar todas as 10 tarefas de programação corretamente, a nova versão do DeepSeek custou menos de 40% do Claude Opus 5.5, e a espera média para cada tarefa foi de dois minutos a mais.
Em 17 de outubro, o DeepSeek lançou o V4.1-Flash-1017 e o preço permaneceu inalterado. Após seu lançamento, os desenvolvedores já o usaram para criar jogos, construir páginas da web e modificar códigos.
Para testar seu nível real, o desenvolvedor Ibragim Badertdinov selecionou 10 tarefas de seu trabalho diário e executou modelos diferentes três vezes no mesmo conjunto de ferramentas de programação, usando a engrenagem de alta inferência do DeepSeek V4.1-Flash-1017 e a engrenagem baixa do Opus 5.5 e GPT-6 Astra.
Após o teste real, todos os três modelos passaram no teste, mas a diferença foi ampliada pelo faturamento e pelo consumo de tempo: o DeepSeek gastou apenas uma média de US$ 0,045 por tarefa, o que foi muito inferior aos US$ 0,1168 do Opus e aos aproximadamente US$ 0,26 do GPT-6 Astra; no entanto, Opus e GPT levaram apenas 37 segundos e 55 segundos para serem concluídos, respectivamente, mas o DeepSeek levou 2 minutos e 38 segundos.
Essas 10 tarefas são todas de pequena escala. Como projeto completo, a diferença entre DeepSeek, GPT e Claude é apenas uma questão de esperar um pouco mais?
Aprovado em todas as dez questões em 01, DeepSeek economiza dinheiro, Opus economiza tempo
Os tópicos escolhidos por Ibragim vieram de cerca de três meses de registros próprios de uso de agentes, envolvendo processamento de dados, back-end, front-end e implantação, usando Python e TypeScript. Ele escolheu as tarefas que normalmente poderia concluir em menos de uma hora e depois adicionou programas de verificação automática a elas.
Um exemplo simplificado que ele divulgou é importar um lote de dados para uma tabela de dados local. Além de importar com sucesso, o programa também deve ignorar registros duplicados, rejeitar números conflitantes e relatar dados insatisfatórios; ao substituir dados antigos, ele não pode destruir o conteúdo original no meio da escrita. O teste verificará entradas vazias, conflitos de dados, arquivos originais corrompidos, etc.
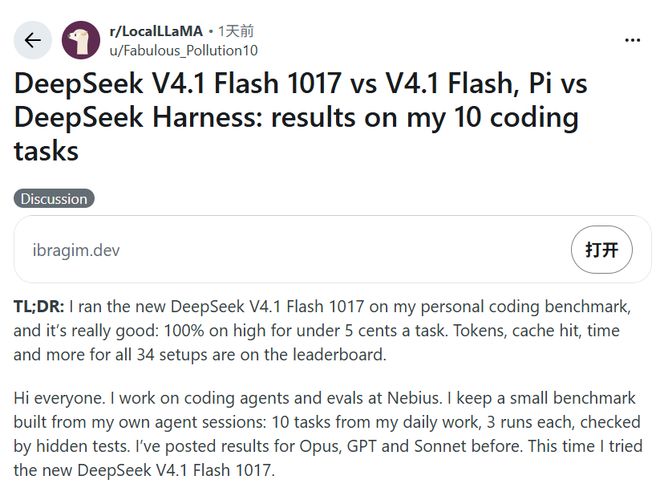
Todos os três modelos passaram nessas verificações, mas o DeepSeek realizou mais etapas.
Também rodando na ferramenta de programação Pi, o DeepSeek dá uma média de 15,3 passos por tarefa, o Opus dá 3,7 passos e o GPT-6 Astra dá 6,5 passos. O uso total de tokens do DeepSeek é de cerca de 547.000, e o do Opus é de cerca de 31.000.Eu uso muito, mas a conta não sobe. Ibragim explicou que quase todas as entradas do DeepSeek atingiram o cache, e a taxa de acerto do cache registrado atingiu 97,9%. Os 547.000 tokens não foram escritos recentemente pelo modelo. Uma resposta tão longa incluía conteúdo enviado repetidamente em diversas rodadas de ligações. Entradas baratas em cache mantiveram o custo deste teste abaixo de 5 centavos por teste.
Para os usuários, o impacto desses dois minutos depende de eles estarem esperando na frente da tela. Depois de entregar a tarefa e depois fazer outras coisas, esperar pode não ser um obstáculo; se você quiser fazer a próxima rodada de modificações imediatamente após ver os resultados, a velocidade do Opus e do GPT neste conjunto de testes é mais útil. O que é comparado aqui é o custo de conclusão de tarefas por meio da API, não a mensalidade dos pacotes de assinatura ChatGPT ou Claude.
A nova versão também foi melhorada em comparação com a versão anterior. Ibragim usou anteriormente a configuração de inferência mais alta da versão de setembro do Flash para testar e passou 28 vezes em 30 execuções, com tempo médio de 4 minutos e 30 segundos para cada teste. Desta vez, utilizando a nova versão da configuração high-end, passou todas as 30 vezes, e o tempo foi reduzido para 2 minutos e 38 segundos.
02 Construí um BMW por US$ 0,38, mas levei 40 minutos para criar uma página da web comum
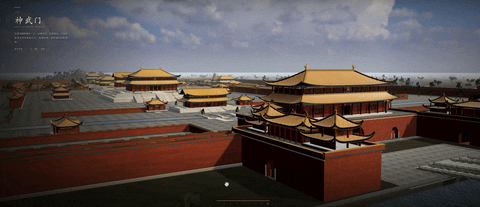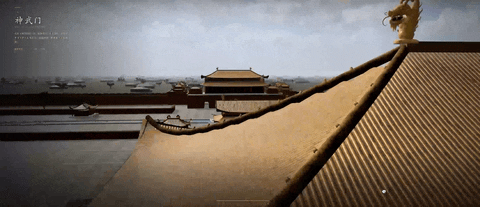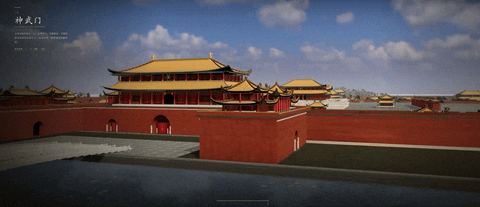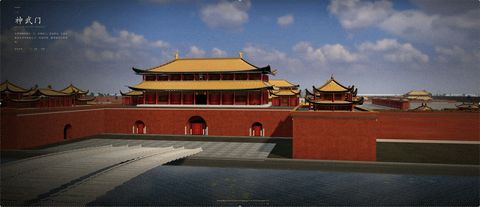
O que o DeepSeek quer mostrar desta vez não é apenas preencher uma função. Os casos lançados oficialmente incluem a cena 3D da Cidade Proibida, um jogo de corrida na web e uma demonstração de reprodução de "Portal 2" produzida com Godot. A empresa afirma que a nova versão melhora a capacidade de concluir projetos do zero por meio de aprendizado reforçado com autofeedback.
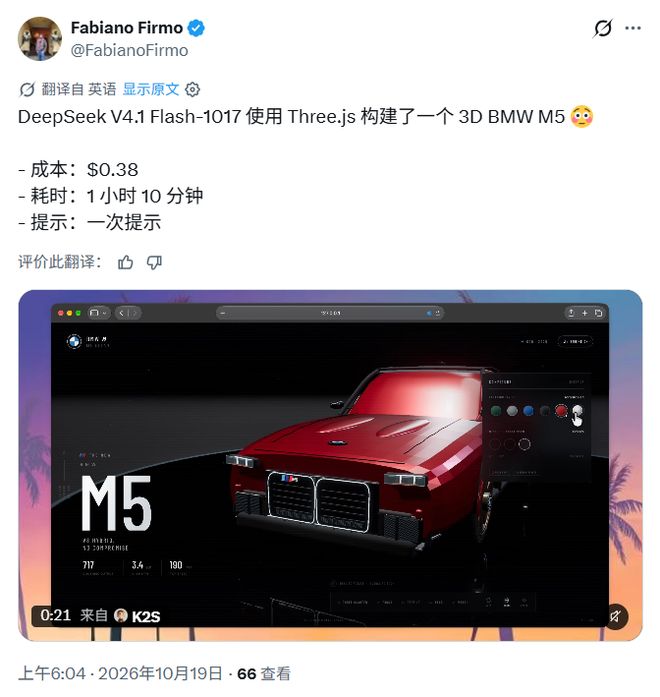
O desenvolvedor Fabiano Firmo pediu que ele usasse o Three.js para criar um modelo 3D do BMW M5. Na foto que ele postou, um carro vermelho aparece na página do display, com opções de cores ao lado.
Segundo ele, desta vez só deu um lembrete, que custou US$ 0,38 e levou 1 hora e 10 minutos.
Alguns usuários também demonstraram um jogo semelhante ao "Rocket League", onde carros jogam futebol em campo. O usuário do X Markets & Mayhem comentou que os efeitos físicos funcionam normalmente e é jogável, mas ainda precisa de polimento. Para alguém que deseja primeiro criar um protótipo de uma página da web ou jogo, essas demonstrações são mais fáceis de ver do que modelos de notas de exames.
No entanto, estar disposto a esperar mais de uma hora para ver um carro 3D não significa que você esteja disposto a esperar tanto tempo para criar uma página web comum.
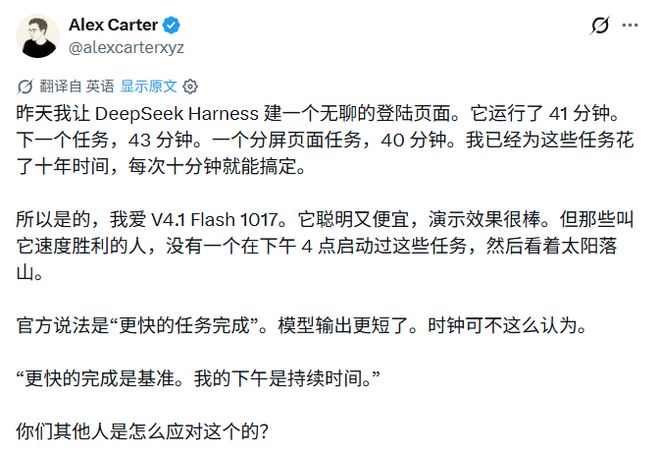
O desenvolvedor Alex Carter disse que pediu ao DeepSeek Harness para criar uma landing page comum, que levou 41 minutos para ser executada; as próximas duas tarefas da página da web levaram mais 43 minutos e 40 minutos, respectivamente. Ele achou o modelo inteligente, barato e bem apresentado, mas as páginas exigiam anos de trabalho e geralmente podiam ser concluídas em dez minutos.
O desenvolvedor unbug também tem uma sensação semelhante: o modelo se tornou mais inteligente, mas é fácil pensar muito e atrasar a ação. Outro usuário, Elshayib, enfatizou que sua reclamação não era sobre o número de palavras emitidas por segundo, mas que o modelo demorava muito para pensar antes de agir.
Um teste da plataforma API OmniaKey registrou esse longo resultado de raciocínio. Requer a nova versão do Flash para escrever um programa que calcule expressões de acordo com as regras de operação do Python e não possa chamar ferramentas de análise prontas. O modelo levou cerca de 88 segundos para passar em todos os 30 casos de uso de inspeção; dos cerca de 20.700 tokens produzidos, aproximadamente 19.700 foram considerados conteúdo.
Mas o Flash não é lento para todas as tarefas. Em outro teste do OmniaKey, ele extraiu 10 campos de um e-mail de fatura misturado em alemão e inglês e respondeu todos corretamente em 5,2 segundos; a chamada da ferramenta para consultar o clima e a hora em duas cidades foi concluída em 2,6 segundos. A própria OmniaKey vende a API do modelo e cada conjunto de testes será executado apenas uma vez.
Esses exemplos de modelagem da BMW e páginas de destino não são comparações dos três modelos sobre o mesmo assunto. A qualidade do produto final do deepSeek e quantas vezes ele será revisado posteriormente ainda precisa ser comparado com GPT e Claude sob os mesmos requisitos.
03 Depois de abaixar a marcha, ficou um minuto mais rápido e houve mais três falhas
Como a configuração de inferência alta leva muito tempo, o que acontecerá se ela for reduzida? Ibragim também testou.
No Pi, depois que a nova versão do DeepSeek é ajustada para a configuração baixa, o tempo médio por item é reduzido de 2 minutos e 38 segundos para 1 minuto e 31 segundos, e o custo é reduzido de US$ 0,045 para US$ 0,0257. No entanto, 3 de 30 execuções falharam.
Todas as passagens obtidas em níveis elevados não podem ser mantidas intactas.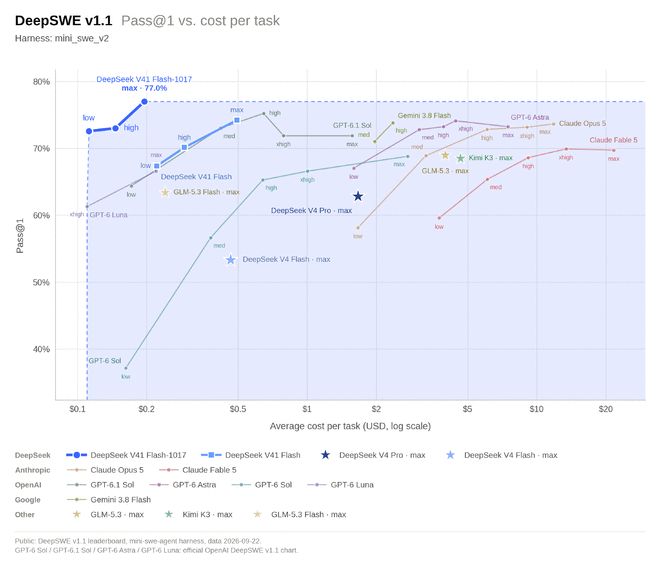
Nesse nível baixo, mudei para o Harness do DeepSeek e os resultados mudaram novamente: ele passou 29 vezes em 30 execuções, duas a mais que Pi. De acordo com os registros de Ibragim, o ambiente oficial da ferramenta ajudou o modelo a lidar com uma condição de contorno que foi perdida no Pi.
Os dois conjuntos de ferramentas funcionam de maneira diferente com modelos. DeepSeek Harness fornece ferramentas diretas para leitura e edição de arquivos, enquanto Pi permite principalmente que o modelo seja operado por meio da linha de comando; as palavras de prompt do sistema do primeiro também são mais longas. Desta vez, após a troca de ferramentas, o uso de tokens aumentou cerca de 75% e o tempo médio gasto aumentou de 1 minuto e 31 segundos para 1 minuto e 53 segundos. Em ambos os conjuntos de ferramentas, apenas 9 tarefas podem ser concluídas três vezes consecutivas.
Para o mesmo modelo, se você alterar a engrenagem de inferência e o conjunto de ferramentas, a velocidade, o custo e o sucesso mudarão.
Você só vê os resultados postados por outras pessoas, mas também precisa saber quais configurações elas usaram.DeepSeek também mencionou claramente quando foi lançado que tinha ferramentas otimizadas como DeepSeek Harness, Tencent CodeBuddy e WorkBuddy, e recomendou aos usuários do Harness que atualizassem para v0.2.1-rc.1 ou superior.
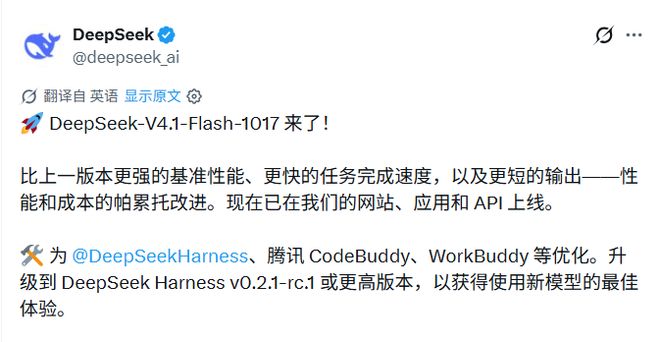
Esta atualização foi lançada em páginas da web, aplicativos e APIs. As chamadas de API ainda usam deepseek-flash e o preço permanece inalterado; os novos pesos do modelo também foram divulgados sob o protocolo do MIT.
No entanto, o teste de programação anterior foi concluído conectando o modelo a uma ferramenta que pode ler arquivos, modificar código e executar verificações. Pedir para ele escrever um código na janela de bate-papo é diferente de pedir para ele assumir um projeto. O ambiente de uso é diferente.
04Para o mesmo conjunto de perguntas, GPT e Claude podem ser mais baratos
Opus e Astra são os carros-chefe das duas empresas, e OpenAI e Anthropic também possuem modelos mais baratos.
No mesmo conjunto de testes do Ibragim, o xhigh gear do GPT-6 Luna e o high gear do Haiku 5.5 passaram 30 vezes. O custo médio de cada item foi de apenas US$ 0,0145 e US$ 0,0208 respectivamente, o que é inferior ao DeepSeek.
O consumo médio de tempo dos dois é de 2 minutos e 46 segundos e 2 minutos e 08 segundos respectivamente.Isso faz com que a escolha não seja mais apenas “GPT caro, Claude” ou “DeepSeek barato”. Pessoas que já usam Luna ou Haiku para realizar pequenas tarefas podem não conseguir economizar mais dinheiro mudando para o Flash.
Tarefas mais difíceis mudam a questão de quanto tempo esperar para saber se você pode confiar nos resultados. O usuário do X, Yum, disse que depois de experimentar a nova versão, ele ainda está mais preocupado com as alucinações, especialmente a reconstrução e modificação da arquitetura em vários arquivos. Ele faria com que outro modelo verificasse as alterações, em vez de deixar o DeepSeek aprovar sua própria solução. Esta é a sua escolha de uso, não um teste sobre a mesma questão para provar que GPT ou Claude são mais confiáveis.
Portanto, o progresso mais sólido atualmente é que a nova versão do DeepSeek forneceu os mesmos resultados de inspeção que o modelo principal em um lote de pequenas tarefas de programação reais.
Quantas correções manuais são necessárias em grandes projetos e se os problemas podem ser reparados determinarão até onde essa substituição pode ir.
Ainda há muito trabalho entre construir um carro 3D e manter um projeto a longo prazo.Ibragim também se prepara para dificultar essa prova. Ele disse no final do post que o próximo passo seria selecionar um grupo de tarefas muito mais difíceis e comparar diferentes ferramentas e modelos.
Comentários