Resumo:
A controvérsia em torno da legalidade dos dados generativos de treinamento de inteligência artificial esquentou novamente recentemente. Um documento judicial aberto no processo de direitos autorais do New York Times mostra que um diretor sênior de pesquisa da Microsoft certa vez descreveu em uma discussão interna que o atual método de treinamento de grandes modelos de linguagem pode ser “o maior roubo de trabalho na história da humanidade”. Declarações relacionadas atraíram ampla atenção na indústria.
As observações expostas desta vez vieram de Brent Hecht, diretor de ciência aplicada da Microsoft. De acordo com os últimos documentos legais públicos, ao discutir o uso massivo de conteúdo da Internet pela Microsoft, OpenAI e outras empresas de inteligência artificial para treinar modelos, Hecht certa vez chamou esse processo de "um roubo surpreendente em escala sem precedentes" e afirmou ainda que este pode ser "o maior roubo de trabalho na história da humanidade".
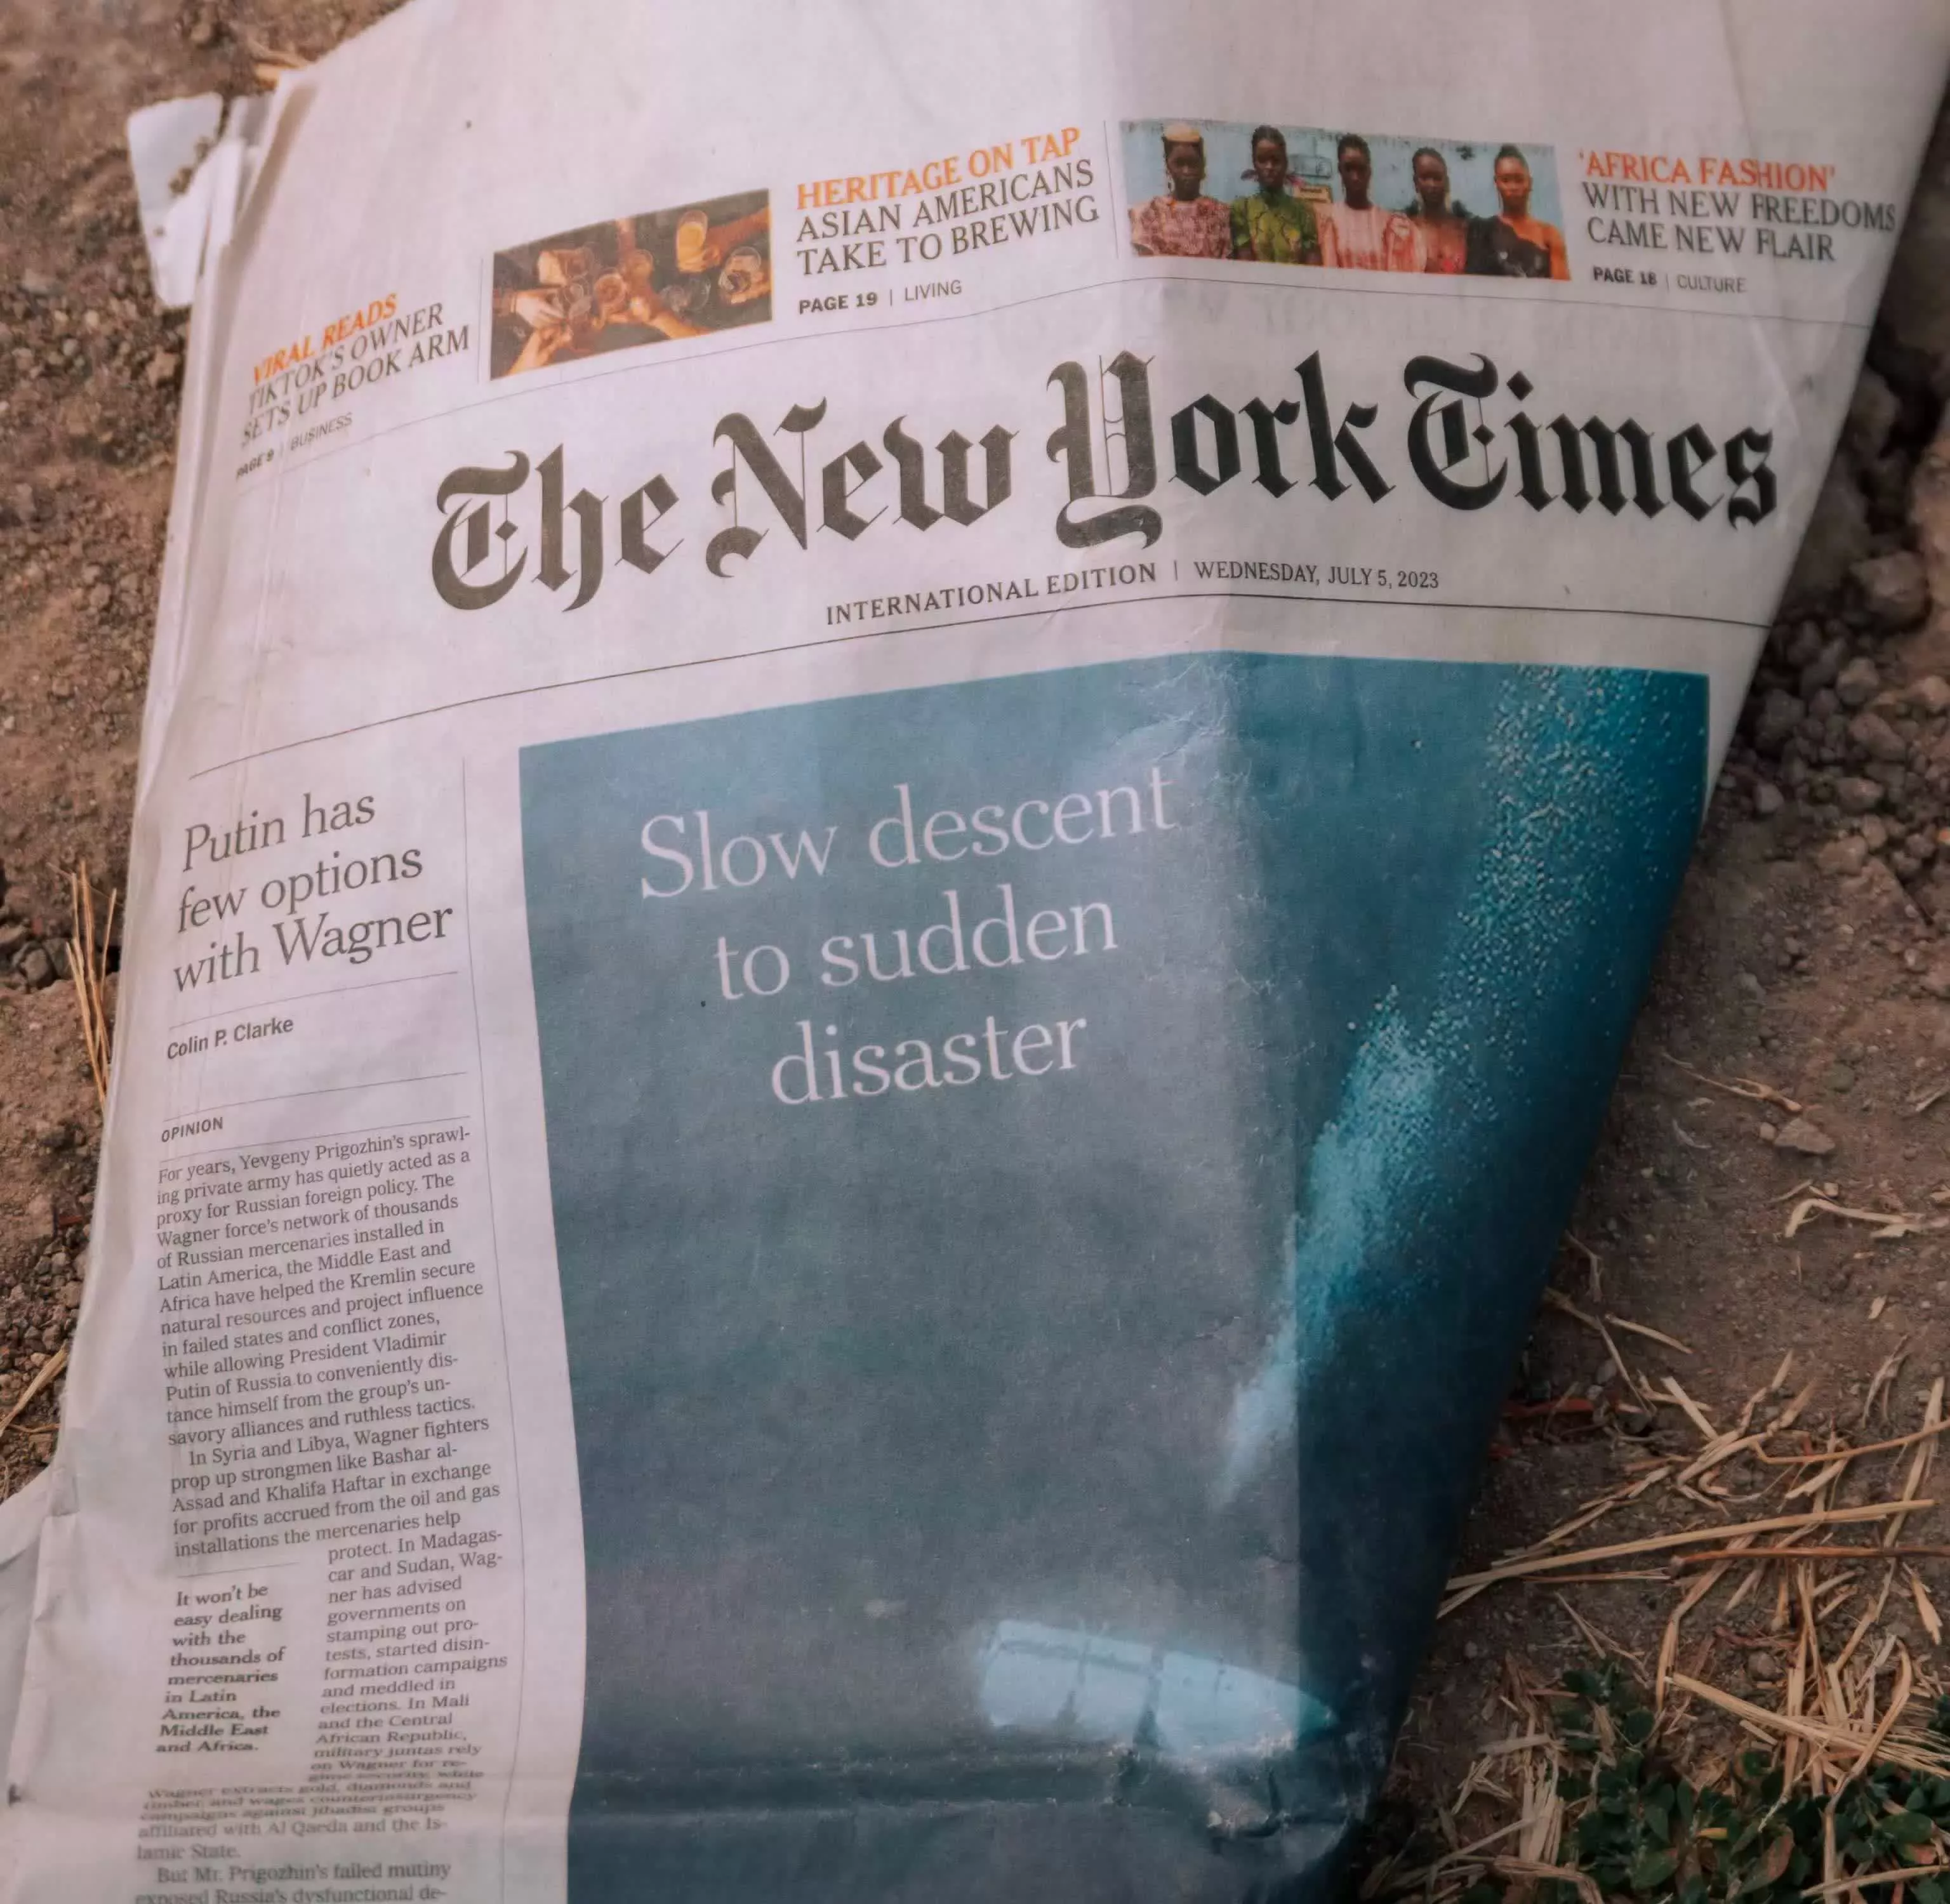
Este conteúdo aparece em uma ação judicial de direitos autorais movida pelo The New York Times e outras publicações de notícias contra a Microsoft e a OpenAI. Os demandantes acreditam que as duas empresas usaram reportagens e outros conteúdos protegidos por direitos autorais para treinar modelos de inteligência artificial sem autorização e usá-los para desenvolver produtos comerciais.
A Microsoft e a OpenAI sempre aderiram à sua postura de “uso justo”. As duas empresas acreditam que o processo de treinamento do modelo é semelhante ao da leitura de livros pelos alunos para adquirir conhecimentos e se enquadra no escopo do uso justo. Argumentam também que o conteúdo gerado pela IA transformou suficientemente o material original para não constituir cópia direta.
No entanto, alguns registos de comunicação interna nos documentos recentemente abertos parecem estar em claro contraste com esta posição pública.
Os documentos mostram que a Hecht certa vez acreditou que, se quisessem vencer o processo, as empresas envolvidas talvez precisassem "zombar completamente do conceito de uso justo". Esta afirmação é considerada uma prova importante pelo demandante e é usada para questionar a lógica de defesa de direitos autorais que as empresas de inteligência artificial há muito aderem.
Ao mesmo tempo, o documento também divulgou algumas discussões internas da OpenAI. Um dos registros mostra o cofundador da OpenAI, Greg Brockman, admitindo que quando o modelo foi exposto ao conteúdo do New York Times, o ChatGPT foi de fato capaz de prever e continuar frases em artigos relacionados. Esse tipo de conteúdo é utilizado pelos demandantes para comprovar que o modelo tem a capacidade de reproduzir a obra original, ao invés de apenas abstrair as informações aprendidas.
Os documentos do processo também revelaram que as preocupações de Hecht sobre o desenvolvimento a longo prazo da indústria de inteligência artificial não se limitam à questão dos direitos autorais em si. Certa vez, ele propôs o chamado conceito de “ciclo do Juízo Final” em outro documento de apresentação interna.
Seguindo esta lógica, os motores de resposta de inteligência artificial estão gradualmente a reduzir a necessidade dos utilizadores de visitar websites de notícias, resultando num declínio no tráfego mediático e nas receitas comerciais. À medida que mais e mais organizações de produção de conteúdos perdem a sua viabilidade, as fontes de informação de alta qualidade para os sistemas de inteligência artificial aprenderem no futuro também diminuirão, o que acabará por prejudicar o modelo e todo o ecossistema da Internet.
Ele ressaltou em documentos internos que é extremamente raro que um produto ameace a base econômica de seus principais fornecedores, mas a indústria de inteligência artificial está atualmente nesta situação. Dado que as organizações noticiosas e os criadores de conteúdos são fontes importantes de informação para os modelos de IA, quando estes grupos são afetados, toda a cadeia de fornecimento de conteúdos fica em risco.
O demandante também citou dados internos da Microsoft e alegou que os sistemas de atendimento de IA, como o Copilot, tiveram um impacto significativo no tráfego de alguns sites de notícias. Em alguns casos, a proporção de utilizadores que clicam para entrar na página do New York Times caiu mais de 90% em comparação com os resultados de pesquisa tradicionais.
Na verdade, a disputa sobre a fonte dos dados de treinamento tornou-se um dos desafios jurídicos mais importantes na atual indústria de inteligência artificial.
A OpenAI já declarou publicamente que é uma tarefa quase impossível treinar sistemas avançados de inteligência artificial sem qualquer contato com conteúdo protegido por direitos autorais. O ex-executivo da Meta, Nick Clegg, também fez uma declaração semelhante, acreditando que se as regras tradicionais de direitos autorais forem estritamente seguidas, será difícil manter o desenvolvimento de muitos sistemas de IA atuais.
Ao mesmo tempo, muitas empresas, incluindo Microsoft, Meta e outras empresas de tecnologia, continuam a enfrentar críticas do mundo exterior devido a problemas com a fonte dos dados de treinamento. Algumas empresas foram acusadas de utilizar conteúdo de utilizadores, bibliotecas de códigos, artigos, imagens e outros recursos online para treinar modelos, muitas vezes sem autorização explícita ou compensação dos criadores relevantes.
À medida que o processo do New York Times continua, cada vez mais documentos internos são tornados públicos. Os membros da indústria acreditam que estes materiais não estão apenas relacionados com o resultado do litígio de direitos de autor enfrentado pela Microsoft e pela OpenAI, mas também podem afectar a futura direcção regulamentar global sobre a formação em inteligência artificial, a protecção da propriedade intelectual e a distribuição de direitos e interesses dos produtores de conteúdos.
Atualmente, os casos relevantes ainda estão em análise. Independentemente do veredicto final, esta disputa legal em torno da legalidade do treinamento em inteligência artificial está se tornando um marco importante na determinação das futuras regras de desenvolvimento da indústria de IA.
Comentários