
Resumo:
À medida que a inteligência artificial evolui de chatbots tradicionais para agentes (AI Agents) que podem planejar tarefas, chamar ferramentas e executar fluxos de trabalho complexos de forma autônoma, as necessidades de computação dos data centers também estão mudando. A AMD lançou oficialmente o design de referência de computação de IA em nível de rack Helion em 12 de outubro de 2026, propondo uma nova solução de infraestrutura que leva a CPU como núcleo e pode ser emparelhada com GPUs de acordo com as necessidades.
Sua configuração pura de CPU pode integrar até 32.768 núcleos de processador AMD EPYC e foi projetada para fornecer um ambiente de execução para agentes de IA em grande escala, em vez de concentrar todos os recursos de computação em aceleradores de GPU.
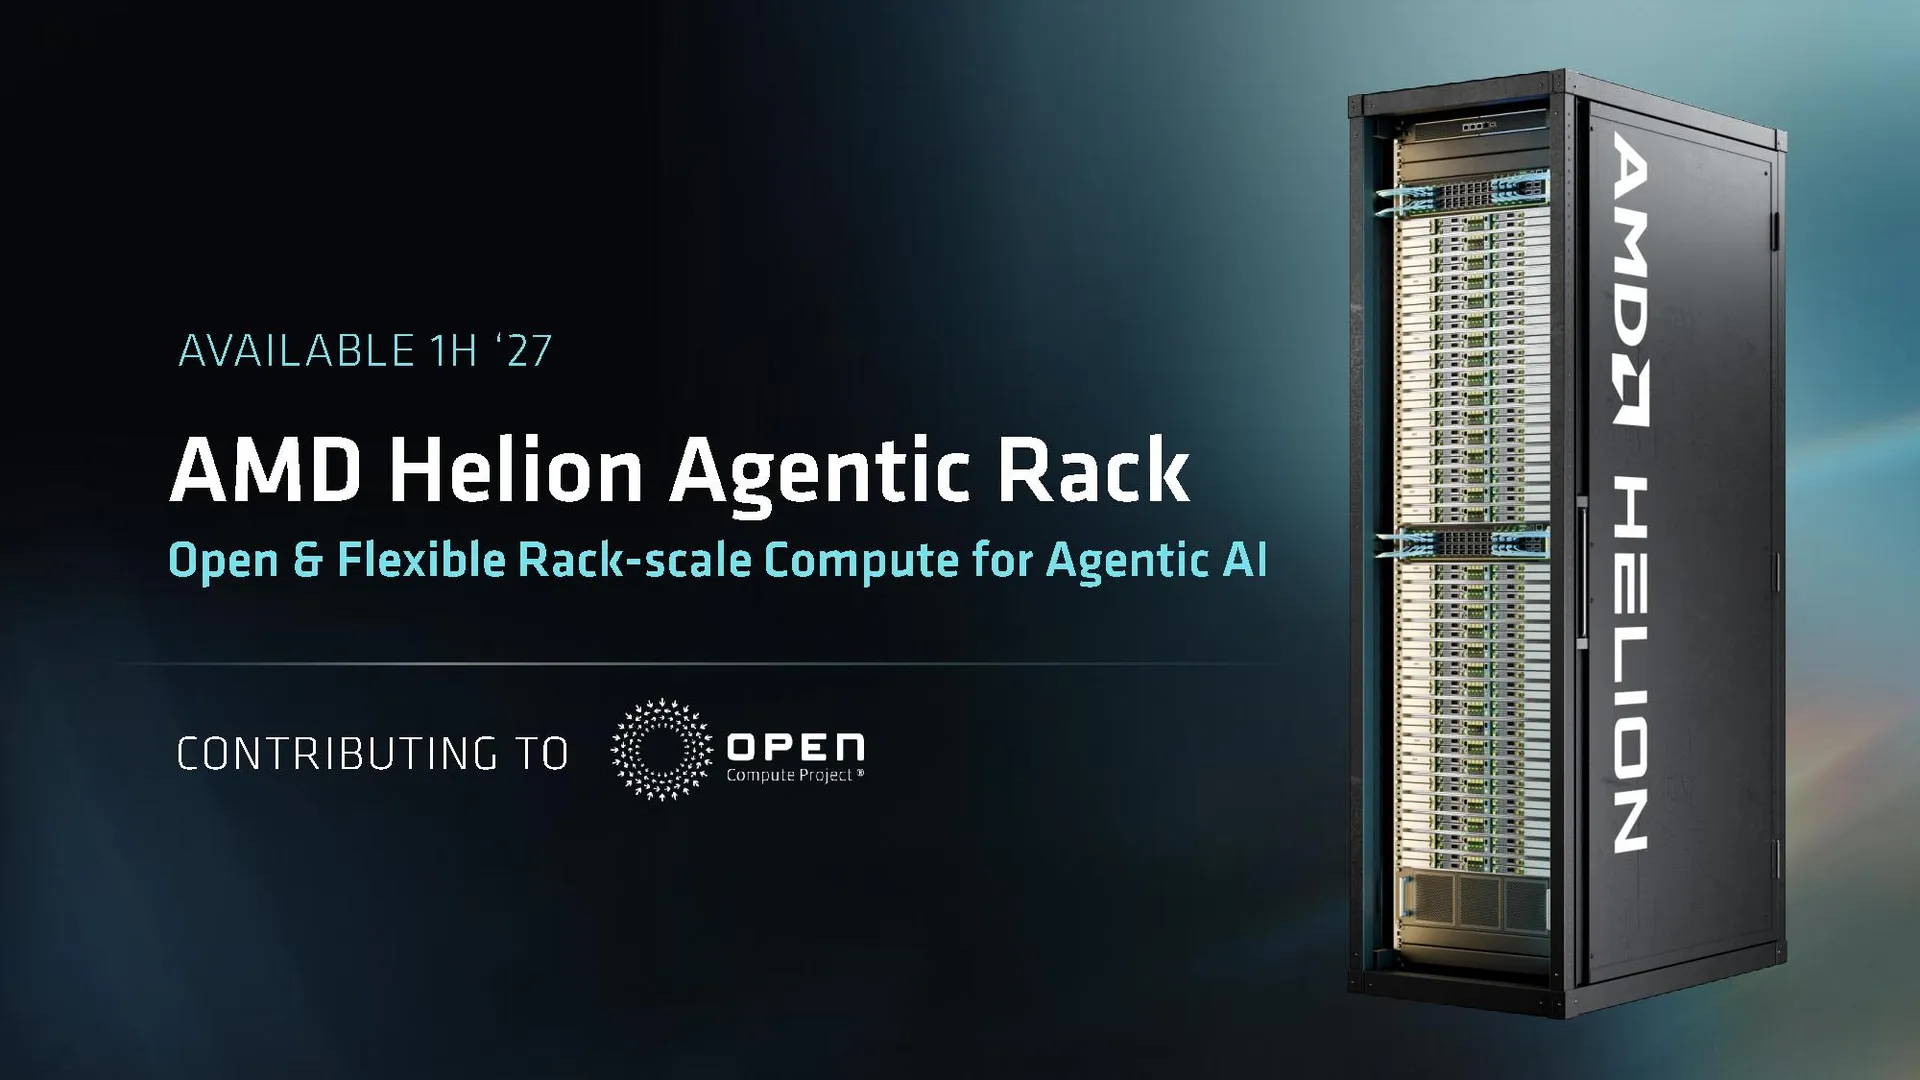
O Helion lançado pela AMD desta vez não é um chip independente, nem um produto de servidor completo que os usuários possam comprar diretamente, mas um design de referência de rack aberto para data centers. A AMD planeja contribuir com especificações relevantes para o Open Compute Project (OCP) para posterior desenvolvimento e adoção pelos parceiros. Fabricantes como Dell, Hewlett Packard Enterprise, Lenovo, AMD e Foxconn participarão do desenvolvimento de sistemas relacionados, e a configuração Helion criada por parceiros está prevista para ser lançada em novembro de 2026.
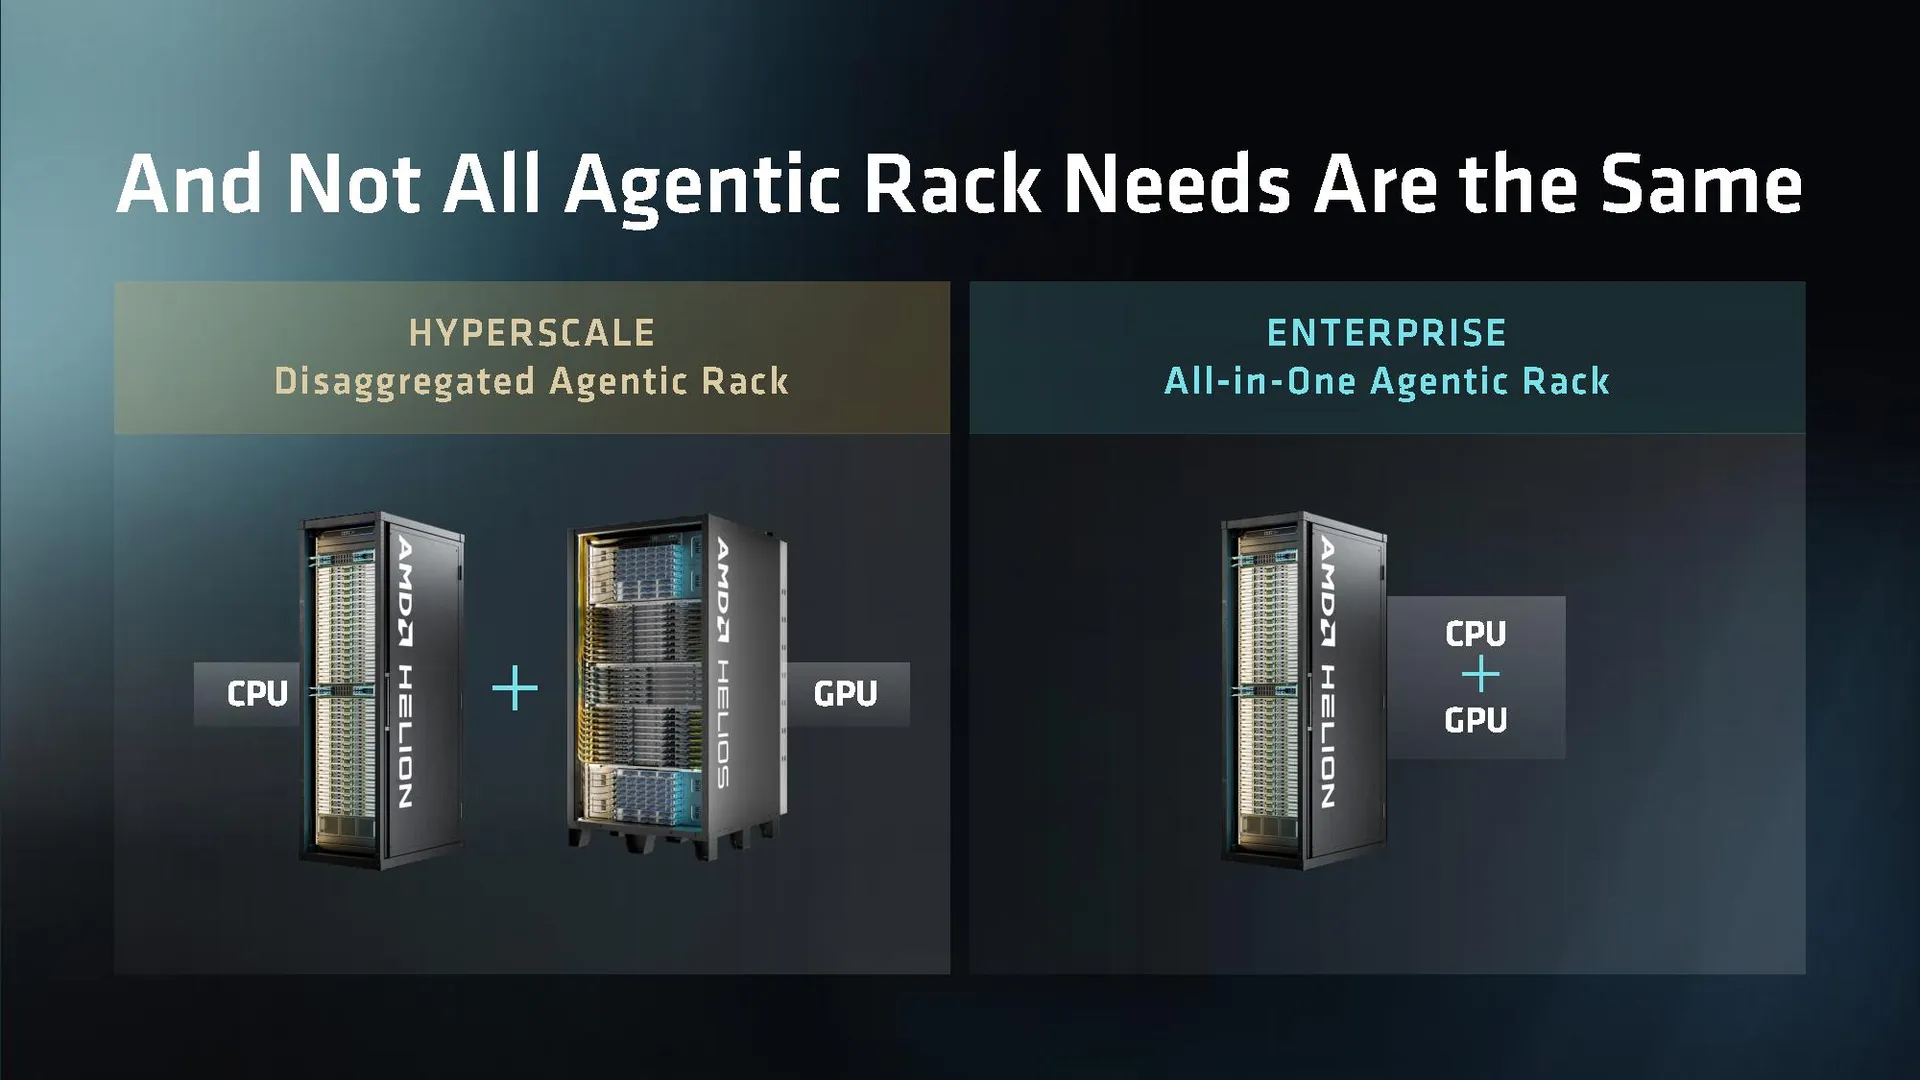
A ideia central desta solução é configurar de forma flexível CPU, GPU, rede e outros recursos de computação de acordo com os diferentes estágios do fluxo de trabalho do agente de IA. Para data centers de grande escala que precisam executar um grande número de agentes, executar código ou processar processos de negócios complexos, os clientes podem escolher racks de CPU puros; para usuários que desejam concluir a execução de agentes, inferência de modelo e tarefas gerais de computação empresarial no mesmo conjunto de equipamentos, eles podem escolher uma configuração híbrida de CPU e GPU.
Este design reflete a nova divisão emergente do trabalho na infraestrutura de IA. A GPU ainda é um dispositivo de computação importante para treinamento de modelos em larga escala e inferência de alta intensidade, mas quando os agentes de IA realmente executam tarefas, eles também exigem uma grande quantidade de recursos de CPU para executar programas, acessar bancos de dados, chamar ferramentas externas, gerenciar o status da tarefa e coordenar várias etapas de computação. À medida que o número de agentes aumenta, estas tarefas podem tornar-se novos gargalos de recursos no data center.
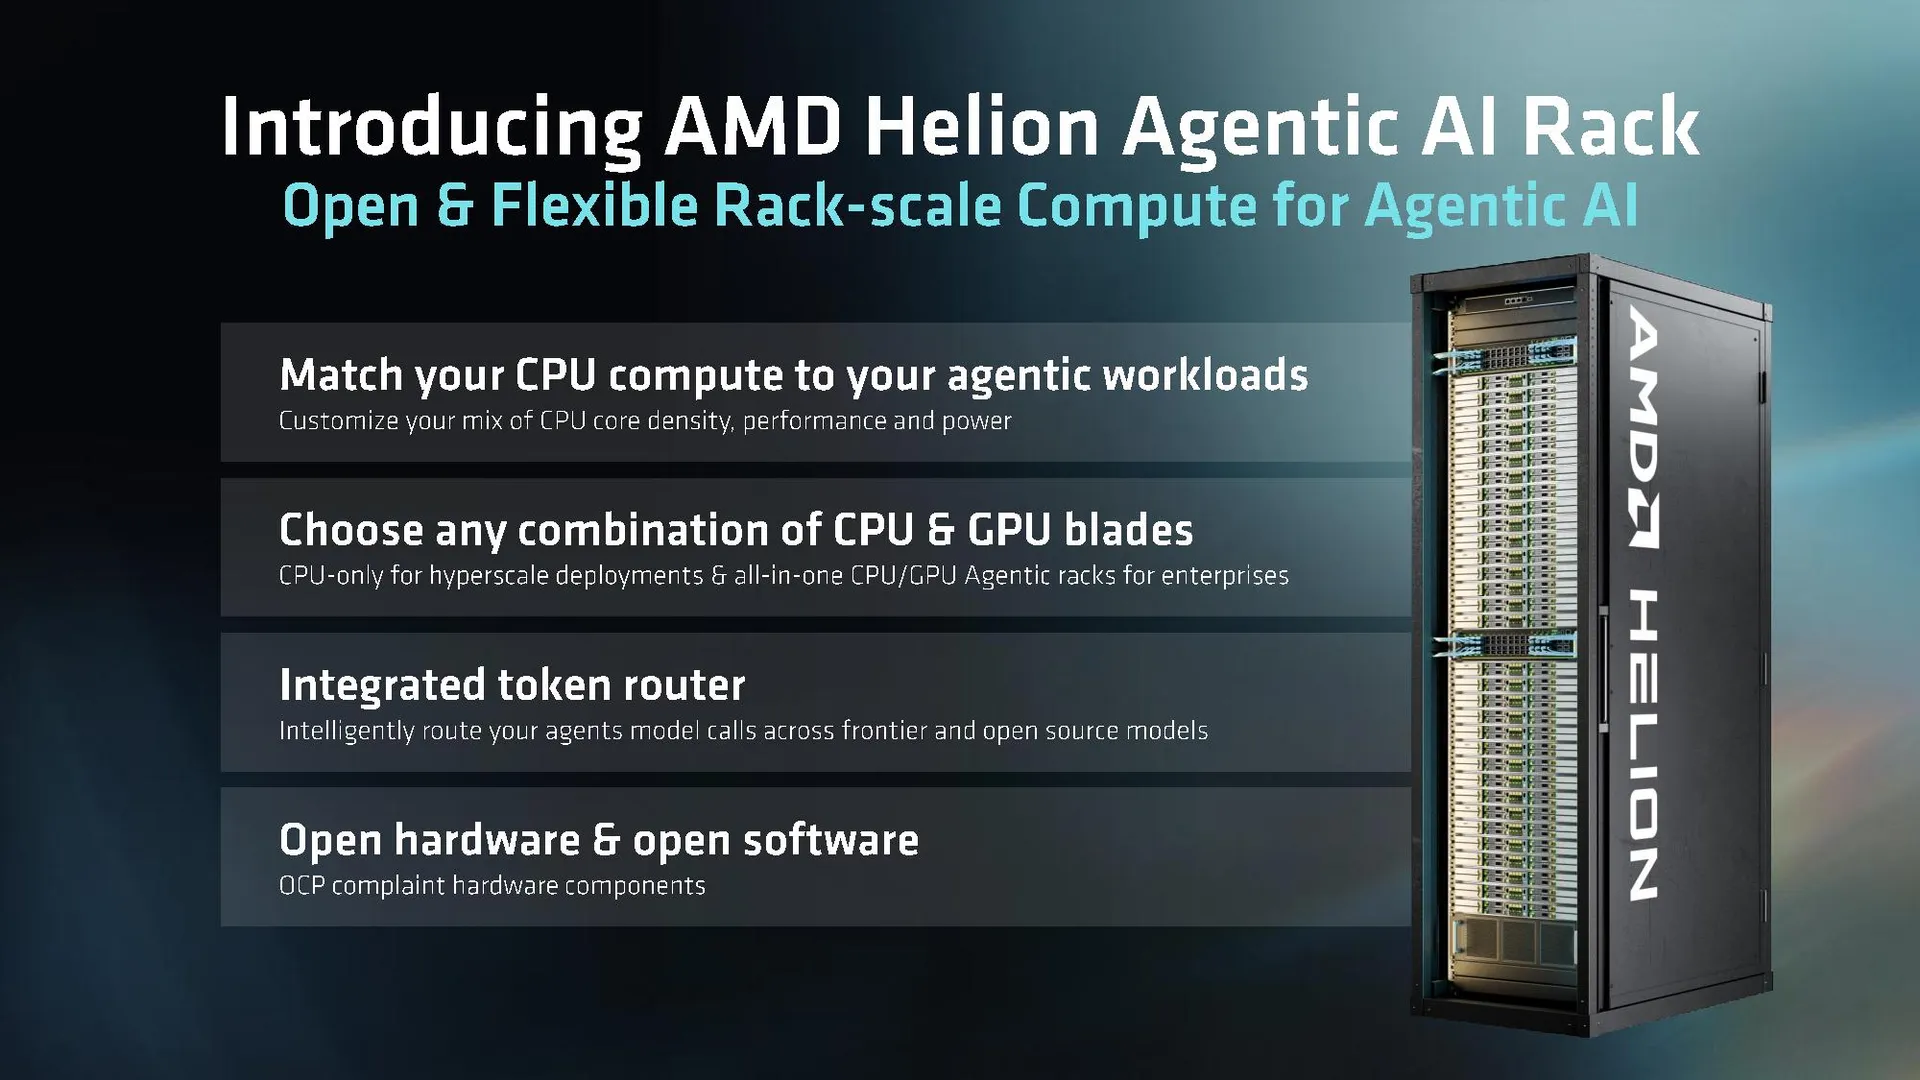
Dan McNamara, vice-presidente sênior e gerente geral da Divisão de Computação e IA Corporativa da AMD, disse que a IA do agente não é um tipo único de carga de trabalho, mas cobre uma variedade de cenários, como agentes pessoais, aplicativos empresariais, execução de código e fluxos de trabalho complexos. Cada tarefa tem requisitos diferentes para recursos de computação. Portanto, os data centers precisam de infraestrutura que possa ajustar o desempenho, a densidade do núcleo e o consumo de energia com base em cargas de trabalho específicas.
Ele disse que a AMD espera usar o Helion para combinar o desempenho dos processadores EPYC, ecossistema de software aberto e design de rack flexível, para que os parceiros possam construir sistemas de acordo com as necessidades dos clientes e fazer uso mais eficiente de recursos de energia limitados.
A configuração mais atraente do Helion é um rack de CPU puro que pode acomodar até 32.768 núcleos de CPU. A solução usa o processador de servidor EPYC de sexta geração da AMD, a arquitetura principal é Zen 6 e tem o codinome Venice. De acordo com o projeto anunciado pela AMD, todo o rack pode instalar até 128 processadores de 256 núcleos, formando teoricamente um cluster computacional com 32.768 núcleos de CPU.
Deve-se notar aqui que os 32.768 núcleos não estão integrados em um processador, mas são compostos por processadores em um grande número de nós de servidor. A Helion adota um design em nível de rack para integrar vários nós de computação, equipamentos de rede e infraestrutura relacionada em um todo para implantação e gerenciamento centralizados no data center.
Esse design é particularmente adequado para cenários onde um grande número de tarefas independentes ou paralelas precisam ser executadas. Por exemplo, uma empresa pode executar dezenas de milhares de agentes de IA ao mesmo tempo, e cada agente requer um ambiente de execução independente para executar código, recuperar dados, chamar a API interna da empresa ou lidar com tarefas complexas atribuídas a ele pelos usuários. Comparado com a simples realização de inferência de modelo, esse tipo de fluxo de trabalho geralmente envolve mais execução rotineira de programas e operações de coordenação de sistema e, portanto, requer capacidade de computação de CPU suficiente.
Em aplicativos tradicionais de modelos de linguagem grande, depois que o usuário insere uma pergunta, o modelo gera uma resposta e a carga computacional concentra-se principalmente no estágio de inferência do modelo. Mas em uma aplicação de agente, uma solicitação pode desencadear uma cadeia de operações: o agente analisa a tarefa, depois chama uma ferramenta de busca ou banco de dados, depois executa o código, verifica os resultados, chama o modelo novamente, se necessário, e finalmente gera uma resposta.
Neste processo, a GPU é responsável por executar tarefas de computação altamente paralelas, como inferência de modelo, enquanto a CPU é responsável por um grande número de execução de programas, processamento de dados, agendamento de tarefas e invocação de ferramentas. Se o número de agentes continuar a aumentar, mesmo que a GPU tenha capacidade de raciocínio suficiente, recursos insuficientes da CPU poderão limitar a velocidade de processamento de todo o sistema.
A AMD espera resolver esse problema por meio da configuração pura da CPU Helion, fornecendo um ambiente de execução em grande escala e escalável para os agentes, ao mesmo tempo que deixa a inferência do modelo para a infraestrutura de GPU independente para processamento.
Isso significa que a Helion não está tentando substituir completamente a GPU pela CPU, mas está tentando separar ainda mais as responsabilidades dos dois. Para provedores de serviços em nuvem de ultragrande escala, esse design permite que diferentes tipos de cargas de trabalho usem recursos de computação mais adequados para eles, evitando que GPUs caras sejam ocupadas por um grande número de tarefas comuns de execução de programas.
Além da versão CPU pura, o Helion também oferece configurações de nível empresarial que combinam CPU e GPU. Esta solução pode integrar processadores AMD EPYC, aceleradores de GPU Instinct MI350P e nós de computação de uso geral no mesmo rack, permitindo que as empresas executem agentes, realizem inferência de modelos e administrem bancos de dados, armazenamento e outras tarefas gerais de computação na mesma infraestrutura.
De acordo com o design anunciado pela AMD, a configuração híbrida pode ser equipada com até 16 aceleradores GPU Instinct MI350P e fornecer largura de banda de rede de até 102 Tbps. A largura de banda da rede aqui é o indicador de design de todo o sistema e não significa que cada nó de computação possa obter independentemente a mesma largura de banda. O desempenho real das comunicações também depende da topologia da rede, da configuração das portas, da distribuição do tráfego e do software do sistema.
Em termos de nós de GPU, a AMD fornece um design de servidor 5U usando oito aceleradores Instinct MI350P. Ao combinar nós de computação de GPU com nós de CPU, as empresas podem ajustar o número de aceleradores com base em tarefas específicas sem precisar fixar todo o sistema em uma única configuração de hardware.
Por exemplo, sistemas que precisam processar grandes quantidades de dados corporativos e executar fluxos de trabalho complexos podem alocar mais núcleos de CPU; sistemas que exigem inferência de modelo de alto rendimento podem aumentar os recursos da GPU. Cargas de trabalho auxiliares, como bancos de dados e armazenamento, também podem usar nós de computação dedicados de uso geral, reduzindo a competição por recursos entre eles e as tarefas executadas pelo agente.
A AMD também projetou uma variedade de nós de computação de CPU com diferentes posições para o Helion, a fim de atender a diferentes necessidades em termos de consumo de energia, densidade de núcleo e desempenho de núcleo único.
Os nós de alta densidade usam processadores da série EPYC 9006 com consumo de energia nominal de 400 watts, usados principalmente para maximizar o número de núcleos de CPU por unidade de espaço. O nó balanceado usa um processador de 256 núcleos com consumo de energia nominal de 600 watts para atingir um equilíbrio entre a densidade do núcleo e o poder de computação geral.
Para cargas de trabalho que dão mais ênfase ao desempenho de thread único, a AMD também oferece uma configuração de processador com 96 núcleos e frequência máxima de 5 GHz. Comparado a simplesmente buscar o número de núcleos, esse tipo de nó é mais adequado para tarefas que são sensíveis ao desempenho de thread único e à velocidade de resposta.
Esse design diferenciado reflete uma realidade importante: os agentes de IA nem sempre precisam de tantos núcleos de CPU. Algumas tarefas podem ser divididas em um grande número de operações paralelas, o que é adequado para servidores de alta densidade; outras tarefas são limitadas pelo desempenho de thread único, latência de memória ou velocidade de resposta de serviço externo, e simplesmente aumentar o número de núcleos não pode trazer melhorias de desempenho correspondentes.
Portanto, a Helion tenta permitir que os operadores de data center escolham diferentes configurações de processador com base nas cargas de trabalho reais, em vez de cobrir todos os cenários com uma especificação.
Em termos de dissipação de calor, o Helion suporta soluções de refrigeração a ar e refrigeração líquida. Para racks com dezenas de milhares de núcleos de CPU e equipamentos de rede integrados de alta velocidade, o projeto da fonte de alimentação e da dissipação de calor são problemas de engenharia que não podem ser ignorados. Servidores de alta densidade podem melhorar a utilização do espaço da sala de computadores, mas também trarão maior carga de calor por unidade de espaço.
O resfriamento líquido pode ajudar os sistemas a remover o calor gerado pelos processadores e outros componentes de alta potência com mais eficiência, mas também requer infraestrutura de resfriamento de suporte, projeto de tubulação e processos de manutenção. O resfriamento a ar pode ser mais adequado para alguns clientes que desejam continuar a usar as instalações existentes do data center. A AMD oferece duas soluções, o que significa que os parceiros podem escolher com base nas condições da sala de computadores, na escala de implantação e nos custos operacionais.
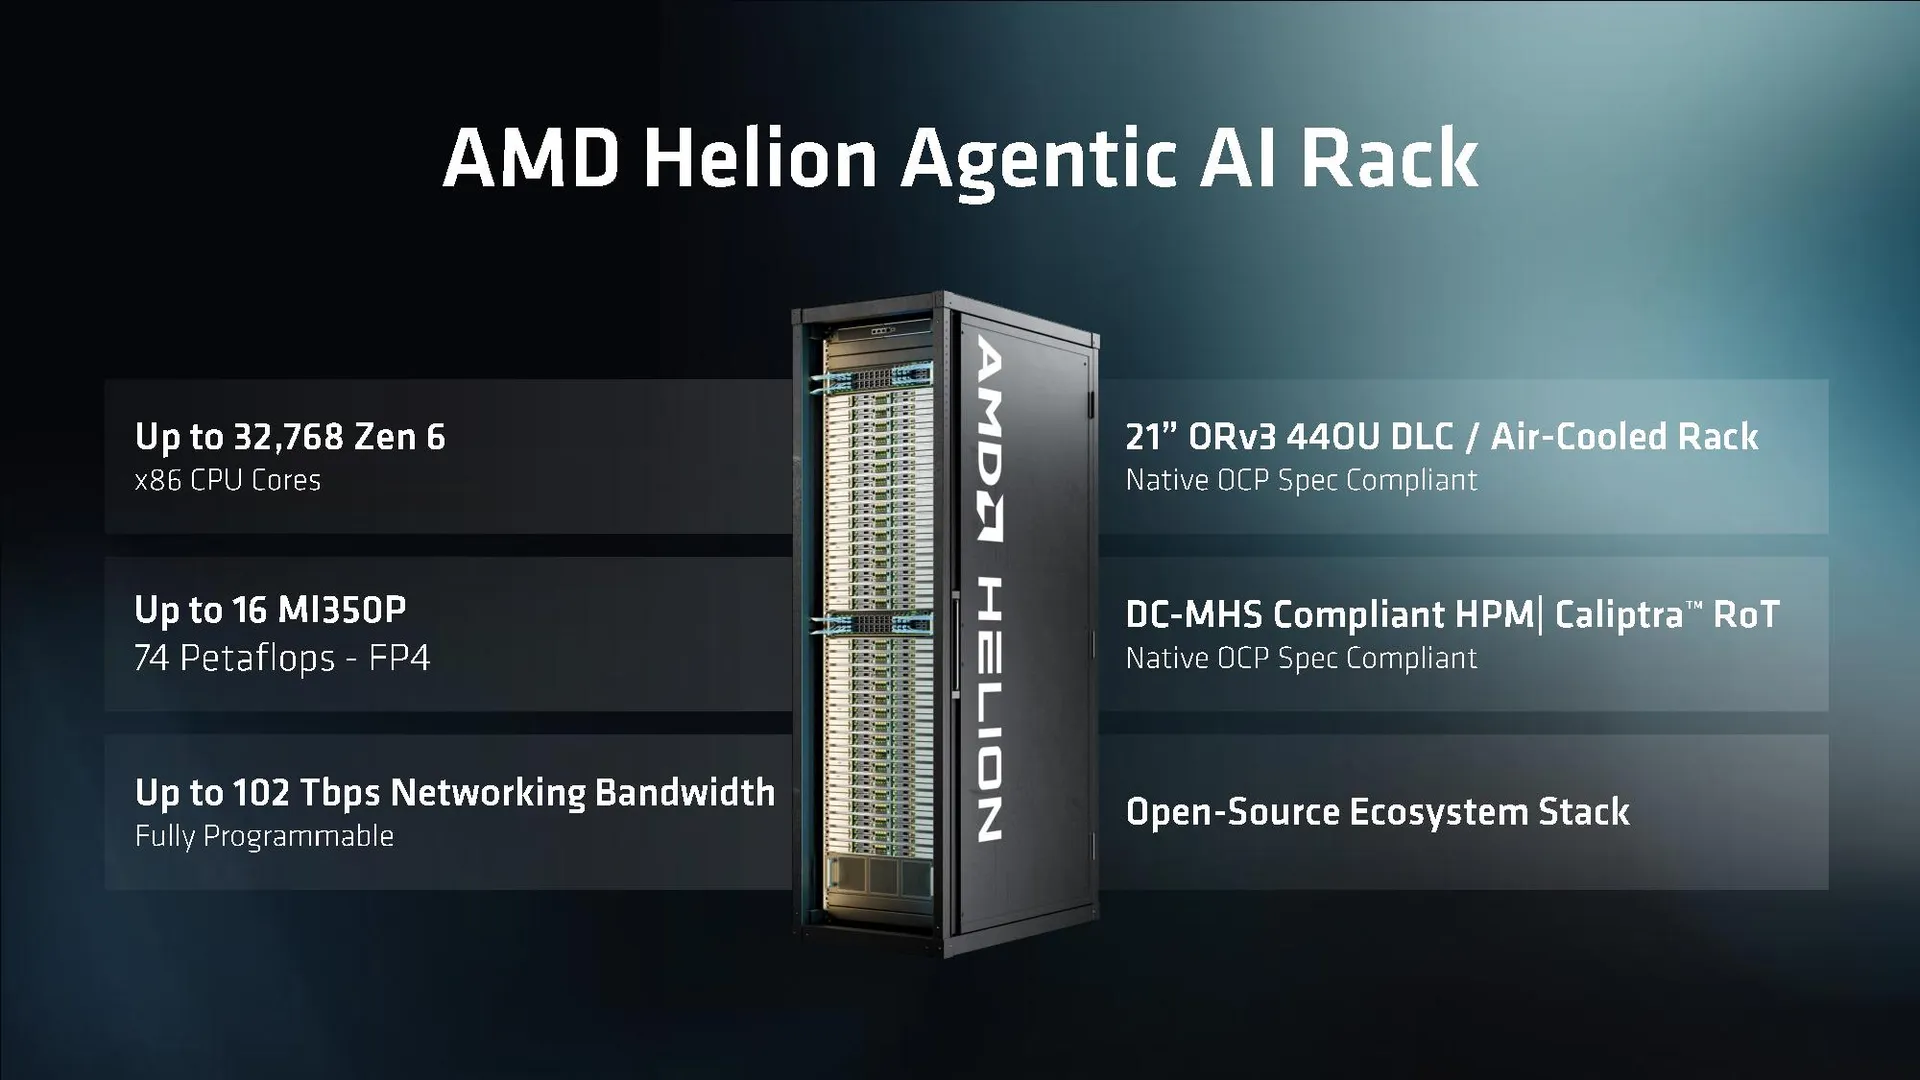
Além da configuração de hardware, a Helion também enfatiza software aberto e design de sistema. A AMD planeja contribuir com especificações de referência relevantes para o OCP para que os parceiros possam desenvolver com base em um projeto comum, em vez de depender inteiramente de sistemas fechados fornecidos por um único fabricante.
OCP é uma organização do setor que promove o design de hardware de data center aberto. Seus participantes incluem provedores de serviços em nuvem, fabricantes de servidores e outros provedores de infraestrutura. Projetos de referência aberta podem ajudar diferentes fabricantes a integrar sistemas em torno de especificações de hardware comuns e fornecer configurações diferentes com base nas necessidades do cliente.
A AMD espera expandir o ecossistema Helion desta forma, permitindo que Dell, Hewlett Packard Enterprise, Lenovo, AMD, Foxconn e outros parceiros desenvolvam seus próprios produtos. O que os clientes comprarão serão sistemas de servidores produzidos e integrados por parceiros, em vez de adquirir um conjunto completo de racks padronizados diretamente da AMD.
A AMD disse que a configuração do Helion está sendo desenvolvida com parceiros do ecossistema e está programada para lançamento em novembro de 2026. Os projetos relevantes ainda precisam passar pela integração do sistema, verificação e implantação real. Quais configurações podem ser finalmente fornecidas, quando serão entregues em grande escala, e as especificações específicas dos produtos dos diferentes fabricantes ainda serão anunciadas posteriormente.
Do ponto de vista da concorrência de mercado, Helion também reflete que a AMD está expandindo ainda mais o papel dos processadores EPYC na infraestrutura de IA.
Nos últimos anos, a construção de data centers de IA concentrou-se principalmente em áreas como aceleradores GPU, interconexão de servidores e memória de alta largura de banda. À medida que a demanda por treinamento e inferência de modelos em grande escala cresce rapidamente, a NVIDIA estabeleceu claras vantagens de mercado com seus produtos de GPU e seu ecossistema de software.
Mas, à medida que os aplicativos de IA entram gradualmente nos processos de negócios empresariais, as tarefas que os data centers precisam realizar não são mais apenas cálculos de modelos. Os agentes podem precisar executar um grande número de programas, acessar bancos de dados, processar documentos, executar códigos e coordenar vários modelos simultaneamente. Essas operações impõem novas demandas aos recursos da CPU.
A AMD espera obter mais oportunidades de mercado nesta mudança de infraestrutura com a ajuda de processadores EPYC de alto núcleo. Ao combinar a densidade do núcleo da CPU, a aceleração da GPU e o design de rede em escala de rack, a Helion tenta fornecer uma plataforma aberta que pode se adaptar a diferentes cargas de trabalho dos agentes.
É claro que 32.768 núcleos de CPU por si só não podem explicar diretamente o desempenho real do sistema. O desempenho final também depende da microarquitetura do processador, da largura de banda da memória, da capacidade do cache, da comunicação entre nós, da eficiência do agendamento do software e do grau de paralelismo da carga de trabalho. Para tarefas que dependem fortemente de inferência de modelos grandes, a GPU ainda pode ser um fator crítico na determinação do rendimento do sistema.
Da mesma forma, aumentar o número de núcleos de CPU não significa que as tarefas do agente serão aceleradas proporcionalmente. Se um grande número de tarefas precisar aguardar respostas do banco de dados, acessar redes externas ou chamar outros serviços, o gargalo do sistema poderá mudar para o nível de armazenamento, rede ou software. Portanto, o valor do Helion precisa ser medido pelo desempenho, eficiência energética e custo total de propriedade em aplicações reais.
No geral, o AMD Helion representa uma expansão das ideias de design de infraestrutura de IA. A AMD não enfatiza mais apenas o papel dos aceleradores de GPU na inteligência artificial, mas em vez disso tenta fornecer soluções de computação integradas para agentes, desde a execução de tarefas, raciocínio de modelo até processamento de dados.
À medida que os agentes de IA assumem gradualmente tarefas como desenvolvimento de software, automação empresarial e fluxos de trabalho complexos, a divisão de recursos entre CPU e GPU pode se tornar mais importante. Se as empresas realmente precisarem fornecer um ambiente de execução independente para um grande número de agentes no futuro, os servidores CPU de alta densidade terão a oportunidade de se tornar uma parte importante do data center de IA.
No entanto, o Helion ainda é um design de referência aberta, e não um produto maduro que foi totalmente implantado. A possibilidade de obter vantagens de desempenho e custo em aplicações reais depende, em última análise, da implementação do sistema dos parceiros, da maturidade do ecossistema de software e das necessidades reais dos clientes empresariais em termos de infraestrutura de computação de agente.
Comentários