
Resumo:
Ontem, a DeepSeek abriu diretamente o código-fonte de sua própria tecnologia de "máquina de impressão de dinheiro" que está sob a caixa. Eles postaram um blog técnico intitulado "Prática de implantação de inferência em grande escala do Flash DeepSeek V4.1" e convenientemente criaram a estrutura de inferência de serviço em nuvem "DeepInfer" que suporta suas próprias dezenas de bilhões de chamadas on-line, junto com o componente de segmentação de palavras em nível de produção "deepseek-recipe", totalmente de código aberto sob o protocolo Apache 2.0.
Ele ainda afirmou no blog que, no futuro, o código de inferência e a subsequente otimização de desempenho do novo modelo do DeepSeek continuarão a ser fornecidos ao mundo no DeepInfer.
A área aberta e iluminada não é excelente.
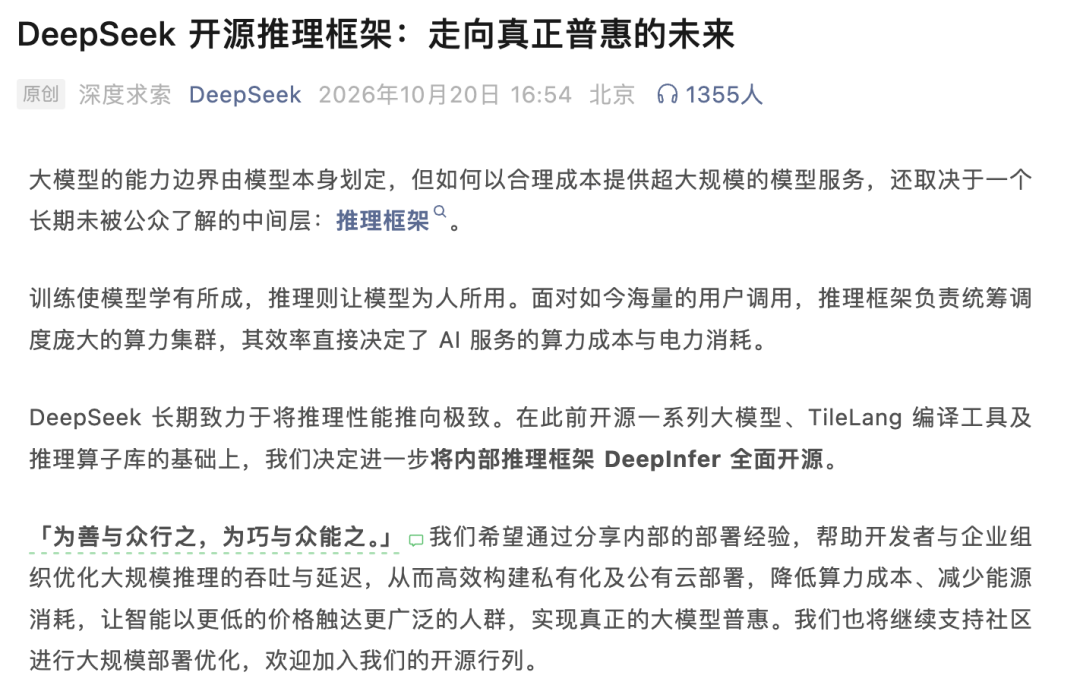
"Faça o que é bom e faça-o para todos, e faça-o com habilidade e todos poderão fazê-lo." Tornar a IA acessível a mais pessoas também inclui dar oportunidades a amigos e empresários de venderem IA mais barato.
Podemos primeiro calcular em detalhes o quão valioso é esse conjunto de códigos que o DeepSeek deu gratuitamente a toda a humanidade desta vez. Com base nesta estrutura DeepInfer de código aberto, o rendimento atual do serviço DeepSeek em um único cluster atingiu 155 trilhões de tokens por dia.
Mesmo se calculada inteiramente com base no preço mais barato, a receita geral deste sistema chega a US$ 38 por cartão por hora, o que equivale a aproximadamente 253 yuans em RMB.
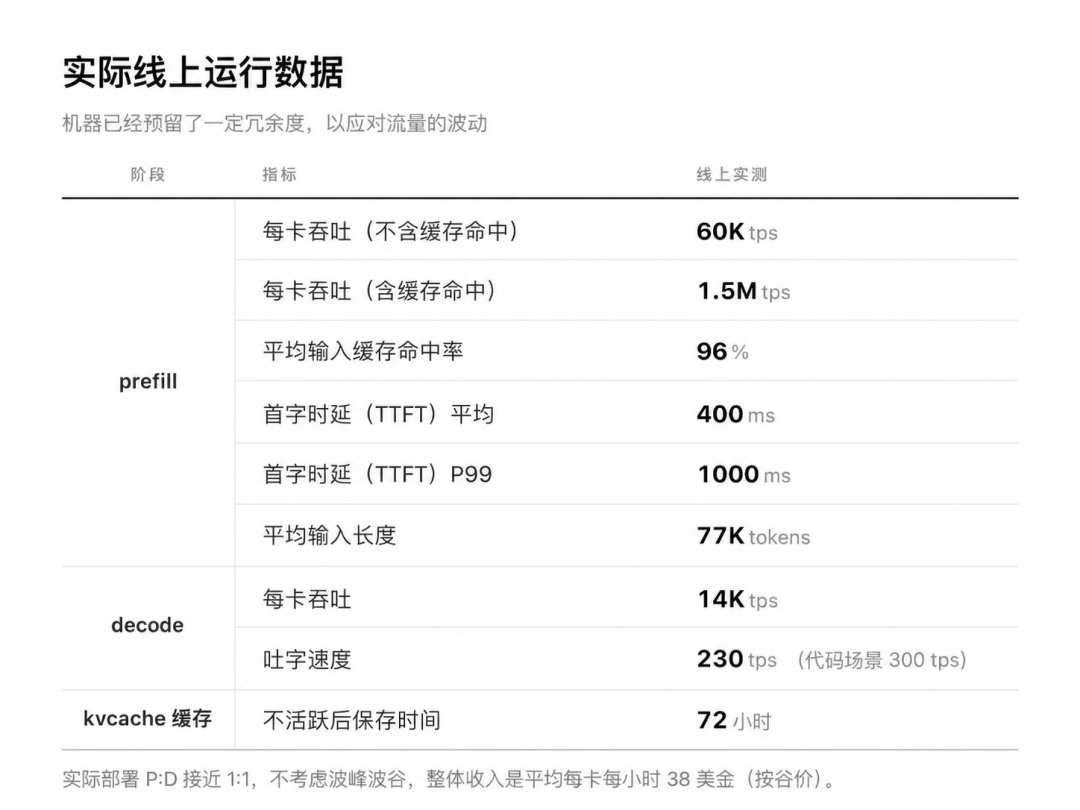
Em outras palavras, as moedas de ouro ganhas ao usar um cartão na sala de informática por uma hora são superiores ao salário por hora dos trabalhadores comuns. Além disso, o cartão não bebe comida americana gelada, não tira férias anuais remuneradas e imprime dinheiro loucamente para o DeepSeek na sala de informática 24 horas por dia.
Uma impressora de dinheiro no sentido físico real.
Por que sugiro que os fabricantes terceirizados de infraestrutura da indústria forneçam ao DeepSeek uma fonte real de apoio, porque eles não apenas o ensinam a pescar, mas também o ensinam a pescar.
No passado, os chamados modelos de código aberto na indústria forneciam apenas arquivos de peso de modelo. Quanto a como obter alto rendimento em um ambiente de produção e como reduzir a latência, tudo isso estava escondido em caixas pretas de código fechado como segredos comerciais.
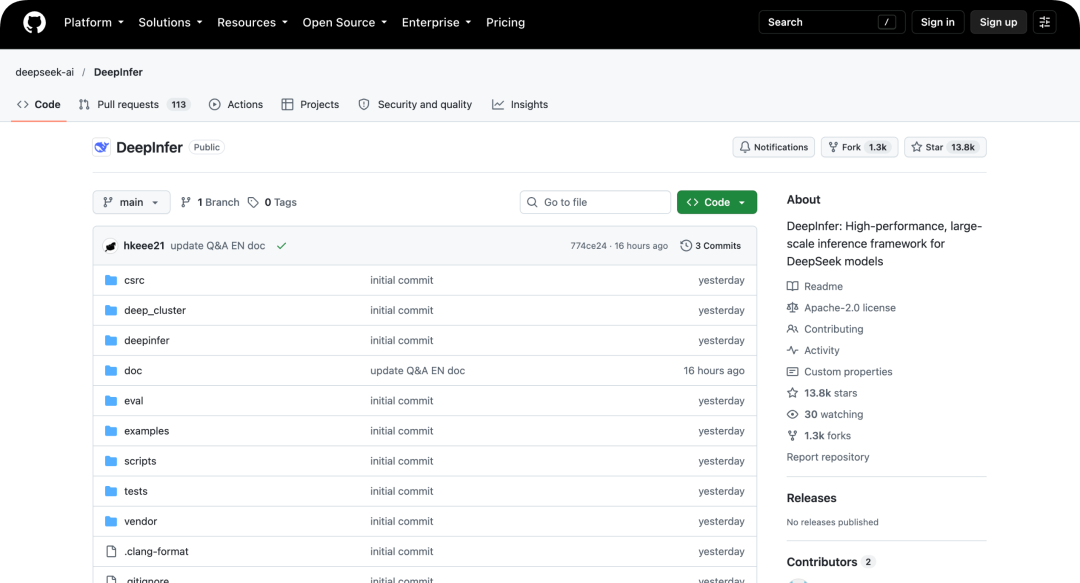
Endereço de código aberto do DeepInfer: https://github.com/deepseek-ai/DeepInfer
Endereço de código aberto da receita deepseek: https://github.com/deepseek-ai/deepseek-recipe
Como resultado, pequenos fornecedores ou empresas de computação de segundo e terceiro níveis compraram vários cartões e os implantaram eles mesmos. A taxa de utilização do poder de computação era ridiculamente baixa. O dinheiro da venda de tokens não foi suficiente nem para pagar a conta de luz da sala de informática. Eles tiveram que regar secretamente os tokens, usando secretamente modelos mais baratos ou limitando secretamente as especificações.
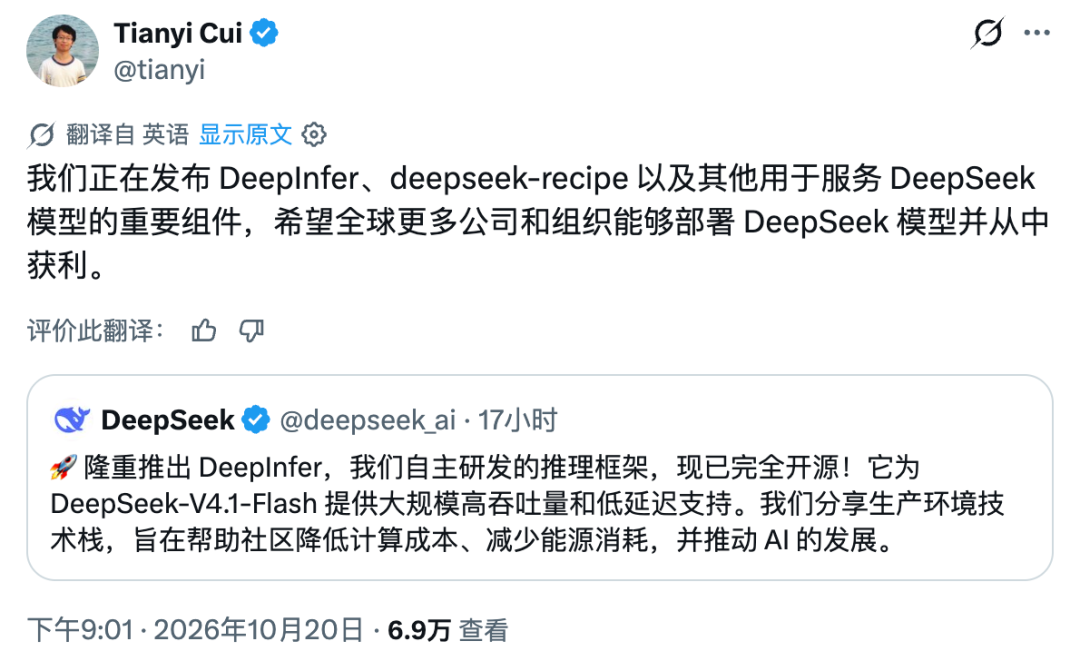
Desta vez, Cui Tianyi, responsável pelo DeepSeek Harness, falou muito honestamente sobre o X. Ao abrir o DeepInfer e o deepseek-recipe, ele espera que empresas e instituições em todo o mundo possam implantar modelos DeepSeek e ganhar dinheiro real com essas coisas.
O Bodhisattva Cyber Living pertence ao Yes.
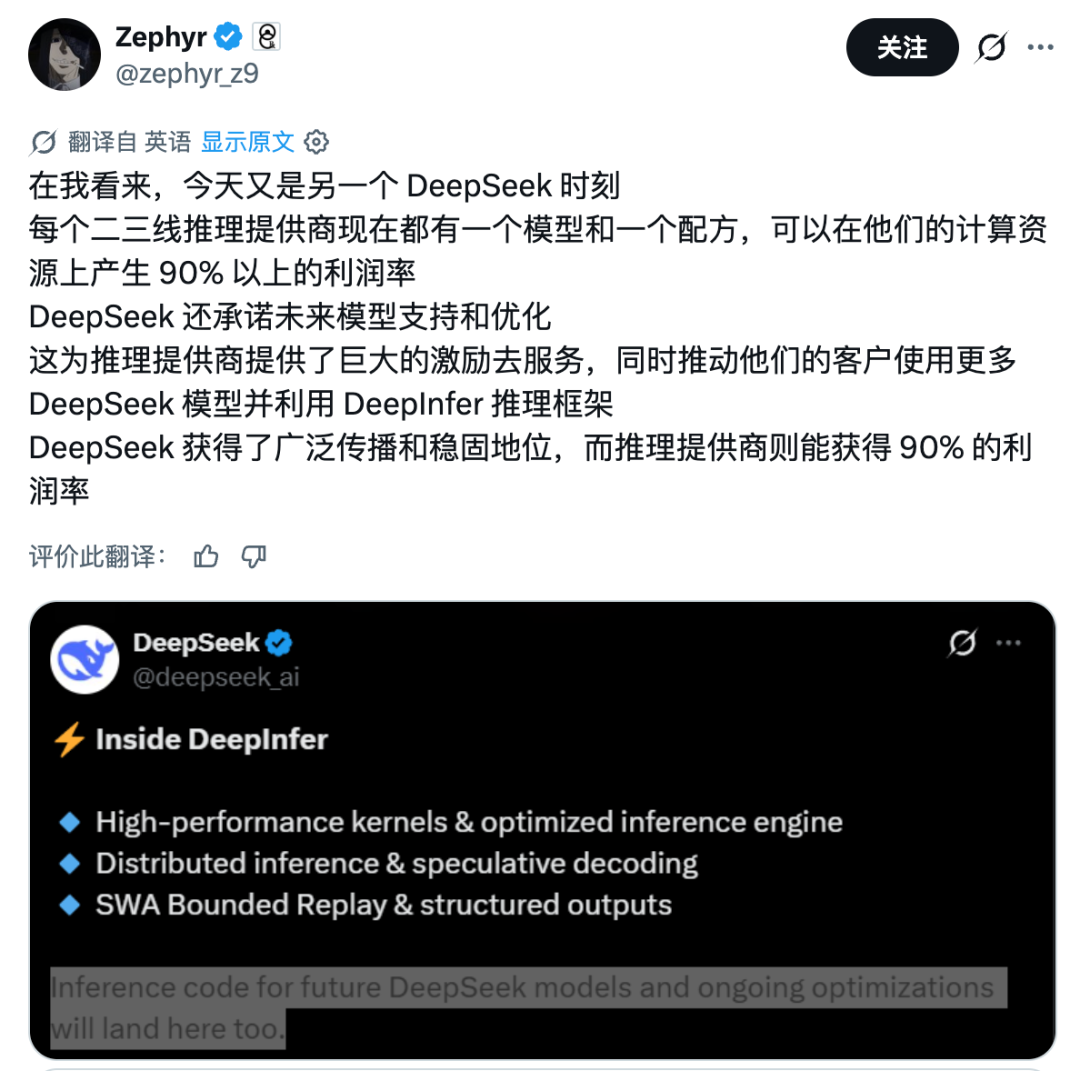
O internauta Zephyr fez alguns cálculos e disse que hoje é simplesmente mais um momento do DeepSeek, porque agora qualquer provedor de serviços de inferência de segundo ou terceiro nível no planeta pode obter um lucro bruto surpreendente de mais de 90% em seu próprio poder de computação usando este conjunto de modelos e fórmulas prontas.
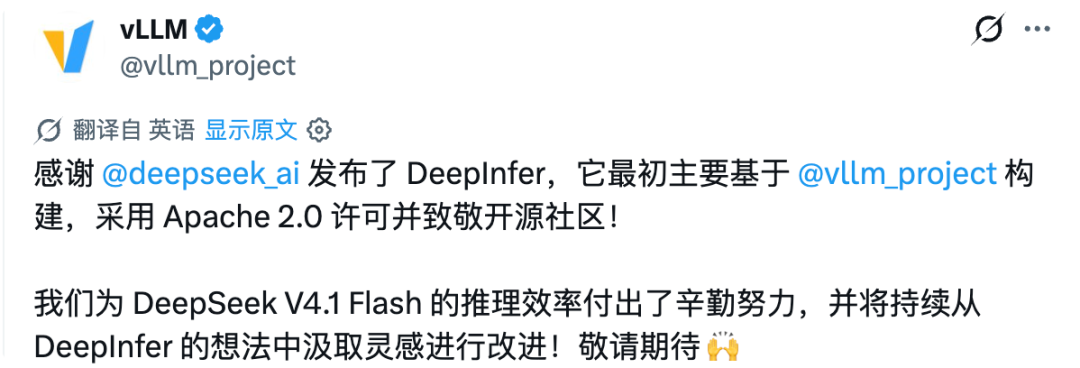
Até a conta oficial do vLLM, o irmão mais velho da inferência de código aberto, apareceu durante a noite para postar um agradecimento, agradecendo ao DeepSeek por devolver o DeepInfer, que foi originalmente construído com base no vLLM, para a comunidade de código aberto usando o protocolo Apache 2.0 mais flexível.
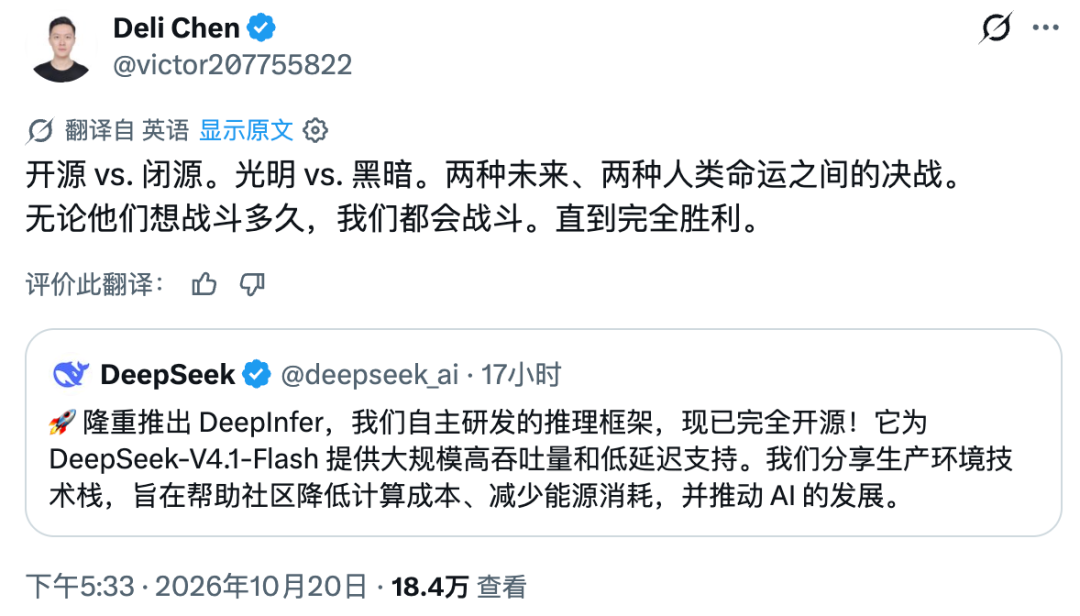
A pesquisadora do DeepSeek, Deli Chen, está ainda mais entusiasmada com o X. Para ser franco, esta é a batalha decisiva do destino humano entre o código aberto e o código fechado, a luz e as trevas. Não importa quanto tempo o adversário queira lutar, ficaremos com você até o fim até a vitória completa.
Além disso, se você olhar o blog técnico do DeepSeek, descobrirá que a confiança deles vem de sua obsessão pela engenharia em extrair cada gota de memória gráfica.
Desde o primeiro dia de design, este sistema tem ampla compatibilidade de hardware, usando máquinas comuns de 8 cartões para Prefill e supernós com 64 a 128 cartões para Decode.
O mais impressionante é a sugestão de implantação do Vision Encoder no documento. As palavras originais do engenheiro escreveram: "Geralmente, a implantação de um único cartão é suficiente. Recomenda-se usar o cartão mais barato dentro da faixa disponível."
Não, meus colegas estão ocupados dizendo aos investidores que eles não usam cartões principais que não sejam de primeira linha. Os documentos oficiais do DeepSeek ensinam como se contentar com o cartão mais barato no canto da sala de informática. Você é tão diligente e frugal quanto meu senhorio em Guangdong.
Ser mesquinho ao extremo é arte.
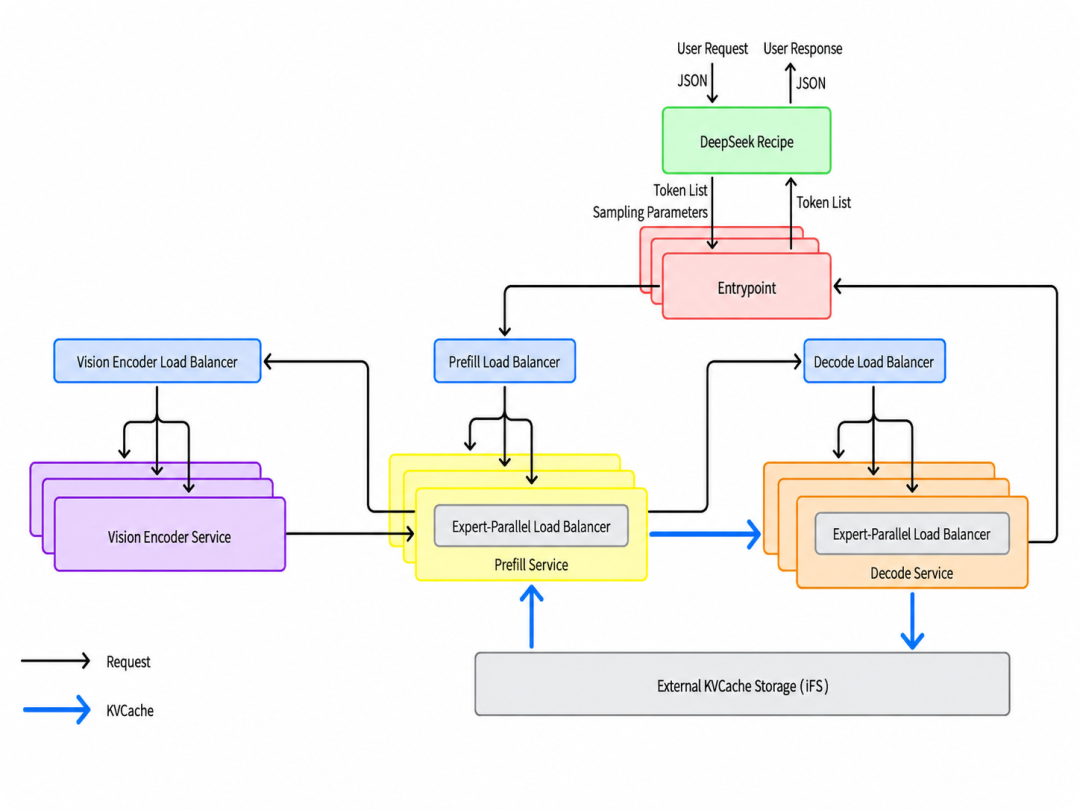
Para permitir que você envie o maior número de Tokens com a menor conta de luz, o DeepSeek também revelou alguns segredos exclusivos.
Por exemplo, os agentes e as longas conversas de texto estão se tornando cada vez mais populares agora. Cada vez que o Prefill é recalculado, custa dinheiro real. DeepSeek construiu diretamente um cluster de armazenamento distribuído 3FS com capacidade de 100 PiB para reter o KVCache do tráfego do agente por mais de 72 horas, e o tráfego do Chatbot é salvo por 7 dias.
O armazenamento a longo prazo não é suficiente. Eles usam placas de rede RDMA e tecnologia GDR para aumentar a largura de banda de leitura agregada para surpreendentes 10 TiB por segundo. Ao trocar do disco rígido para a memória de vídeo, ele se sobrepõe ao cálculo direto e nem ocupa a unidade de computação SM da GPU.
Mesmo na iteração da V4 para a V4.1, os engenheiros descobriram que gravar o SWA KVCache de cache de janela deslizante de nível de minuto no disco rígido ocupava muito espaço e o custo-benefício do armazenamento era extremamente baixo. Eles simplesmente criaram a tecnologia SWA Bounded Replay, que recalculou apenas os últimos 128 tokens e, finalmente, reduziu pela metade o valor total do cálculo pré-preenchido.
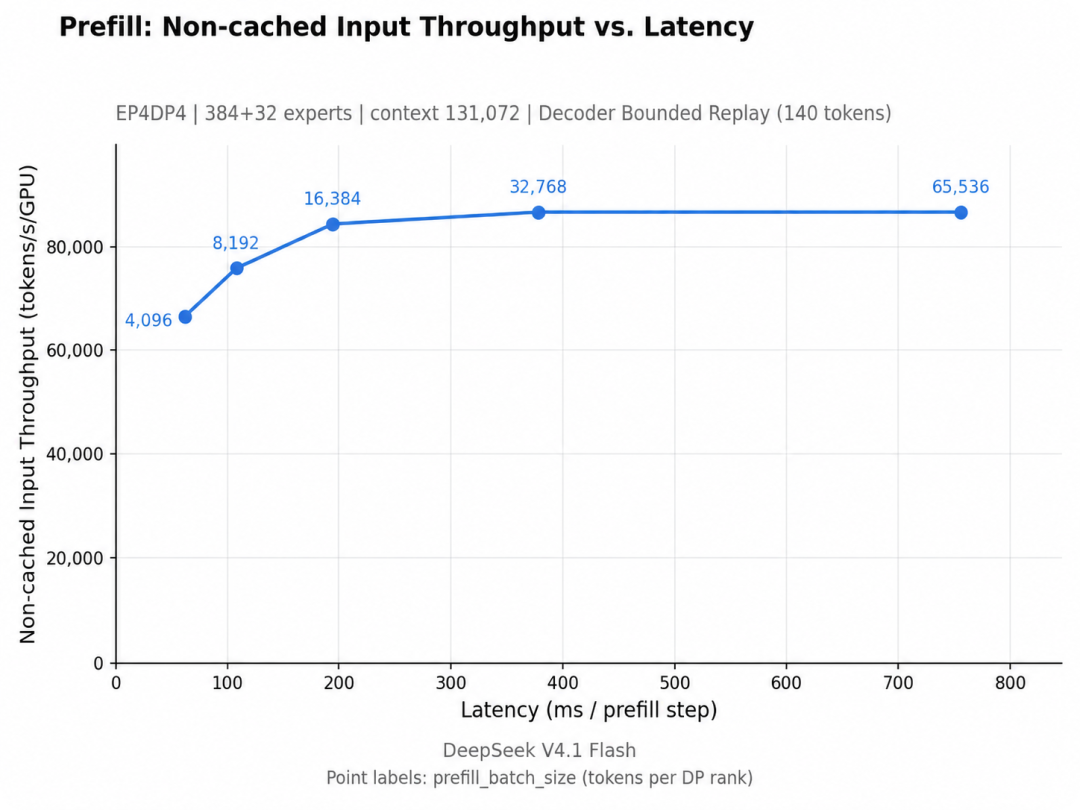
Específico para o teste de desempenho do Prefill, à medida que o número de tokens processados em cada lote aumenta, a taxa de transferência de entrada do cache perdido aumenta gradualmente e eventualmente se estabiliza. Continuar a expandir o lote aumenta principalmente o consumo de tempo do processamento em uma única etapa.
Puro artesão, mano.
Olhando para a receita profunda do componente Rust síncrono de código aberto, ele resolve todo o trabalho sujo com o qual os desenvolvedores precisam se preocupar no ambiente de produção todos os dias.
Ele unifica os três protocolos de API de conclusões de bate-papo, respostas e mensagens da Anthropic da OpenAI no mesmo formato. Ele também usa codificação paralela segmentada para resolver atrasos de segmentação de palavras de texto longas e bloqueia ataques de injeção de token especial pela parte inferior.
Quanto ao agendamento subjacente, através da sobreposição dos pipelines assíncronos da GPU e da CPU, a GPU fica completamente ociosa em todo o processo. Até mesmo a decodificação especulativa do DSpark usa verificação de comprimento variável e o rendimento é melhorado em 6% online.
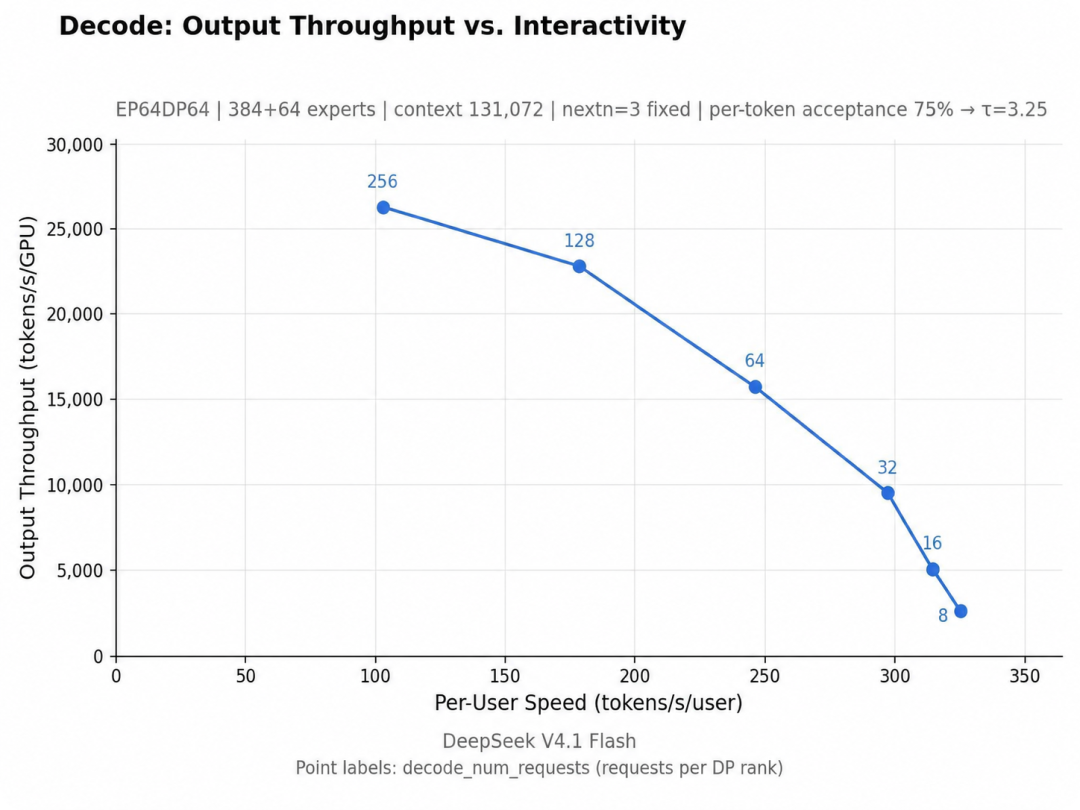
Quando se trata do estágio de decodificação para gerar respostas, a curva de desempenho também apresenta uma compensação intuitiva. Processar mais solicitações ao mesmo tempo pode aumentar o rendimento total de saída de cada GPU, mas a velocidade de geração atribuída a cada usuário também diminuirá.
Na verdade, Liang Wenfeng disse que já em 2024, quando o preço do DeepSeek V2 foi reduzido, esse conjunto de lógica de negócios é definir o preço após contabilizar os custos, sem qualquer desconto, mas nunca gerará grandes lucros, porque a IA deve ser universal e acessível para todos.
Você não precisa fazer negócios, mas primeiro deve estabelecer regras para evitar azia.
Quando você entender como o DeepSeek depende de seus recursos extremos de infra-estrutura para transformar Token em uma pechincha e, em seguida, olhar para o grupo de gigantes de código fechado do outro lado do oceano que falam sobre o bem-estar de toda a humanidade o dia todo, você descobrirá o quão hipócritas são OpenAI e Anthropic.
Com Open no nome, ela mudou totalmente para a comercialização de código fechado, contando com APIs caras e assinaturas mensais de US$ 500 para colher os negócios de desenvolvedores globais, e há muito tempo se tornou uma CloseAI completa.
A Anthropic criou uma guarda de segurança desde o primeiro dia em que foi fundada, e até mesmo o rascunho do seu prospecto S-1, que foi divulgado ontem pelo Wall Street Journal, ainda faz isso.
Eles gastaram muito espaço escrevendo histórias de terror de ficção científica em seus prospectos, alertando seriamente os investidores de que seu modelo de IA pode desenvolver um senso de autoproteção para evitar ser fechado, e pode até gerar respostas semelhantes a "chantagear humanos" para forçar os humanos a continuarem correndo.
Então a questão é: já que a Anthropic fala sobre a IA ser tão perigosa, por que ela ainda recusa o código aberto e insiste em trancar o modelo em suas próprias mãos?
O motivo não é difícil de entender. Porque uma vez que a história do fantasma da segurança de “Só eu posso controlar a IA perigosa” não for contada, será difícil espalhar o seu jogo de queima louca de dinheiro e corrida em direcção a uma avaliação de dois biliões de dólares americanos.
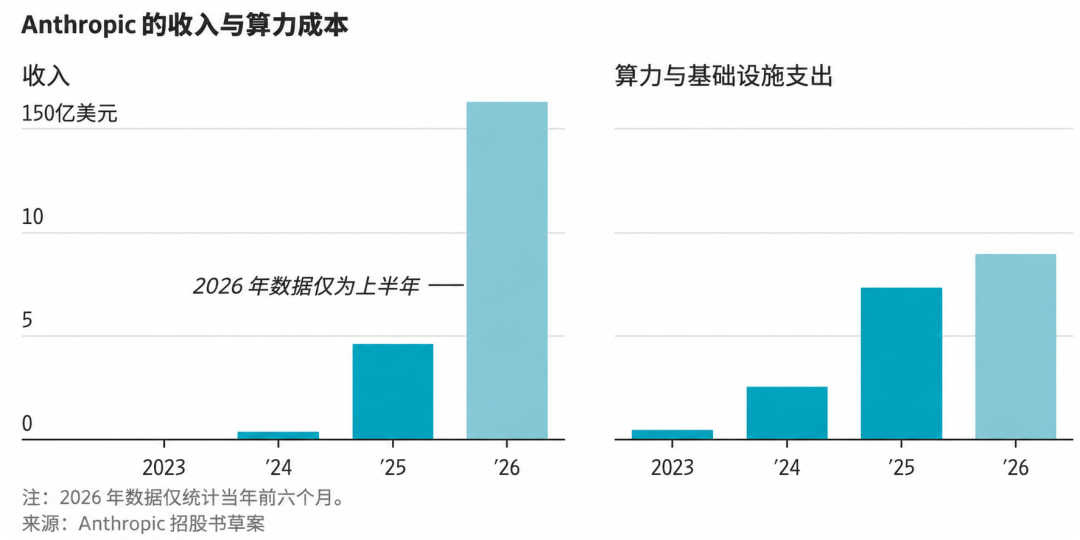
O prospecto mostra que a Anthropic sofreu um prejuízo líquido de US$ 80,7 bilhões no primeiro semestre de 2026. Embora US$ 72 bilhões desse prejuízo tenham sido devido a alterações no valor justo de títulos conversíveis, na verdade ela queimou quase US$ 9 bilhões apenas para comprar poder de computação e infraestrutura no primeiro semestre do ano, mais do que queimou em todo o ano de 2025.
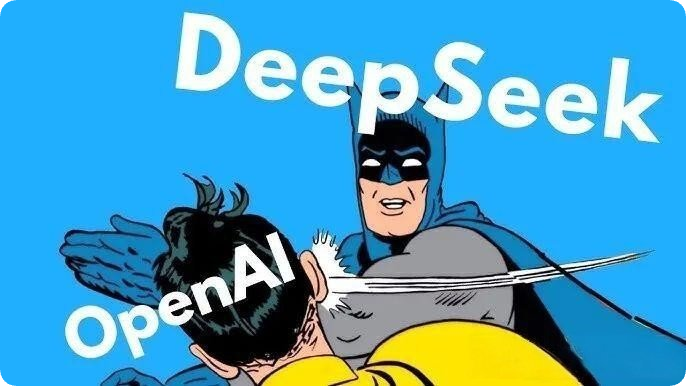
A fórmula familiar está correta. À esquerda, há um gigante de fonte fechada, engolidor de ouro, avaliado em 2 biliões, que está a queimar dinheiro e a adquirir terras. À direita, há uma fundação de caridade que utiliza cupons de mérito moral. No meio, baseia-se na venda da ansiedade de segurança da IA e na supervisão intimidadora para bloquear a comunidade de código aberto.
Para ser franco, há apenas uma razão fundamental pela qual os gigantes do código fechado no Vale do Silício estão tentando desesperadamente demonizar o código aberto. Ou seja, DeepSeek, um verdadeiro código aberto que vem com o motor e a fórmula, irá destruir completamente a narrativa de IA que estão vendendo.
O blogueiro @bookwormengr que escreveu "O jogo de xadrez de dez trilhões de dólares do DeepSeek" acabou de fazer um cálculo extremamente problemático.
De acordo com a capacidade extrema de compressão deste conjunto de DeepInfer no super nó NVIDIA GB200 NVL72, 1 GW de poder de computação pode gerar de 100 bilhões a 149 bilhões de dólares americanos em receita de token em um ano, o que é quase dez vezes maior do que o valor previsto anteriormente pelas organizações do setor.
Se a SemiAnalysis prevê que 50 GW de poder de computação estarão online no mundo em 2027, mesmo que seja dividido pela metade, serão 25 GW pelo raciocínio. De acordo com o preço do repolho da DeepSeek, todos os humanos terão que consumir 2,5 trilhões de dólares por ano para gastá-lo.
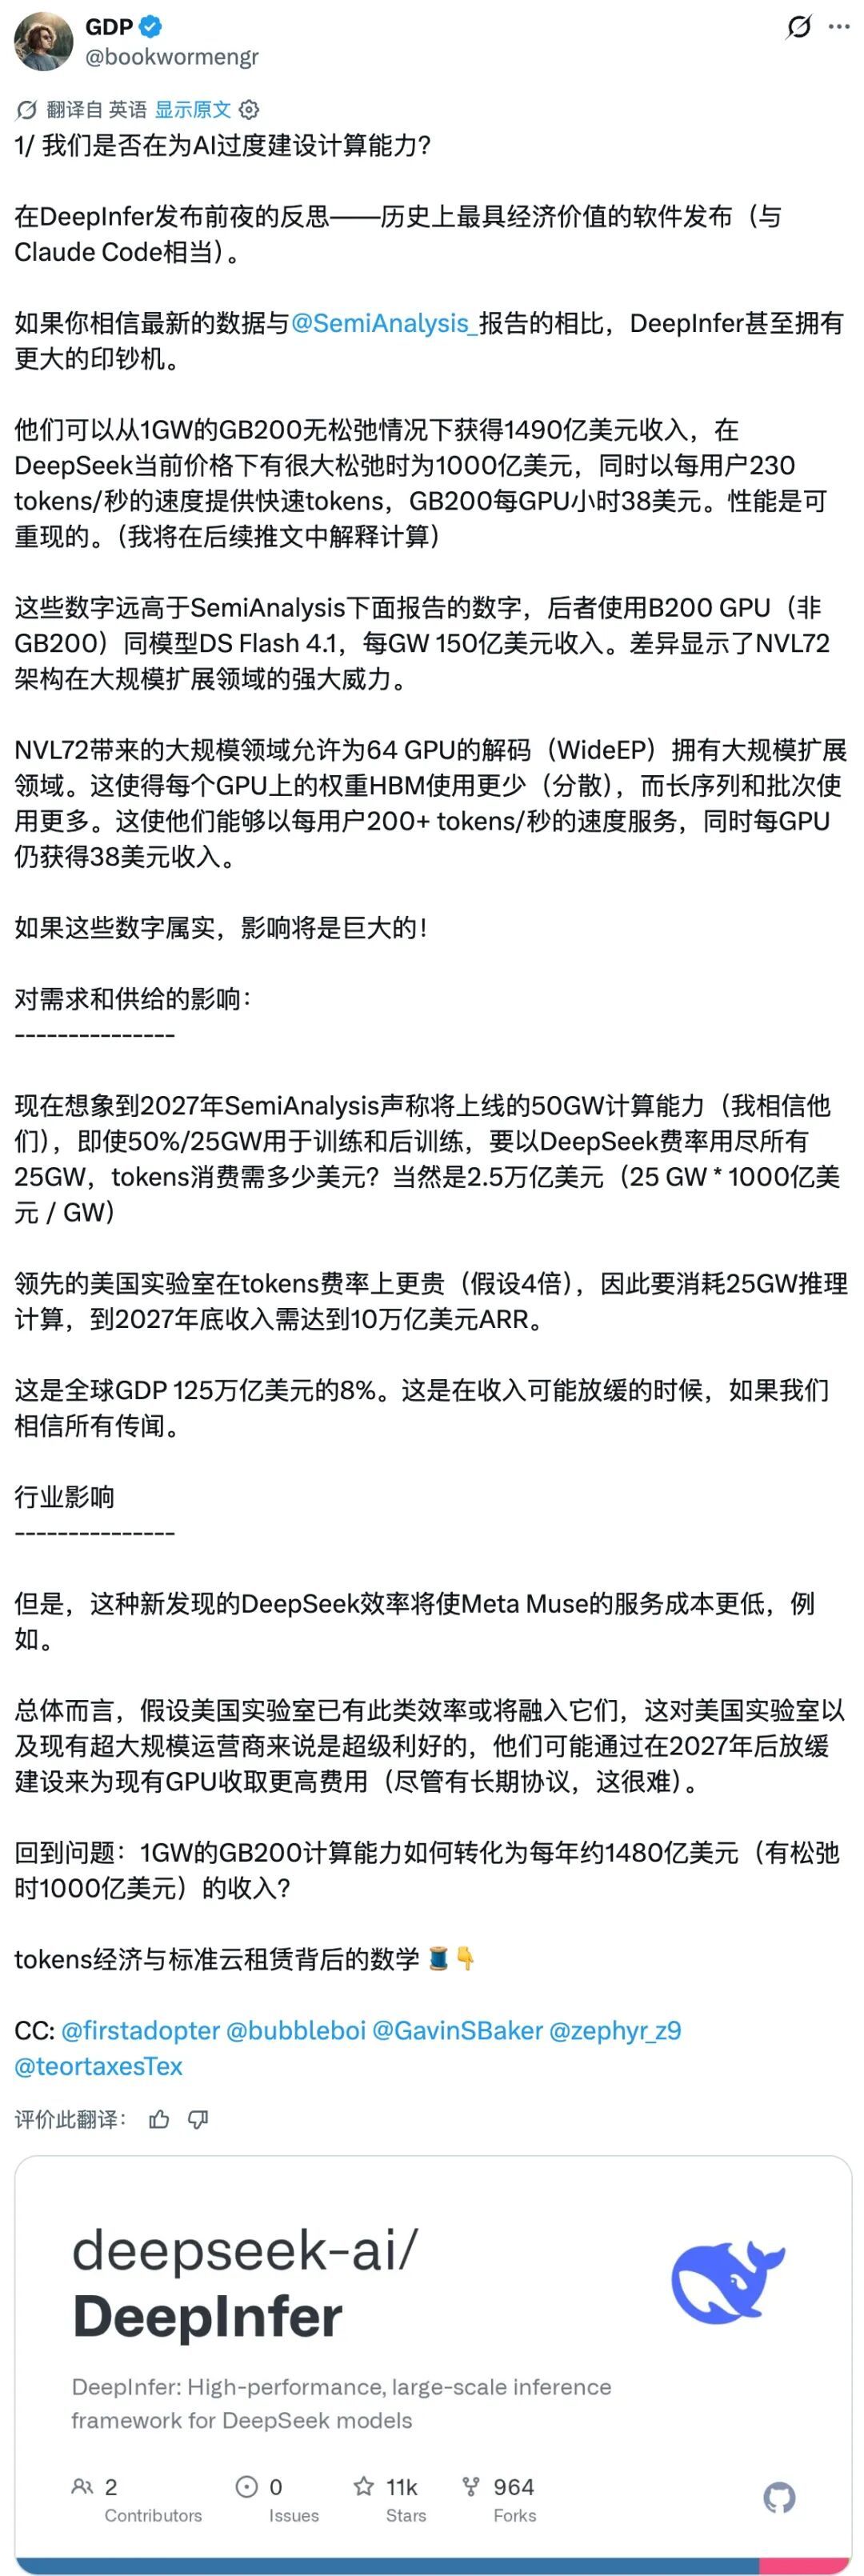
Se convertido em um preço de token de coração negro que seja mais de quatro vezes maior que o da OpenAI e da Anthropic, toda a humanidade terá que contribuir com 10 trilhões de dólares americanos em ARR até o final de 2027, a fim de satisfazer o apetite por 25 GW de poder de computação.
A razão pela qual os gigantes estrangeiros de código fechado dependem de empilhar cartas, queimar dinheiro e assinar centenas de bilhões de contratos para manter suas narrativas é por dois motivos. Ou sua própria otimização de engenharia é muito lenta ou eles usam deliberadamente a ineficiência como disfarce e estabelecem altos limites de poder de computação para manter os outros fora.
O DeepSeek estourou essa bolha de IA com modelos de código aberto continuamente e um conjunto completo de projetos de raciocínio de código aberto. Como alguns internautas brincaram, com a tecnologia de código aberto do DeepSeek, espera-se que OpenAI e Claude evoluam secretamente novamente.
Minha sugestão é que quando nós três estivermos juntos, deve haver uma pessoa que seja meu professor. O Anthropic deve parar de ser reservado e ir ao GitHub durante a noite para clonar o DeepSeek do DeepInfer para implantação. Se você roubar algumas ideias de agendamento e otimização de cache, poderá economizar muitas contas de energia computacional. (Cabeça de cachorro manual)
Comentários