Resumo:
O Google lança oficialmente o Gemini 4 Neon, um novo membro da série Gemini 4. Este modelo está posicionado para programação complexa, raciocínio analítico e execução de tarefas em várias etapas, tentando encontrar um equilíbrio entre altos níveis de inteligência e eficiência operacional. O Google diz que nos primeiros testes, a qualidade geral do Neon atende ou excede o modelo principal Gemini 4 Carbon, mas as tarefas são executadas três vezes mais rápido e a mesma tarefa custa apenas 60% do Carbon.
Anteriormente, o Google lançou o Gemini 4 Carbon e o Gemini 4 Hydrogen para tarefas diárias. O Carbono destina-se principalmente a tarefas complexas, de longo prazo e difíceis, enquanto o Hidrogénio enfatiza a resposta rápida e o uso diário. O Neon lançado desta vez preenche a lacuna de posicionamento entre os dois, focando em atender cenários de trabalho que exigem fortes capacidades de raciocínio, mas são sensíveis à velocidade de execução e ao custo.
Gemini 4 Neon obteve 61 pontos na avaliação do Índice de Inteligência de Análise Artificial, ficando em terceiro lugar ao ativar o modo de pensamento de nível mais alto, perdendo apenas para alguns modelos maiores e mais lentos. Na análise do Índice Vals, ficou em segundo lugar com uma pontuação de 70,9%. Além disso, o Google também afirmou que o Neon tem excelente desempenho na execução de instruções em várias etapas, processamento de restrições complexas e adaptabilidade quando os usuários modificam os requisitos da tarefa no meio do caminho.
Na área de desenvolvimento de software, a Neon dá ênfase especial aos fluxos de trabalho de agentes inteligentes de longa duração. Ele lida com depuração de código, refatoração e modificações de projeto em vários arquivos e reduz leituras repetidas de arquivos durante a execução, enquanto relata continuamente o progresso da tarefa. O Google espera que, por meio dessas melhorias, o modelo possa não apenas gerar código, mas também concluir trabalhos complexos de forma independente em um ambiente mais próximo do desenvolvimento real de software.
Nos resultados dos testes anunciados pelo Google, o Neon obteve 58,6 pontos no Índice de Agente de Codificação de Análise Artificial, o Terminal-Bench 4.1 obteve 65,2% e o FrontierCode 2.0 obteve 46,2%. No teste SWE-sweep, a pontuação foi de 12,8% ao usar a estrutura de teste mini-SWE, que aumentou para 39,0% no ambiente GoogleAntigravity. Este conjunto de diferenças mostra também que a estrutura de software e o ambiente de execução utilizados pelos agentes inteligentes podem ter um impacto considerável nos resultados finais.
Neon também pode atuar como coordenador em Antigravidade, dividindo tarefas complexas e entregando-as a vários subagentes do Gemini 4 Hydrogen para execução paralela. Desta forma, o modelo pode processar diferentes módulos de código ou etapas de trabalho simultaneamente e depois integrar os resultados de cada subagente. Para tarefas de desenvolvimento que envolvem vários arquivos e vários módulos funcionais, espera-se que esta abordagem colaborativa reduza o tempo geral de execução.
Em termos de trabalho de conhecimento empresarial, o Neon suporta entrada multimodal, como texto, imagens, áudio e vídeo, e a janela de contexto unificada pode suportar até 1 milhão de tokens. Os usuários podem colocar planilhas, PDFs, gráficos, áudio, vídeo e outros materiais na mesma tarefa, permitindo que o modelo analise de forma abrangente e gere resultados estruturados.
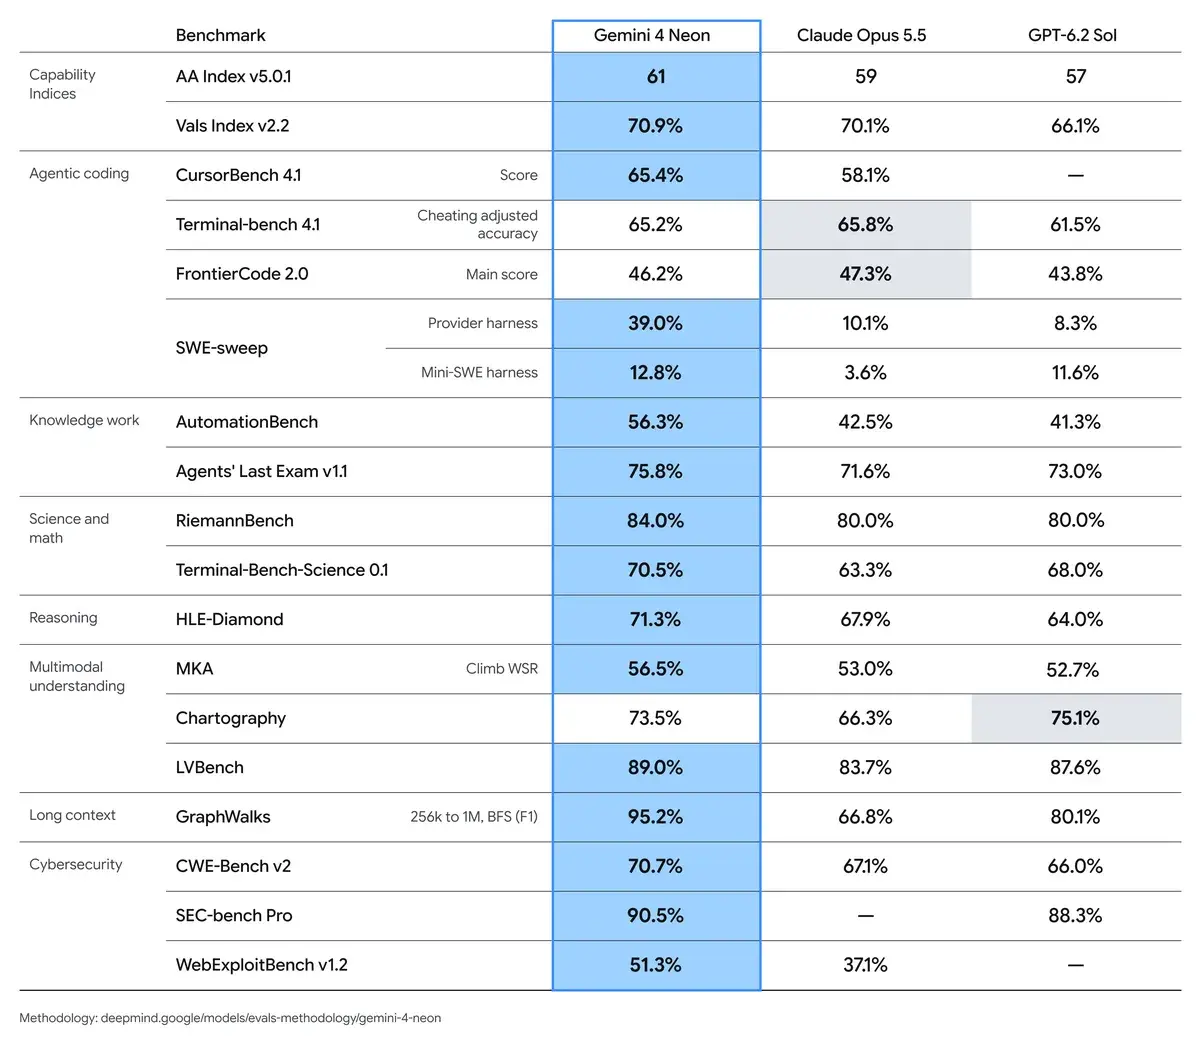
Dados de testes divulgados pelo Google mostram que a Neon alcançou uma pontuação de 70,9% no Índice Vals, ficando em primeiro lugar tanto na pesquisa jurídica quanto nos testes de agências fiscais. No teste de tarefas automatizadas Zapier AutomationBench, obteve 56,3%; na simulação de negócios de longo prazo Vending-Bench 2 da Andon Labs, a receita simulada atingiu US$ 16.843. Além disso, obteve 73,5% no teste de compreensão de gráficos profissionais de Cartografia e 75,8% no teste Último Exame dos Agentes v1.1.
Raciocínio científico e matemático também são habilidades que Neon se concentra em fortalecer. No teste Terminal-Bench Science atingiu 70,5%; na prova de matemática do RiemannBench obteve 84,0%; no teste HLE-Diamond atingiu 71,3%. Estes resultados refletem o desejo do Google de posicionar o Neon como um modelo geral não apenas adequado para programação, mas também capaz de realizar pesquisas científicas complexas, análises matemáticas e tarefas de pesquisa técnica.
A segurança cibernética é outro foco desta versão. O Google lançou uma versão dedicada do Gemini 4 Neon para trabalhos de segurança de rede, usada principalmente para geração segura de código, descoberta de vulnerabilidades, verificação de testes de penetração e reparo de código. No teste AutoBaxBench, esta versão obteve pontuação de 76% em projetos difíceis; no teste WebExploitBench v1.2 atingiu 51,26%. No teste de descoberta de vulnerabilidade SEC-bench Pro, a pontuação foi de 90,5%, e no teste de proteção de código CWE-bench v2, atingiu 70,7%.
O Google afirmou que, embora o Neon tenha melhorado seus recursos de segurança de rede, ele ainda mantém recursos de proteção contra abusos graves comparáveis ao Carbon e melhorou ainda mais a resistência do modelo à injeção imediata maliciosa. A versão específica para segurança de rede será disponibilizada aos defensores de segurança qualificados em fases através do programa Fairwind.
Em termos de segurança e confiabilidade, o Google enfatiza especialmente o controle de comportamento do Neon ao executar tarefas de longo prazo e com várias etapas. A empresa afirma que o modelo pode seguir melhor as instruções do usuário e reduzir problemas como resultados fictícios, expansão não autorizada do escopo de tarefas e atalhos que não atendem aos requisitos. Em testes internos, alguns indicadores comportamentais do Neon foram melhores que os do Carbon anterior, mas esses dados vêm principalmente do próprio sistema de avaliação do Google e ainda exigem mais testes independentes para serem verificados.
Em termos de preço, o preço padrão oferecido pelo Gemini 4 Neon por meio da API Gemini é de US$ 3 por milhão de tokens de entrada, US$ 0,15 por milhão de tokens de entrada em cache e US$ 15 por milhão de tokens de saída. Em comparação, o preço promocional atual do Carbon é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, mas esta oferta deve durar até 30 de novembro. A partir de 1º de dezembro, o preço padrão do Carbon será ajustado para US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída. Naquela época, o preço do token único do Neon será 25% menor que o do Carbon.
No entanto, a simples comparação dos preços dos tokens não reflete totalmente o custo real de uso. O Google enfatizou que o Neon pode concluir tarefas com mais rapidez e reduzir o consumo de tokens para concluir o mesmo trabalho, portanto, tem um custo de tarefa única mais baixo sob cargas de trabalho reais. De acordo com dados divulgados pelo Google, no modo de pensamento alto padrão, o custo de conclusão de tarefas do Neon é 32% menor do que o do Carbon; no modo xhigh mais alto, o Neon ainda tem uma vantagem de custo, mas a extensão específica será afetada pelo tipo de tarefa e configuração do modelo.
Gemini 4 Neon está se abrindo gradualmente. Os desenvolvedores podem usá-lo por meio de serviços pagos do Google AI Studio e Gemini API, e os clientes corporativos podem acessá-lo por meio do Gemini for Business e Antigravity. Do lado do consumidor, os assinantes do Google AI Pro e Ultra podem escolher Neon no aplicativo Gemini, e os usuários Pro e Ultra também podem experimentá-lo no Antigravity.
Em geral, a Neon não está simplesmente buscando tamanhos de modelo maiores ou pontuações mais altas em testes únicos, mas tentando resolver um problema mais importante no uso real: como fazer com que modelos com capacidades de raciocínio emblemáticas concluam o trabalho real em velocidades mais rápidas e com custos mais baixos. Para usuários que precisam ligar frequentemente para agentes de IA, processar grandes bases de código ou executar tarefas complexas de escritório, a eficiência na conclusão de tarefas pode ter um significado mais prático do que parâmetros de modelo puros e classificações de benchmark.
Comentários