Resumo:
A Microsoft lançou a tecnologia RDMA sobre USB4 para Windows 11, que permite que vários PCs comuns trabalhem juntos por meio de conexões USB4 ou Thunderbolt para compartilhar memória e poder de computação GPU, executando assim modelos de IA em grande escala que originalmente excediam a capacidade de memória de uma única máquina. Espera-se que esta tecnologia reduza o limite de hardware para inferência local de IA e permita que os desenvolvedores usem computadores existentes para construir sistemas de computação distribuídos.
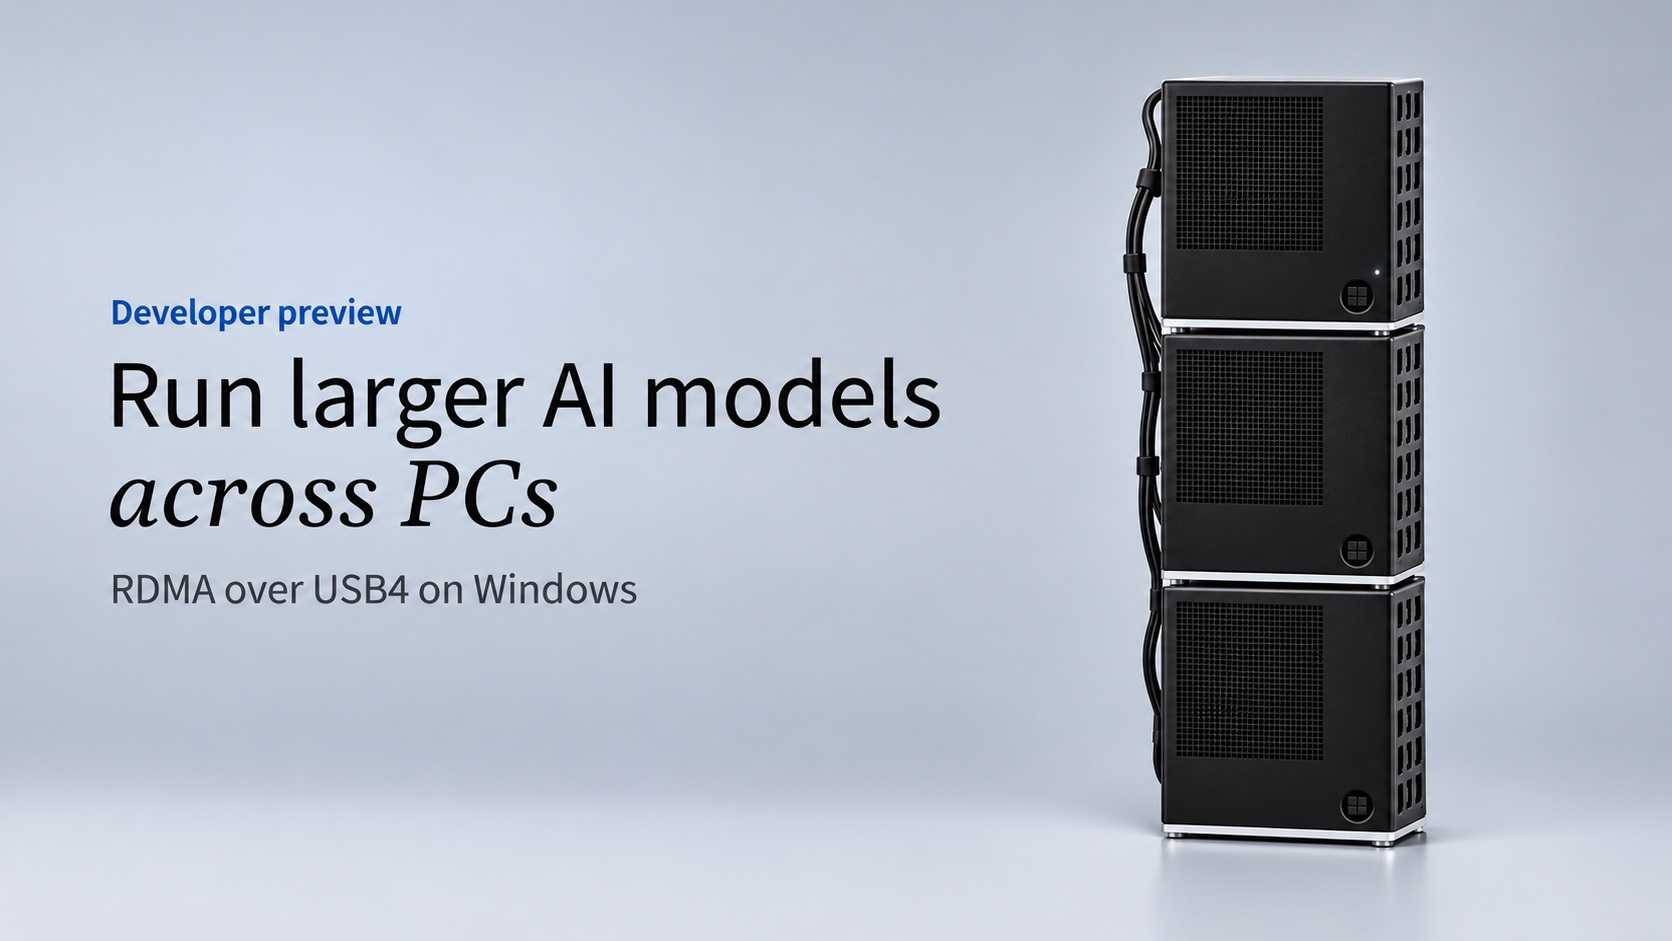
Esta tecnologia é baseada em Acesso Remoto Direto à Memória (RDMA). Ao contrário das comunicações de rede tradicionais que dependem de TCP/IP, o RDMA permite que dispositivos conectados leiam e gravem diretamente na memória uns dos outros, ignorando alguns links de processamento de rede do sistema operacional e da CPU, reduzindo assim a cópia de dados, diminuindo atrasos de comunicação e melhorando a eficiência de transmissão. Anteriormente, o RDMA era usado principalmente em servidores e data centers de alto desempenho, mas desta vez a Microsoft está introduzindo-o em PCs Windows de consumo.
A Microsoft afirma que o RDMA sobre USB4 é implementado usando a interface NetworkDirect existente e um novo provedor de software RDMA. Os dispositivos compatíveis comunicam-se diretamente via USB4 ou conexões Thunderbolt compatíveis, eliminando a necessidade de uma placa de rede RDMA dedicada ou switch de rede. Os testes mostram uma latência de ida e volta de aproximadamente 28 a 50 microssegundos ao transmitir mensagens pequenas, aproximadamente quatro vezes menor do que a comunicação Ethernet tradicional sobre USB4 baseada em UDP. Essa baixa latência é mantida tanto com conexões de 40 Gbps quanto de 80 Gbps, embora esta última tenha o dobro da largura de banda nominal.
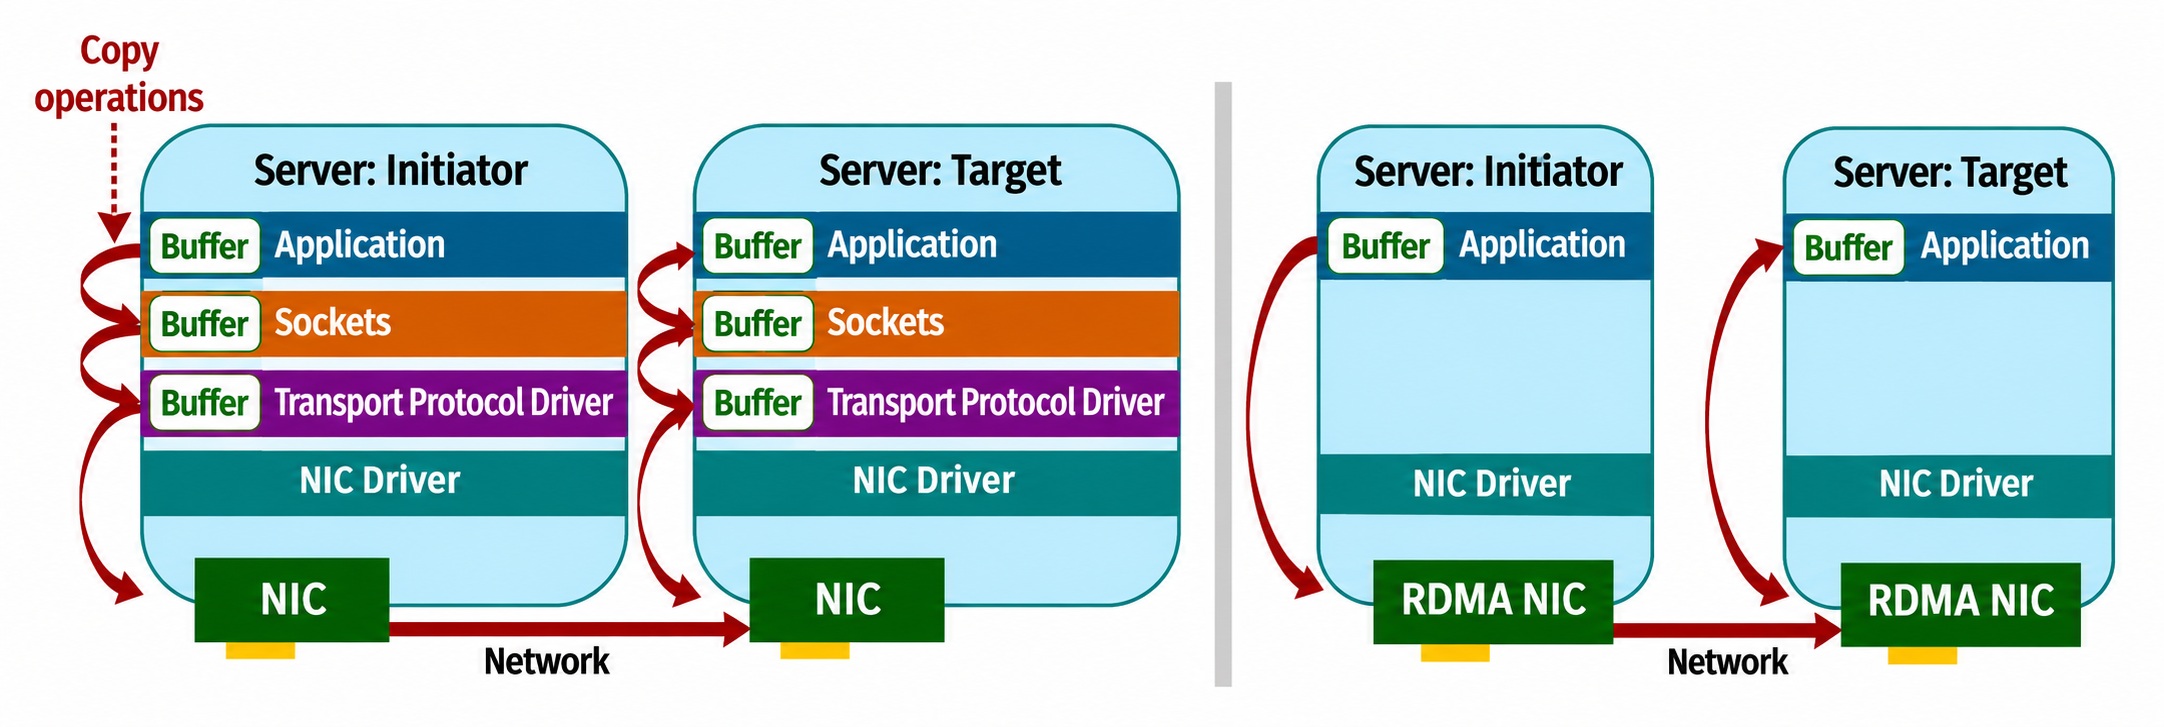
Na demonstração real, a Microsoft colaborou com a AMD para conectar três mini PCs equipados com processador Ryzen AI Max+ 395, placa gráfica Radeon 8060S e 128 GB de memória unificada por meio de uma rede USB4 de 40 Gbps totalmente interconectada. Três dispositivos executaram com sucesso o modelo especialista híbrido Qwen3-235B-A22B com 235 bilhões de parâmetros, alcançando uma velocidade de inferência de aproximadamente 18,5 tokens por segundo na quantização de 4 bits. Os testes independentes da AMD mostram que a velocidade de decodificação pode chegar a 21,98 tokens por segundo, e a velocidade de processamento de texto imediato pode chegar a 117,98 tokens por segundo.
A Intel também realizou uma demonstração semelhante usando três e quatro PCs com processadores Core Ultra Series 3, 64 GB de memória e conexões Thunderbolt 4 rodando o modelo GPT-OSS-120B. Com um comprimento de contexto de 1.000 tokens, a velocidade é de cerca de 49,4 tokens por segundo com três dispositivos, aumentando para 54,2 tokens por segundo com quatro dispositivos. É importante notar que este modelo de 120 bilhões de parâmetros não pode ser completamente carregado em um único PC com 64 GB de memória, então a colaboração entre várias máquinas se torna a chave para executar o modelo.
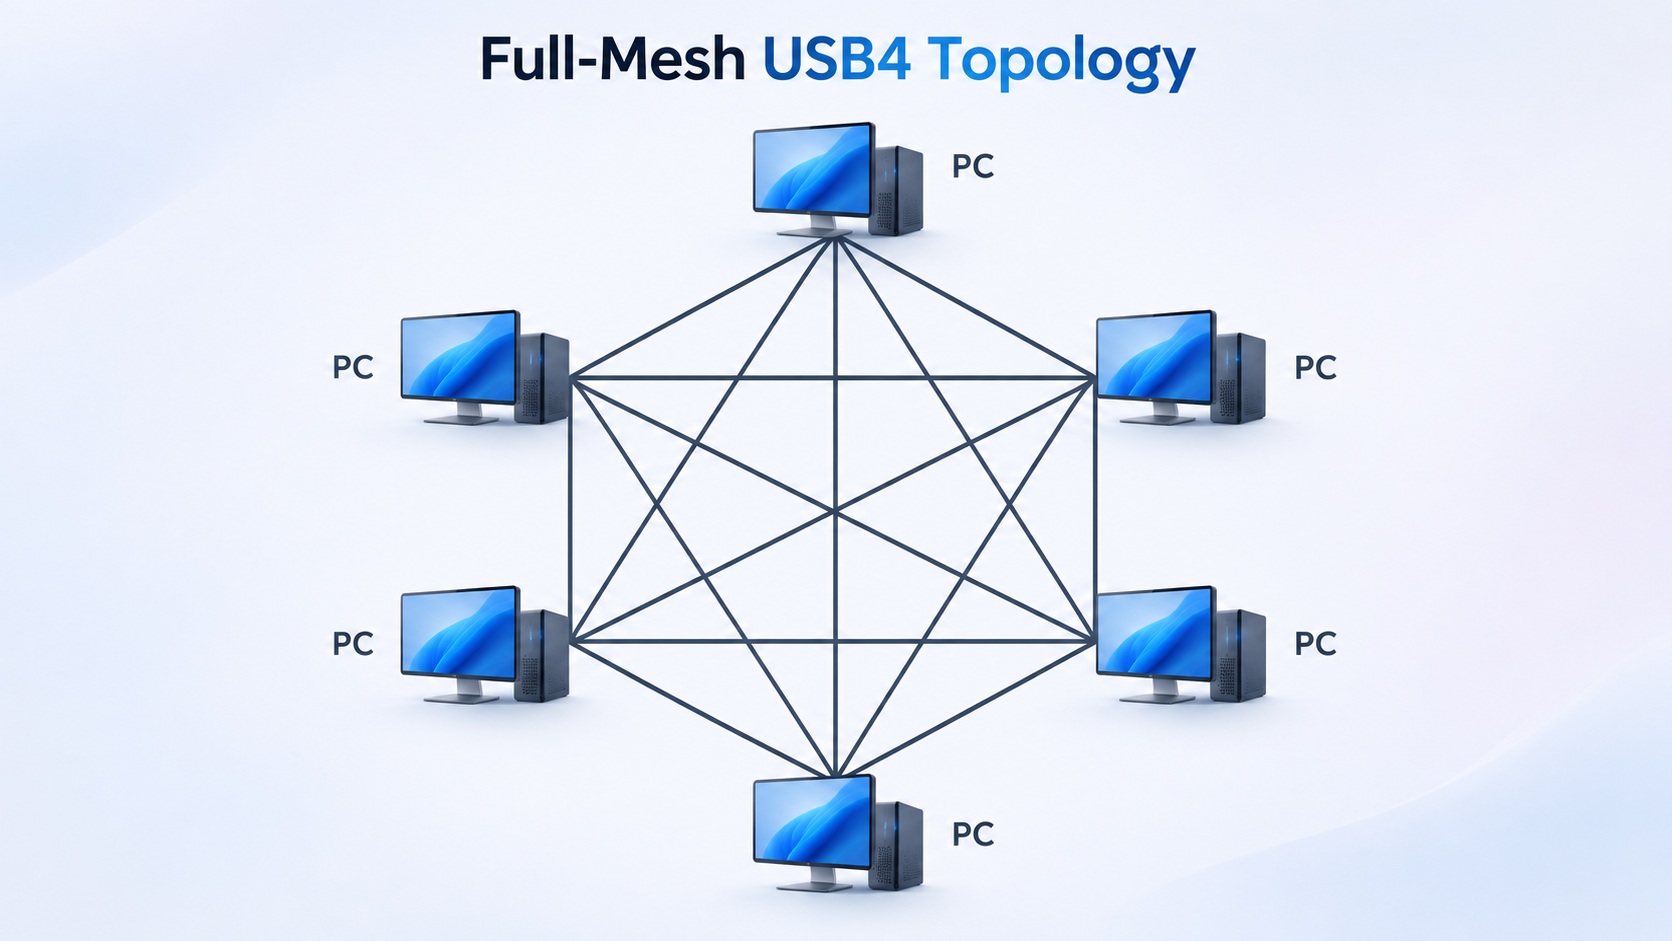
A Microsoft destacou que o RDMA sobre USB4 ainda está em fase experimental e possui altos requisitos para configuração de hardware e software. Os PCs participantes devem ter uma conexão USB4 gerenciada pelo Windows, de preferência de 40 Gbps ou superior. A Microsoft também recomenda uma topologia full-mesh, onde cada PC está diretamente conectado a todos os outros dispositivos, em vez de encadeamento em série, o que pode reduzir significativamente o desempenho.
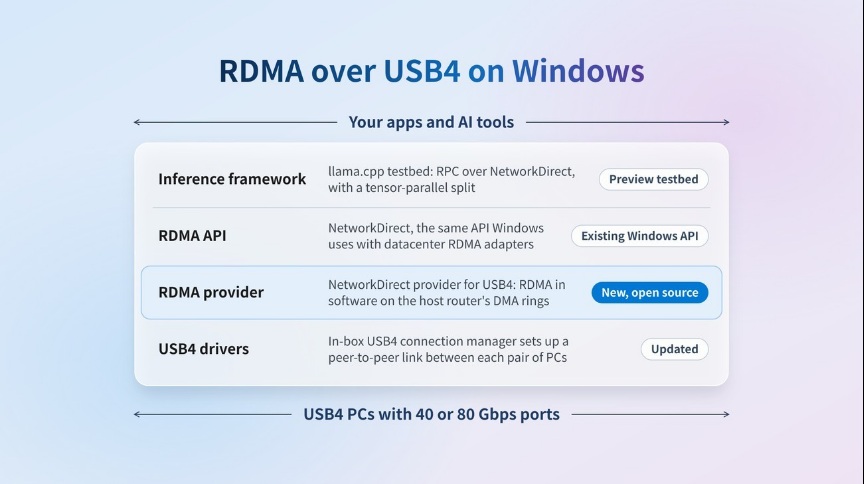
Além disso, os aplicativos devem suportar explicitamente a execução distribuída por meio de uma estrutura compatível. A Microsoft abriu o código-fonte do provedor NetworkDirect e lançou uma implementação llama.cpp modificada demonstrando a tecnologia. Espera-se que o RDMA sobre USB4 seja lançado com uma versão futura de “Plataformas Futuras” do Windows Insider Experimental Channel, mas a Microsoft ainda não anunciou um horário de lançamento específico.
Durante a fase de visualização do desenvolvedor, esse recurso fica desativado por padrão e precisa ser ativado por meio da configuração do registro e da assinatura de teste; ativar a assinatura de teste também pode exigir a desativação temporária do Secure Boot. Portanto, a Microsoft recomenda que os usuários testem em equipamentos de desenvolvimento dedicados, em vez de computadores que usam todos os dias.
Embora o prazo oficial para a adoção generalizada seja incerto, se esta tecnologia eventualmente se concretizar, poderá tornar mais comum a poderosa inferência local da IA. Os desenvolvedores podem não precisar mais comprar servidores de IA dedicados e caros, mas podem combinar os recursos de memória e GPU de vários PCs existentes para executar modelos de IA locais em maior escala.
Comentários