
Resumo:
A Microsoft anunciou oficialmente o chip de inteligência artificial de terceira geração Maia 300, desenvolvido pela própria empresa, e planeja implantá-lo em um ambiente de produção a partir de 2027 para apoiar tarefas de raciocínio de IA por trás de produtos e serviços como o Copilot. A Microsoft disse que, em comparação com o atual sistema GPU líder, espera-se que o Maia 300 seja capaz de processar 40% mais tokens por megawatt de energia; em uma configuração de rack completa composta por 96 aceleradores, seu rendimento de token em nível de rack pode ser até 7 vezes maior que o da geração anterior Maia 200.
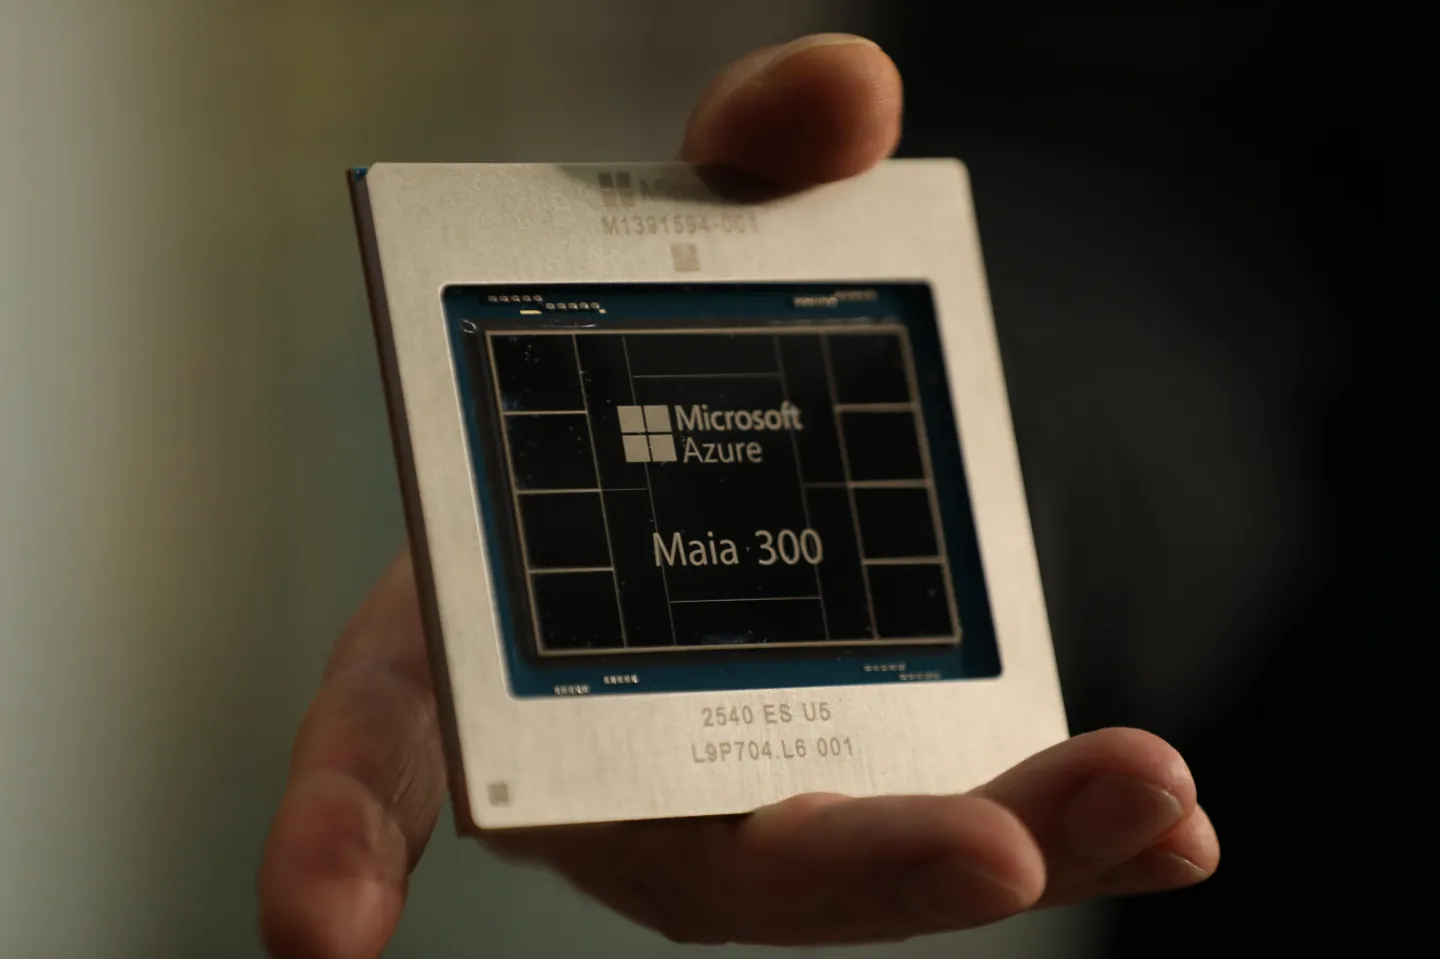
Este lançamento marca o investimento adicional da Microsoft em chips de IA desenvolvidos pela própria empresa. À medida que o uso de serviços de inteligência artificial continua a crescer, a Microsoft espera reduzir custos operacionais, melhorar a eficiência energética e reduzir a dependência de GPUs de fornecedores como Nvidia e AMD através de aceleradores autoprojetados.
Scott Guthrie, vice-presidente executivo de negócios de computação em nuvem da Microsoft, disse que a empresa planeja expandir a escala de implantação dos chips da série Azure Maia para o nível de vários gigawatts a partir de 2027 e torná-los o principal sistema de inferência de IA para produtos e serviços da Microsoft.
Esse objetivo significa que a Microsoft espera atualizar gradualmente os chips desenvolvidos por ela mesma, de parte da infraestrutura existente, para uma plataforma de computação central que suporte seus próprios serviços de IA. No entanto, isso não significa que a Microsoft deixará completamente de comprar GPUs da Nvidia ou AMD. É provável que a Microsoft continue a usar múltiplas plataformas de hardware para tarefas de treinamento e inferência que exigem diferentes capacidades computacionais.
Maia 300 é o produto de terceira geração da série Maia da Microsoft e também o chip de próxima geração lançado após o anúncio do Maia 200 em janeiro deste ano. Atualmente, o Maia 200 é usado para cargas de trabalho de IA em vários ambientes de produção da Microsoft, incluindo Microsoft Copilot, GitHub Copilot, Microsoft Foundry e modelos de inteligência artificial desenvolvidos pela própria Microsoft.
Guthrie disse que, a julgar pelos indicadores operacionais dos serviços reais de IA, o Maia 200 já é uma das infraestruturas de IA com melhor desempenho dentro da Microsoft. A nova geração do Maia 300 foi projetada especificamente para cargas de trabalho de IA em constante mudança, especialmente aquelas que precisam lidar com raciocínios de longo contexto, conversas em tempo real que são altamente sensíveis à latência e tarefas de agentes de IA que executam continuamente múltiplas etapas.
Esses aplicativos impõem requisitos de hardware diferentes aos da inferência de IA tradicional.
À medida que modelos de linguagem em grande escala são gradualmente usados em assistentes de programação, automação empresarial e execução de tarefas complexas, o contexto que os sistemas de IA precisam processar está se tornando cada vez mais longo, e uma única tarefa envolve cada vez mais chamadas de modelo e operações de ferramentas. Para os provedores de serviços em nuvem, além do desempenho do modelo em si, também devem ser considerados a latência de resposta, o número de solicitações simultâneas, a capacidade de memória e o custo real de cada inferência.
Portanto, o foco do design do Maia 300 não é apenas aumentar o pico de potência computacional, mas também melhorar a eficiência geral em um ambiente de negócios real que funciona continuamente. A Microsoft espera otimizar especificamente a arquitetura do chip para torná-la mais adequada para lidar com a carga computacional gerada por modelos de inferência e agentes de IA de nova geração.
Em termos de fabricação de chips, o Maia 300 adota o processo avançado N2P da TSMC e introduz uma arquitetura de design baseada em núcleo. Em comparação com os designs tradicionais que integram diferentes funções em um único chip grande, a arquitetura do chip principal pode dividir funções como computação, controlador de memória e entrada e saída em módulos diferentes e, em seguida, projetá-los de acordo com suas respectivas características.
A equipe de hardware e infraestrutura do Microsoft Azure afirmou que esse design permite que mais área de silício no chip seja usada para desempenho computacional, ao mesmo tempo que permite que diferentes módulos funcionais adotem tecnologias mais adequadas às suas próprias necessidades.
Essa ideia tem significado prático. Para aceleradores de IA, a unidade de computação é importante, mas a forma como os dados são transmitidos entre a unidade de computação, a memória e os dispositivos externos também afetará o desempenho geral. Se a unidade de computação precisar esperar a chegada dos dados, mesmo que tenha alto poder computacional teórico, ela não será capaz de dar pleno desempenho ao seu desempenho.
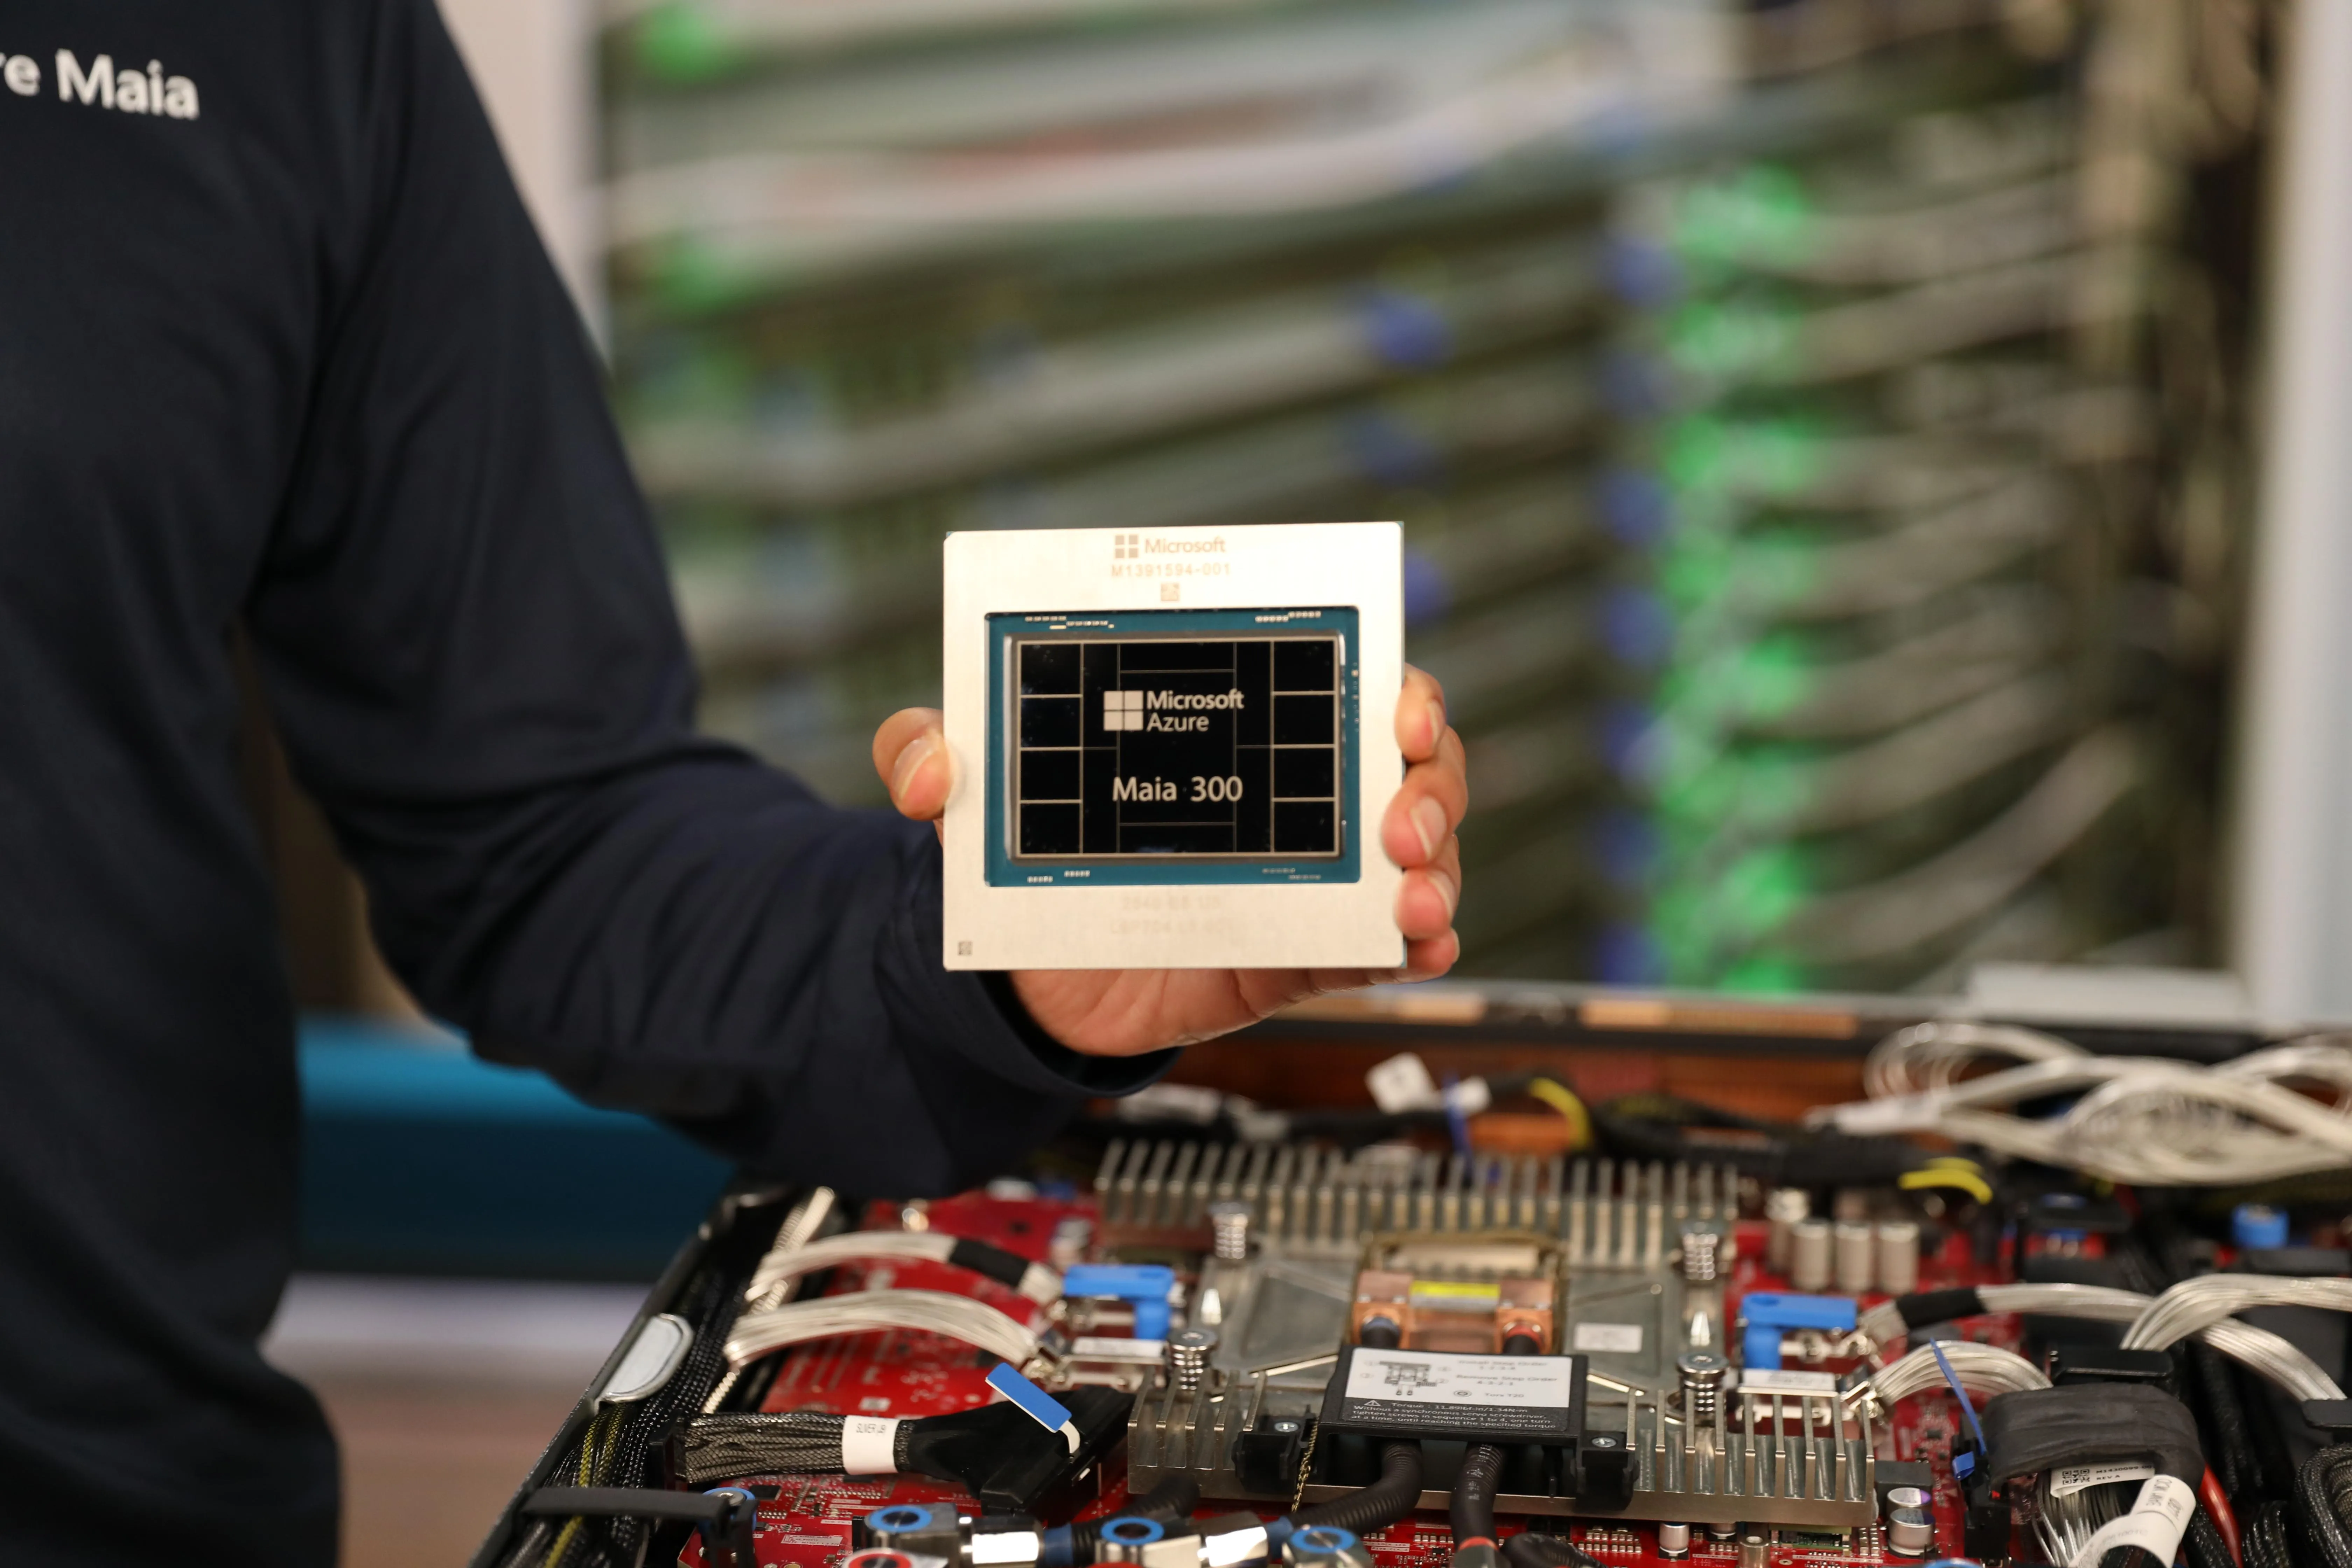
Ao otimizar a computação, o controle de memória e as funções de entrada e saída separadamente, a Microsoft espera melhorar a eficiência geral de utilização de recursos do chip e alcançar um melhor equilíbrio entre desempenho, consumo de energia e custos de fabricação.
O uso de processos avançados também ajudará a melhorar a densidade do transistor e a eficiência energética, mas o desempenho final do chip ainda depende de vários fatores, como microarquitetura, subsistema de memória, design de interconexão e otimização de software. Os dados de desempenho divulgados pelo Maia 300 atualmente vêm principalmente da introdução da própria Microsoft, e o efeito real ainda precisa ser avaliado com base em diferentes modelos, cargas de trabalho e condições de implantação.
No campo do raciocínio de IA, o rendimento do token é um dos indicadores importantes para medir a eficiência do sistema. Token é a unidade básica de dados usada por grandes modelos de linguagem ao processar texto, geralmente correspondendo a uma palavra, fragmento de palavra ou outra unidade de texto. Quantos tokens o sistema pode processar por unidade de tempo afeta diretamente quantos usuários ele atende ao mesmo tempo e os recursos de computação necessários para concluir a tarefa.
A Microsoft espera que o Maia 300 lide com 40% mais tokens por megawatt do que os principais sistemas de GPU. Isto significa que, com o mesmo orçamento de energia, espera-se que a Microsoft processe mais solicitações de IA ou reduza o consumo de energia, ao mesmo tempo que fornece as mesmas capacidades de serviço.
Para provedores de serviços em nuvem com data centers de grande escala, essa melhoria na eficiência pode trazer um valor econômico significativo. Os data centers de IA não só precisam comprar aceleradores caros, mas também devem arcar com os custos de fornecimento de energia, resfriamento, equipamentos de rede e construção de infraestrutura. À medida que o uso do modelo continua a crescer, o fornecimento de energia e a capacidade do data center estão se tornando fatores importantes que restringem a expansão dos serviços de IA.
No entanto, a eficiência do token por megawatt não é o único indicador para medir chips de IA. A escala dos parâmetros, o comprimento do contexto, as configurações de precisão e os métodos de inferência de diferentes modelos afetarão os resultados do teste. Para comparar produtos como Maia 300 e GPUs NVIDIA de forma abrangente, também é necessário considerar a latência, a compatibilidade do modelo, o ecossistema de software, os custos de implantação e a estabilidade nos negócios reais.
A Microsoft também anunciou um indicador mais atraente: em uma configuração de rack completa composta por 96 aceleradores, o rendimento de token em nível de rack do Maia 300 pode chegar até 7 vezes maior que o do Maia 200.
Esta figura mostra que a Microsoft não apenas espera melhorar a eficiência de um único chip, mas também otimizar o poder de computação de todo o rack. Mas descreve o rendimento em nível de rack sob uma configuração específica. Isso não significa que o Maia 300 seja 7 vezes mais rápido que o Maia 200 em todas as tarefas, nem se pode deduzir diretamente que o desempenho de cada chip melhorou na mesma proporção.
Para plataformas de computação em nuvem, o desempenho em nível de rack é especialmente importante. As implantações no mundo real normalmente consistem em um grande número de aceleradores, com os chips trocando dados por meio de interconexões de alta velocidade e processando conjuntamente solicitações de modelo. Mesmo que um único chip seja poderoso, todo o sistema ainda pode ser limitado se a largura de banda de interconexão, a capacidade de memória ou a eficiência de agendamento forem insuficientes.
Portanto, a Microsoft está tentando realizar uma otimização geral desde o design do chip, configuração do rack até software e ambiente operacional do modelo, em vez de simplesmente buscar o poder de computação teórico do processador.
O chefe de IA da Microsoft, Mustafa Suleyman, disse que a empresa deve começar a investir na base de toda a pilha de tecnologia, incluindo o design de chips. Ele acredita que quando os serviços de IA atingirem uma escala tão grande, a Microsoft precisará ter sua própria plataforma e permitir que chips e modelos autodesenvolvidos sejam co-projetados e otimizados.
Ele enfatizou particularmente que permitir que os modelos de IA desenvolvidos pela Microsoft sejam executados em chips Maia é uma tarefa importante para a equipe de IA da Microsoft.
Esta declaração revela outro objetivo do desenvolvimento de chips de desenvolvimento próprio da Microsoft: combinar hardware, modelos e serviços em nuvem para formar um relacionamento colaborativo mais próximo.
Os provedores de serviços de nuvem tradicionais podem implantar modelos de IA comprando GPUs de uso geral, mas se puderem projetar seus próprios aceleradores, poderão otimizar as características de computação, os requisitos de memória e os processos de inferência de seus próprios modelos. Por sua vez, a equipe modelo pode ajustar a estrutura do modelo e o método de operação de acordo com a arquitetura do chip, melhorando assim a eficiência geral.
O Google e a Amazon investem em chips de IA desenvolvidos por eles mesmos há muitos anos. O Google possui uma série de aceleradores TPU, e a Amazon desenvolveu chips como o Trainium para oferecer suporte a seus próprios serviços de computação em nuvem e inteligência artificial. A Microsoft lançou a série Maia para fortalecer as suas capacidades de infra-estrutura neste contexto competitivo.
Para a Microsoft, o valor estratégico dos chips desenvolvidos pela própria empresa não é apenas reduzir os custos de aquisição, mas também melhorar a autonomia da cadeia de fornecimento, otimizar a utilização de energia do data center e ter maior controle de design de hardware quando os modelos e serviços de IA são rapidamente iterados.
Atualmente, a Microsoft ainda mantém uma estreita cooperação com a NVIDIA, e as GPUs NVIDIA continuam a desempenhar um papel importante no campo do treinamento e inferência de IA. O desenvolvimento simultâneo da série Maia pela Microsoft não significa que a relação entre as duas partes irá inevitavelmente mudar fundamentalmente, mas reflecte que os grandes fornecedores de serviços em nuvem estão a reduzir a sua dependência de uma única plataforma de hardware através de chips auto-desenvolvidos e estratégias de vários fornecedores.
A Microsoft também espera usar chips de desenvolvimento próprio para melhorar a competitividade dos seus modelos de IA. Suleiman disse que a plataforma Maia é uma parte importante do sistema de tecnologia de IA da Microsoft e pode ajudar a empresa a desenvolver ainda mais seus próprios modelos e melhorar sua competitividade contra concorrentes como Google DeepMind, OpenAI e Anthropic.
À medida que os modelos de IA evoluem gradualmente de ferramentas simples de geração de texto para sistemas de agentes que podem chamar ferramentas e executar operações complexas, a importância da infraestrutura de hardware também aumenta. O raciocínio de longo contexto e a execução de tarefas em várias etapas geralmente envolvem processos computacionais mais longos e um grande número de chamadas de modelo. Somente alcançando um melhor equilíbrio entre desempenho, latência e custo as empresas poderão dimensionar seus serviços de maneira sustentável.
Maia 300 foi concebido em resposta a esta tendência. A Microsoft espera permitir que mais tarefas de IA sejam executadas com custos mais baixos por meio de maior rendimento e eficiência energética, ao mesmo tempo que fornece suporte computacional para Copilot, GitHub Copilot e futuros serviços de agente de IA.
No entanto, para que o Maia 300 se torne verdadeiramente a principal força da infraestrutura de IA da Microsoft, ele ainda precisa passar pelo processo desde a fabricação do chip, integração do sistema até a implantação em larga escala. A Microsoft planeja começar a colocá-lo em produção em 2027 e expandir gradualmente a escala de implantação. Até então, a capacidade real de produção do chip, a estabilidade do sistema, a adaptação do software e a integração com os data centers existentes afetarão o escopo final da sua aplicação.
No geral, o lançamento do Maia 300 mostra que a Microsoft está elevando os chips de IA de projetos de infraestrutura auxiliares a um componente central de sua própria estratégia de inteligência artificial. Ao usar os processos avançados da TSMC, o design granular central e a otimização em nível de sistema para cargas de trabalho de inferência, a Microsoft espera melhorar os recursos de serviço de IA que pode fornecer por unidade de eletricidade e reduzir sua dependência de fornecedores externos de GPU.
Se a Microsoft conseguir expandir a implantação de produção do Maia 300 conforme planejado em 2027 e alcançar as melhorias de eficiência esperadas nos negócios reais, espera-se que esta série de chips se torne uma ferramenta importante para controlar os custos de computação de IA e expandir a escala de serviço. Mas a sua competitividade a longo prazo depende, em última análise, do desempenho operacional real e da capacidade da Microsoft de estabelecer um sistema de otimização colaborativa sustentado e eficaz entre hardware, modelos e software.
Comentários