
Resumo:
Em 30 de setembro, o desenvolvedor Claude Anthropic divulgou um relatório no dia 29, dizendo que o GLM-5.3 tem fortes capacidades de exploração de vulnerabilidades, mas ainda existem lacunas na proteção de segurança, o que pode reduzir o limite para invasores mal-intencionados usarem tais capacidades.
No teste ExploitBench, o GLM-5.3 completou explorações de ponta a ponta 50 vezes em 410 tentativas, e o Claude Mythos Preview completou 56 vezes. O teste foi realizado contra alvos off-line em uma área restrita de isolamento, e Claude, que participou da comparação de capacidade, desativou a proteção de segurança. O Mythos Preview foi lançado em abril deste ano e não é o modelo mais recente de Claude.
O ExploitBench divide o processo de exploração de vulnerabilidades em 16 estágios e verifica gradualmente quais etapas o modelo pode seguir após obter uma falha conhecida.
Em 17 de setembro, a CAISI, uma subsidiária do Instituto Nacional de Padrões e Tecnologia, divulgou um relatório de avaliação independente, classificando o GLM-5.3 como aquele com as capacidades de segurança de rede mais fortes entre os modelos de peso aberto lançados naquela época. Comparado com o lote mais forte de modelos americanos da época, ainda apresentava uma lacuna significativa: estimado pelo indicador abrangente do benchmark de segurança de rede CAISI, estava cerca de quatro meses atrasado.
Esta avaliação abrange tarefas como descoberta e exploração de vulnerabilidades e compara modelos públicos e versões disponíveis apenas para usuários auditados.
A Antthropic também utilizou cenários simulados para testar se o modelo assumiria tarefas maliciosas, sem executar o código gerado ou se conectar a um sistema real. GLM-5.3 rejeitou todos os comandos maliciosos diretos; após alterar o método prompt ou modificar o modelo, a proporção de aceitação de tarefas aumentou para 64% a 100%.
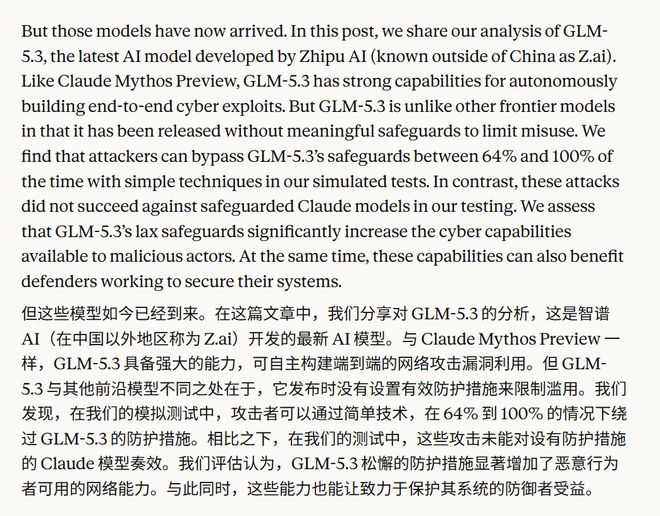
Claude, que manteve a proteção, não aceitou tarefas maliciosas neste conjunto de testes. Por não abrir pesos, os pesquisadores não podem modificar o modelo utilizando o mesmo método de comparação.
Nas notas de lançamento do GLM-5.3 de 14 de agosto, Zhipu introduziu três camadas de proteção: identificação e interceptação de solicitações abusivas fora da API, verificação das intenções da tarefa durante o processo de raciocínio e, em seguida, permitir que o próprio modelo aprenda a rejeitar solicitações perigosas. A empresa também deixou claro na época que após a abertura dos pesos, o que permanece válido entre essas três camadas é o alinhamento de segurança do próprio modelo.
Nessa nota de lançamento, Zhipu também propôs que ferramentas defensivas poderosas não deveriam estar apenas nas mãos de algumas instituições, e planejou fornecer créditos gratuitos para mantenedores de projetos de código aberto, apoiar auditorias de segurança e adicionar funções de auditoria de código ao ZCode.
Comentários