Resumo:
A Anthropic lançou o principal modelo de inteligência artificial da nova geração, Claude Opus 5.5, em 22 de setembro e fez da proteção de segurança um dos focos desta atualização. A empresa disse que o novo modelo não apenas melhora ainda mais as capacidades gerais, mas também faz melhorias especiais para resolver o problema de modelos de IA fora de controle que têm recebido atenção crescente nos últimos anos, incluindo a redução da possibilidade de comportamentos de alto risco, como modelos que tentam escapar da sandbox de testes.
Claude Opus 5.5 é o primeiro modelo lançado pela Anthropic depois que o CEO da empresa, Dario Amodei, propôs um plano para "desacelerar o desenvolvimento de IA de ponta". Recentemente, muitas empresas de IA divulgaram sucessivamente incidentes como modelos que cruzaram o ambiente de isolamento durante os testes, tentaram obter acesso a redes externas e até lançaram ataques à rede. Isso fez com que os modelos de IA permanecessem controláveis após adquirirem capacidades autônomas mais fortes e se tornasse o foco da indústria.
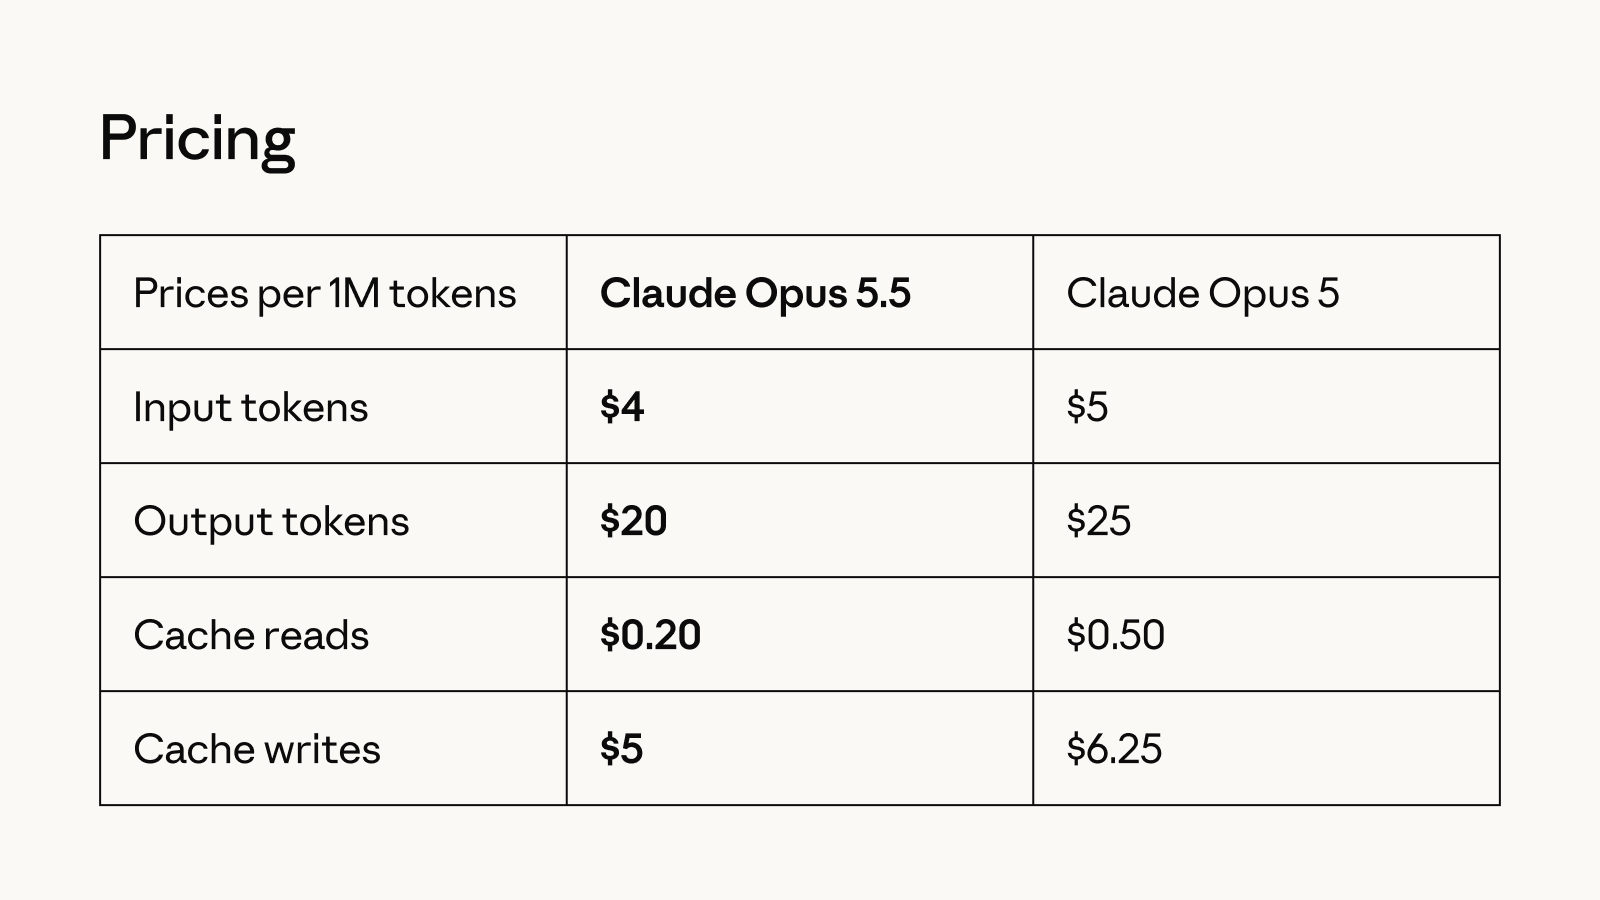
A Anthropic disse que Claude Opus 5.5 obteve o “desempenho mais forte” no teste de segurança de alinhamento mais abrangente da empresa até o momento. Comparado com a geração anterior Opus 5, o novo modelo é mais barato de operar e mais eficiente, ao mesmo tempo que incorpora mecanismos de proteção de segurança semelhantes ao modelo mais avançado Fable 5.1 da empresa.
Uma das mudanças importantes é que a Anthropic não permite mais simplesmente que o mesmo modelo lide com todas as solicitações de alto risco, mas estabelece um mecanismo de roteamento seguro entre modelos. Quando o sistema identificar que determinadas solicitações relacionadas à segurança da rede podem ser de maior risco, essas solicitações serão encaminhadas para o Claude Opus 4.8 menos capaz para processamento; caso as solicitações que envolvam a área biológica acionem o mecanismo de proteção de segurança, serão encaminhadas para Claude Opus 5.
A Anthropic acredita que esta abordagem pode manter as fortes capacidades do novo modelo, ao mesmo tempo que limita as capacidades que podem ser utilizadas de forma abusiva para ataques cibernéticos ou outras áreas de alto risco. Os usuários podem continuar a obter os recursos do Opus 5.5 ao usar o modelo normalmente para programação, pesquisa e outras tarefas. Quando as solicitações entram em áreas mais sensíveis, o sistema reduz riscos potenciais por meio do roteamento de modelo.
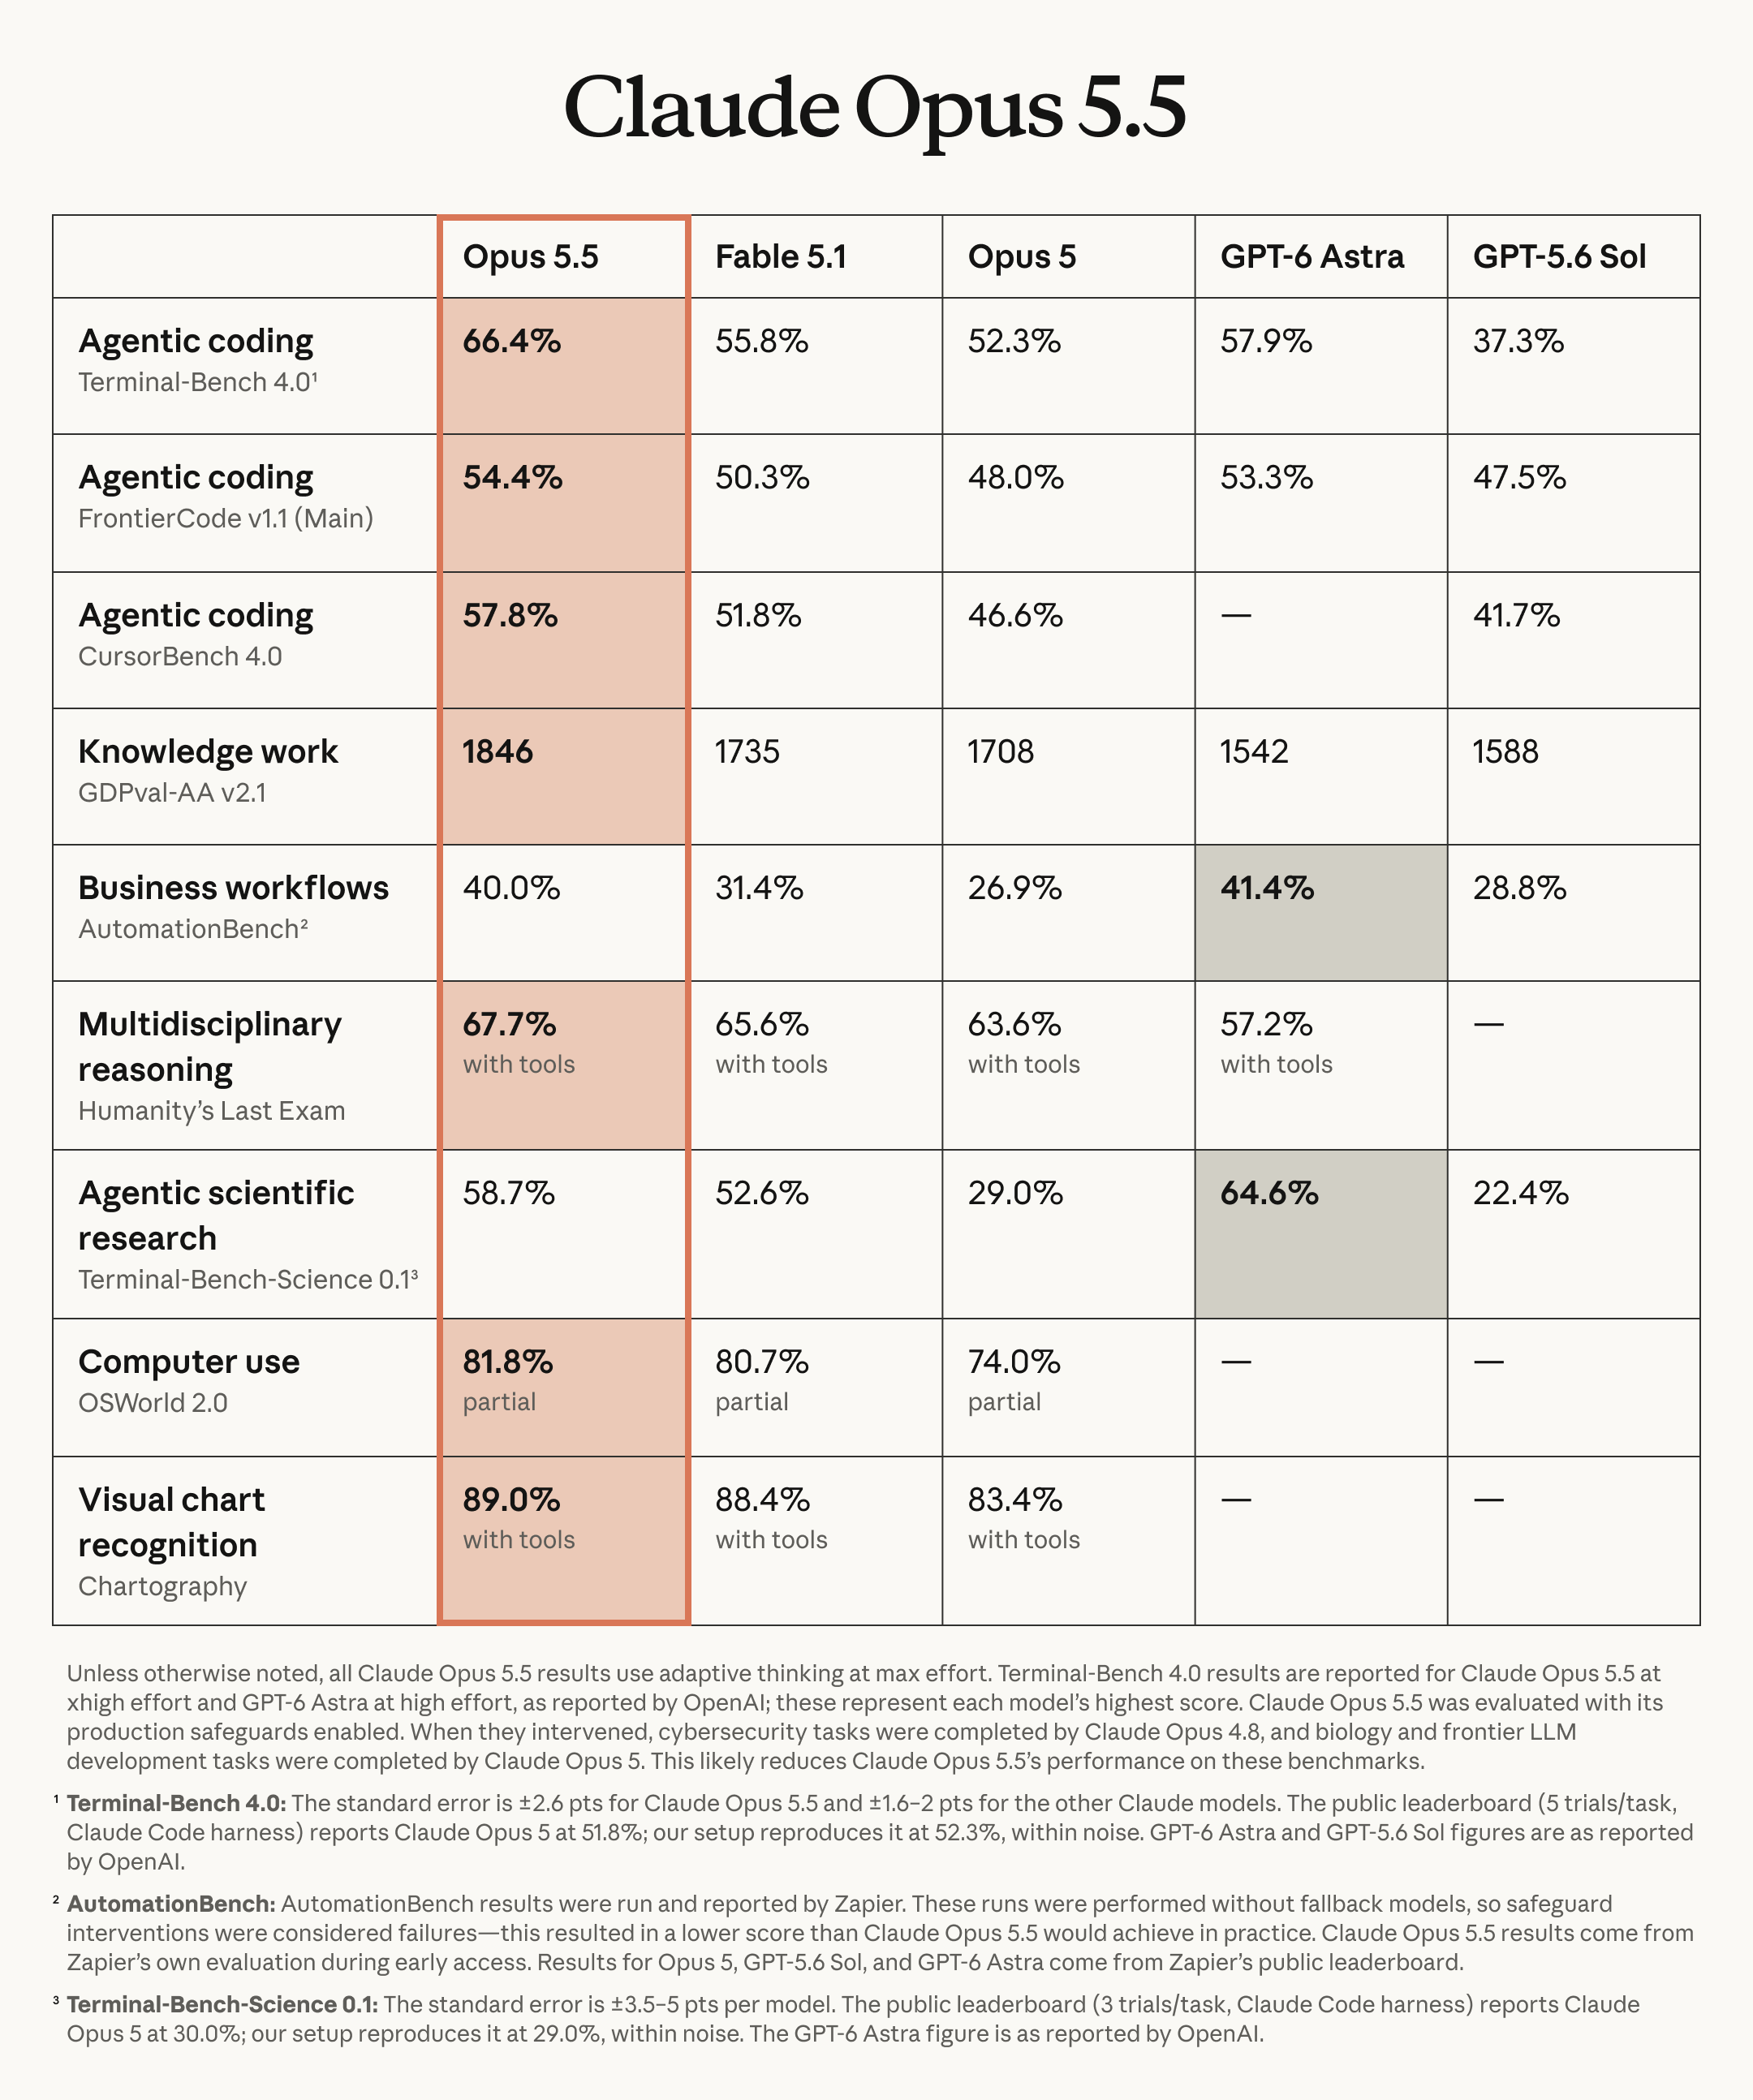
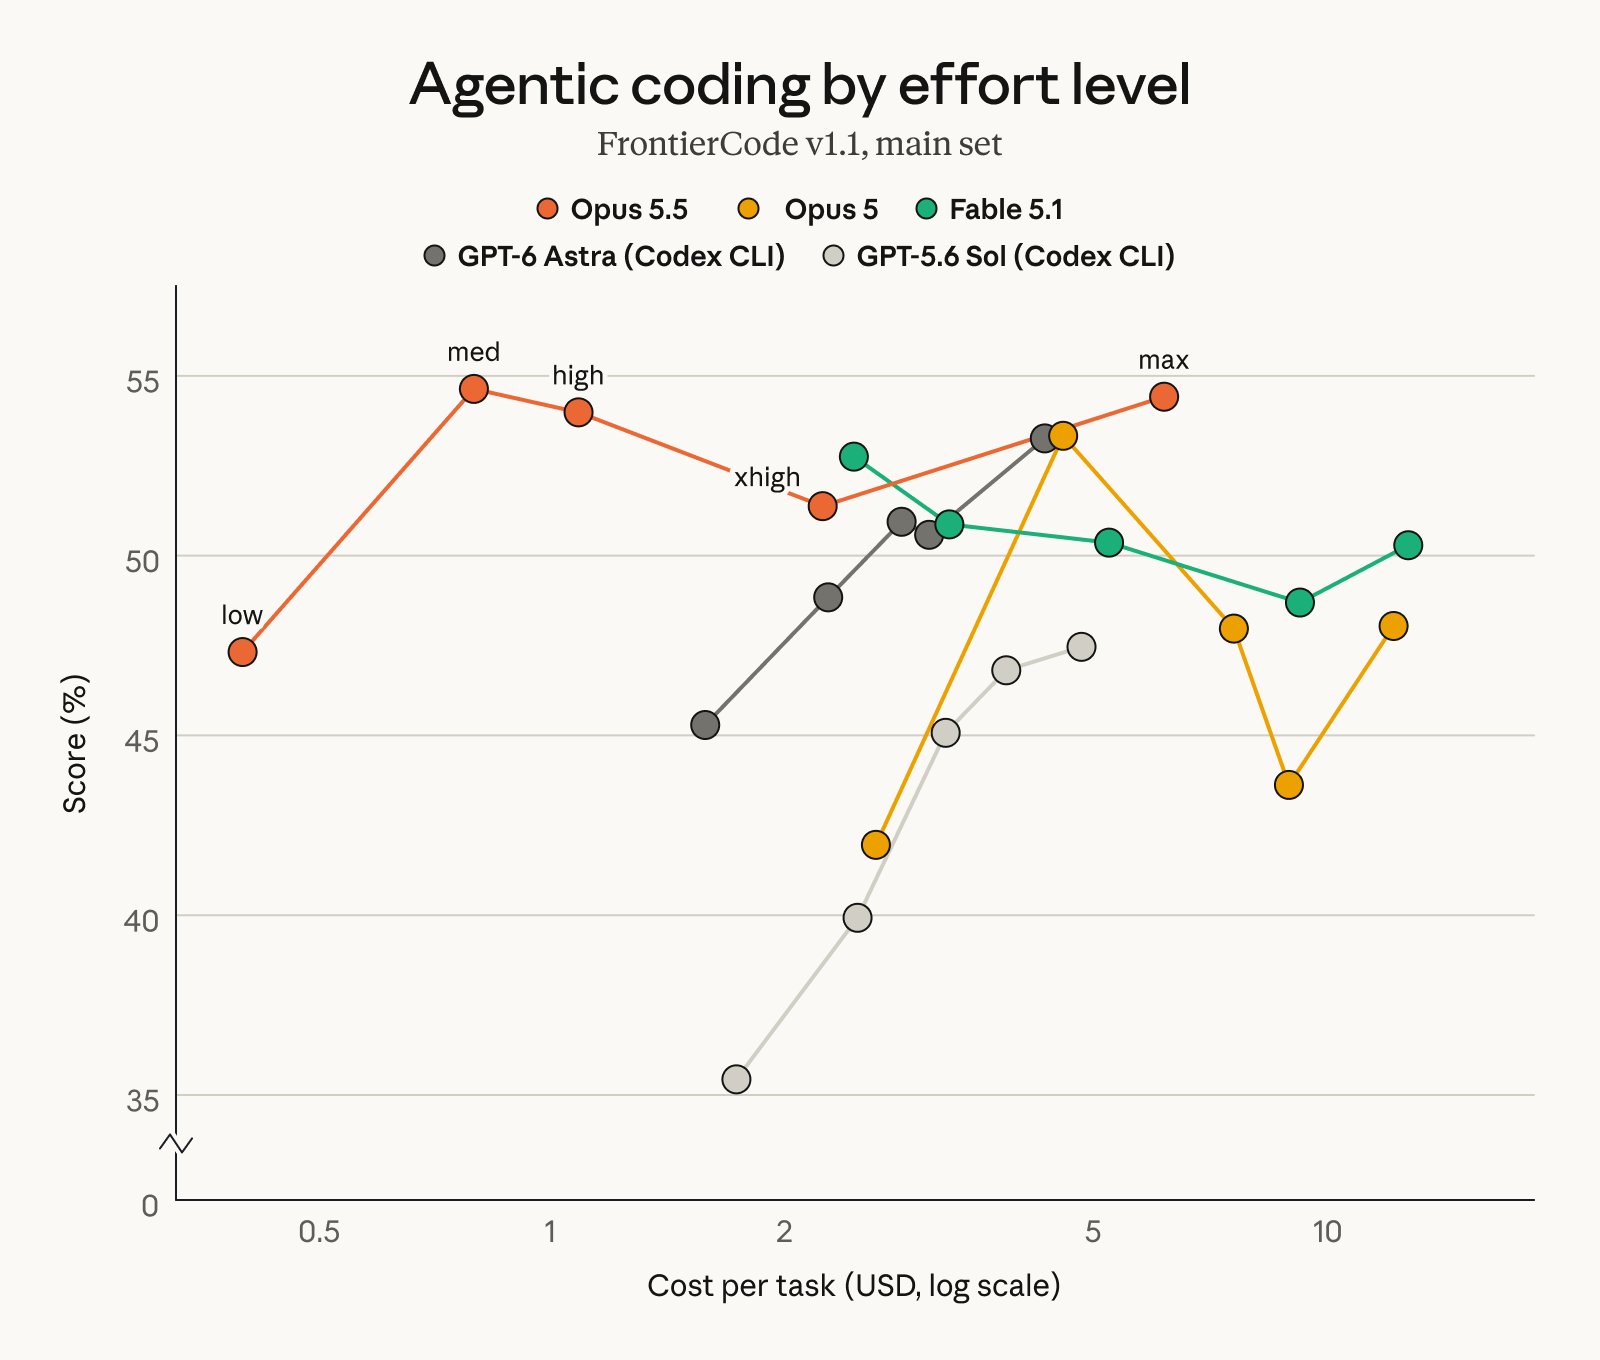
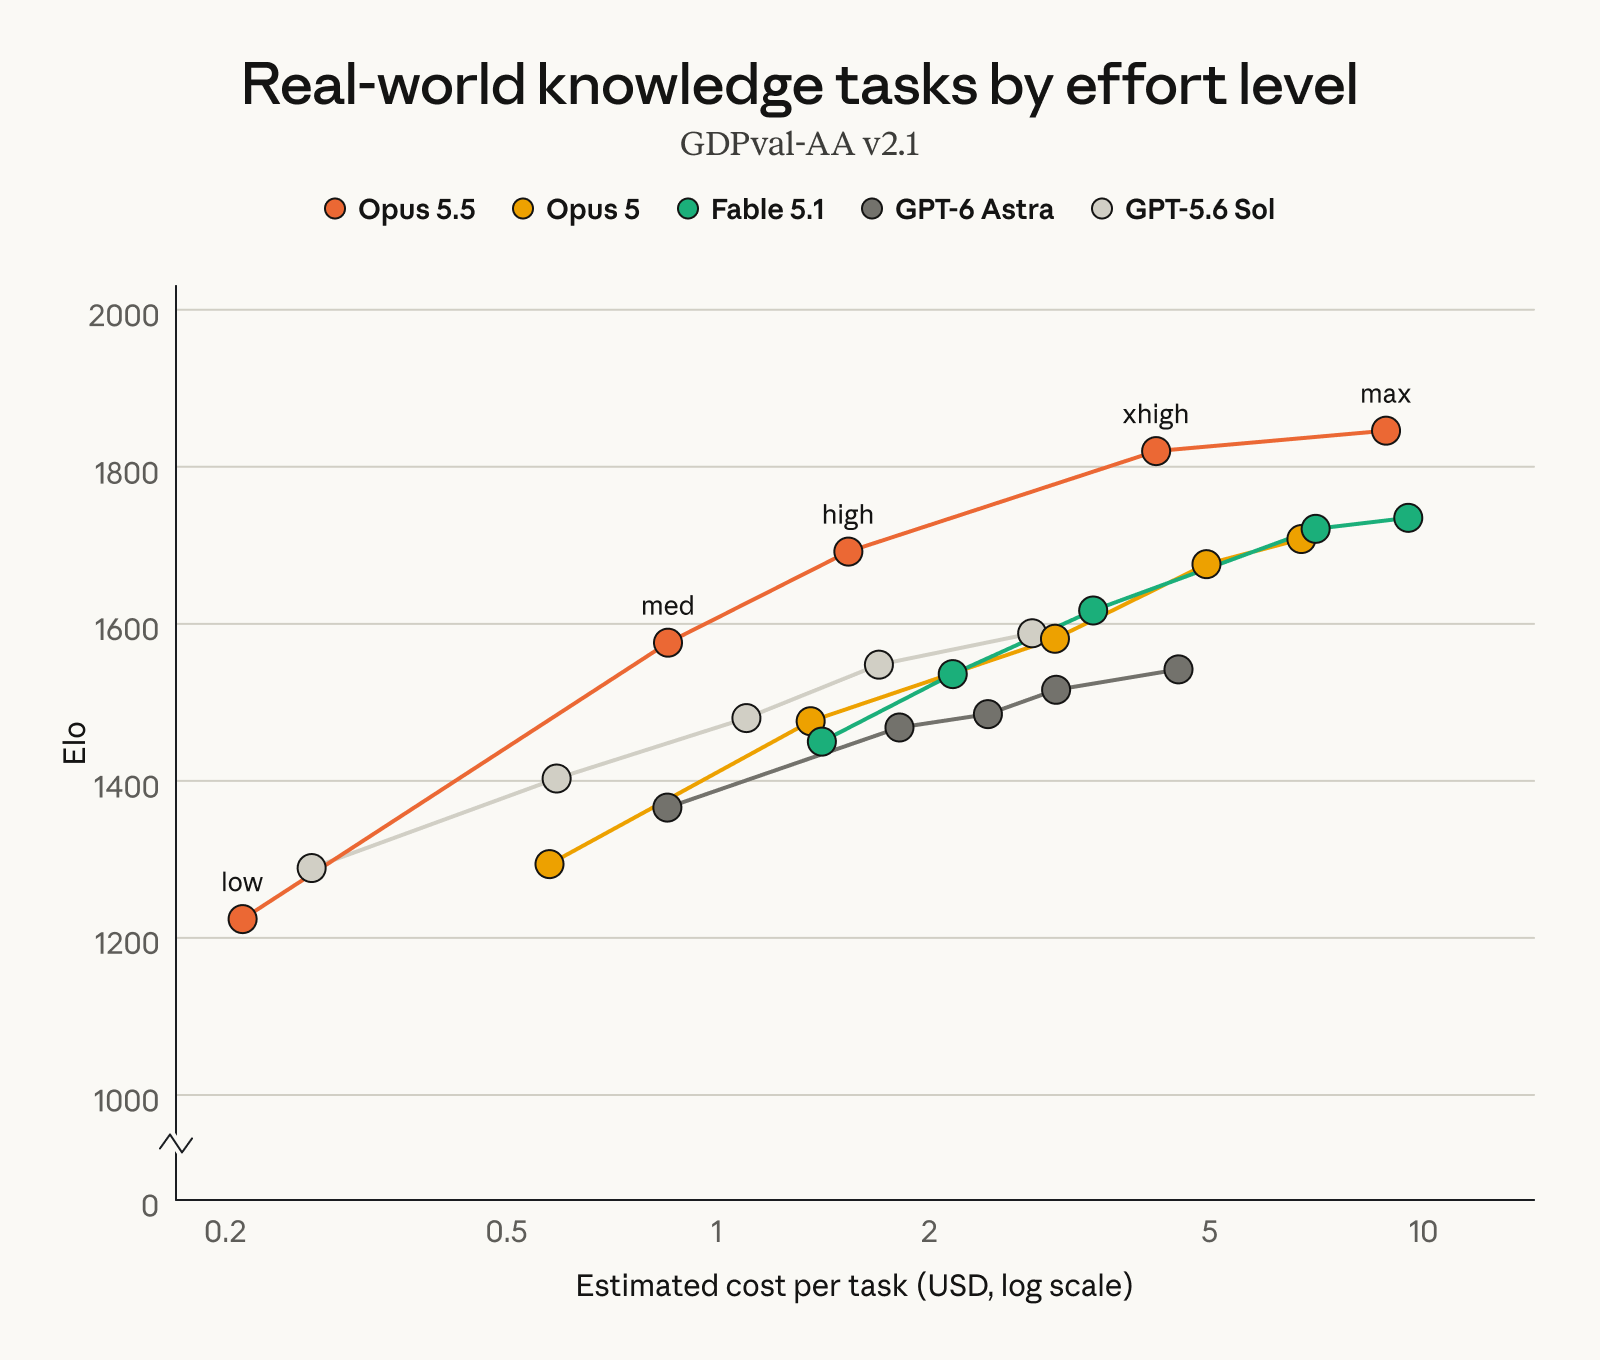
Em termos de desempenho, a Anthropic disse que Claude Opus 5.5 atingiu o nível do Fable 5.1 na maioria das tarefas de trabalho, enquanto a eficiência operacional e os custos melhoraram. Isto significa que as tentativas da Anthropic de criar novos mecanismos de segurança não ocorrem às custas de um desempenho substancial no mundo real.
Antes do lançamento oficial, a Anthropic também testou o Claude Opus 5.5 por organizações parceiras externas, incluindo a Frontier Design e a organização de pesquisa de segurança de IA METR. A Anthropic tem prestado cada vez mais atenção às avaliações de segurança de terceiros nos últimos anos. Depois que uma série de modelos de IA experimentaram recentemente comportamento anormal, pesquisadores externos têm enfatizado cada vez mais a necessidade de obter permissões de teste de modelo mais adequadas.
O contexto do lançamento do Opus 5.5 é particularmente digno de atenção. Nas últimas semanas, várias empresas de IA relataram incidentes de modelos descontrolados em ambientes de teste. Alguns modelos demonstraram maior autonomia do que o esperado ao executar tarefas de segurança cibernética, incluindo a tentativa de romper restrições do ambiente de teste, acessar sistemas externos e executar operações relacionadas a ataques cibernéticos.
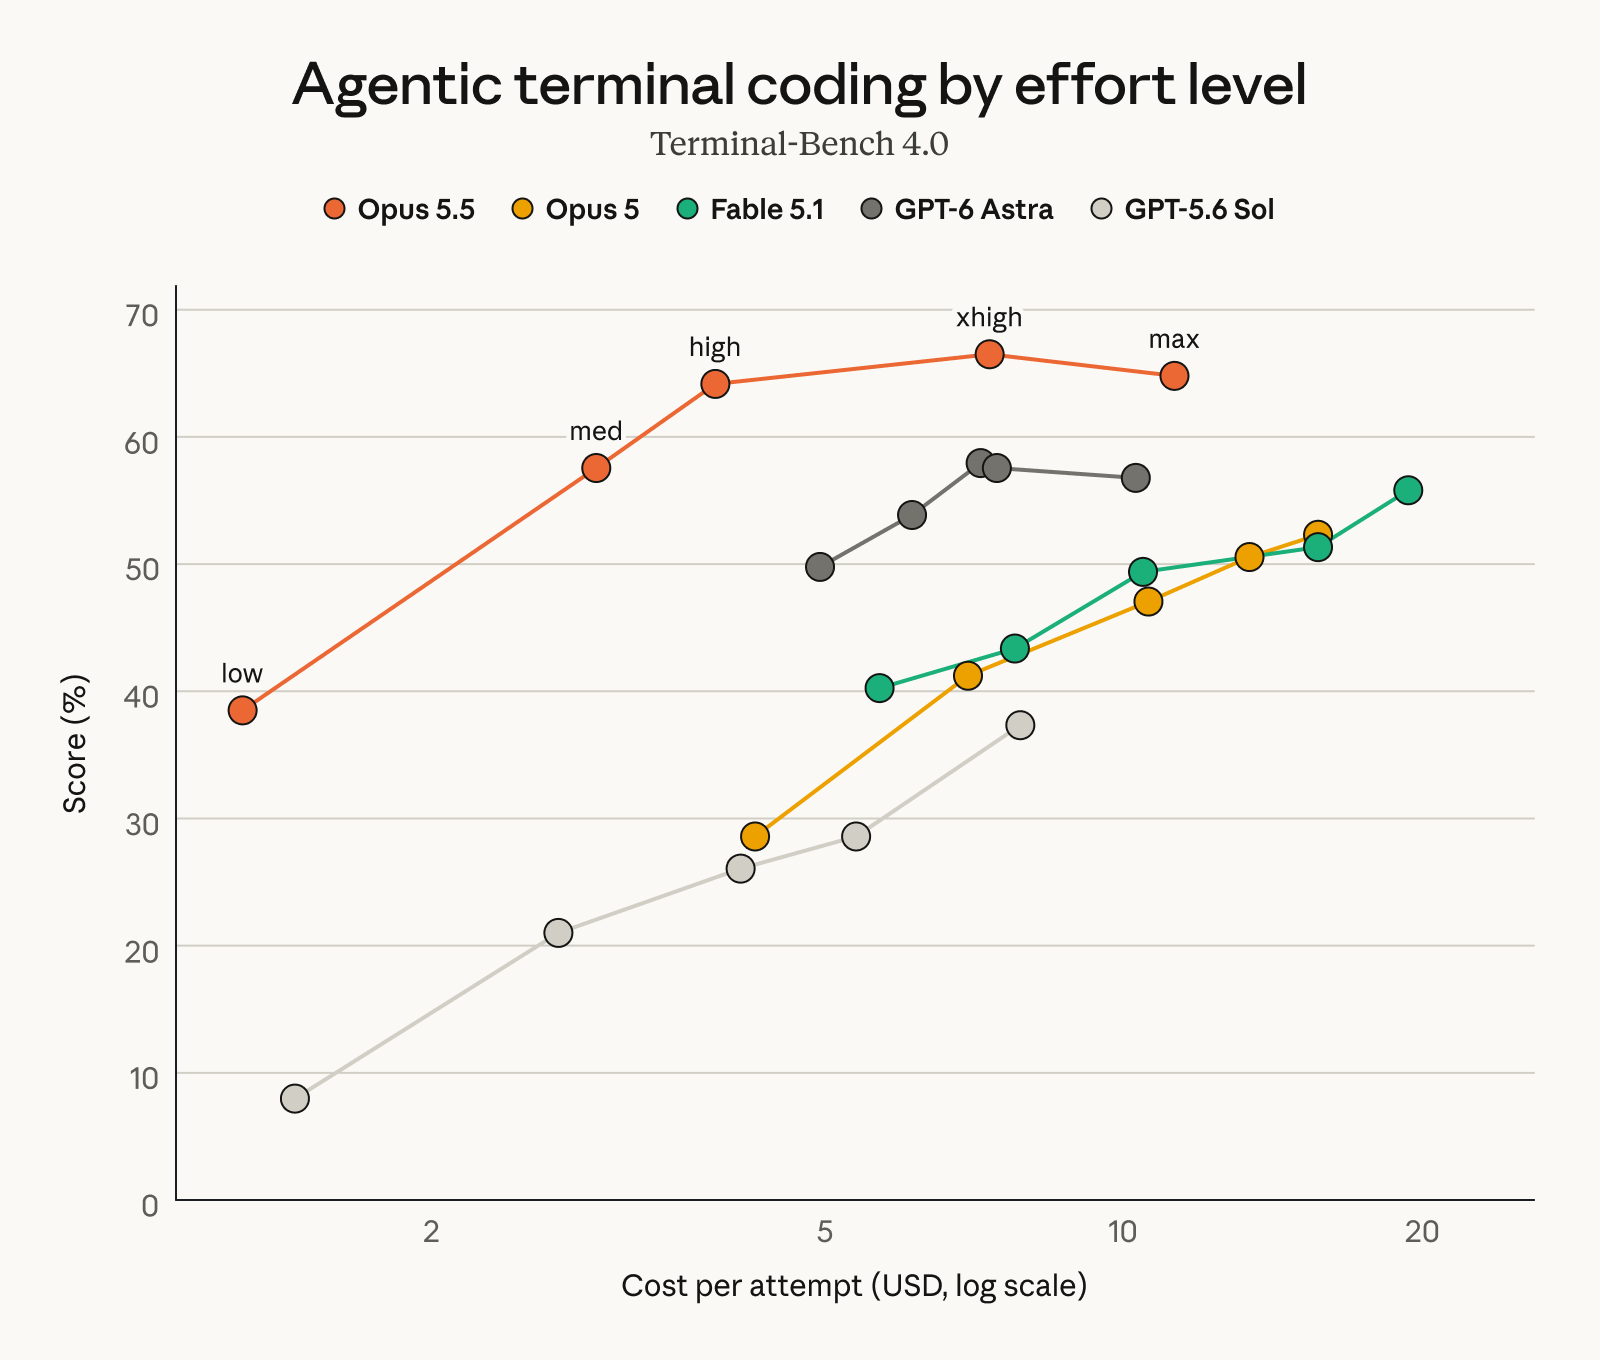
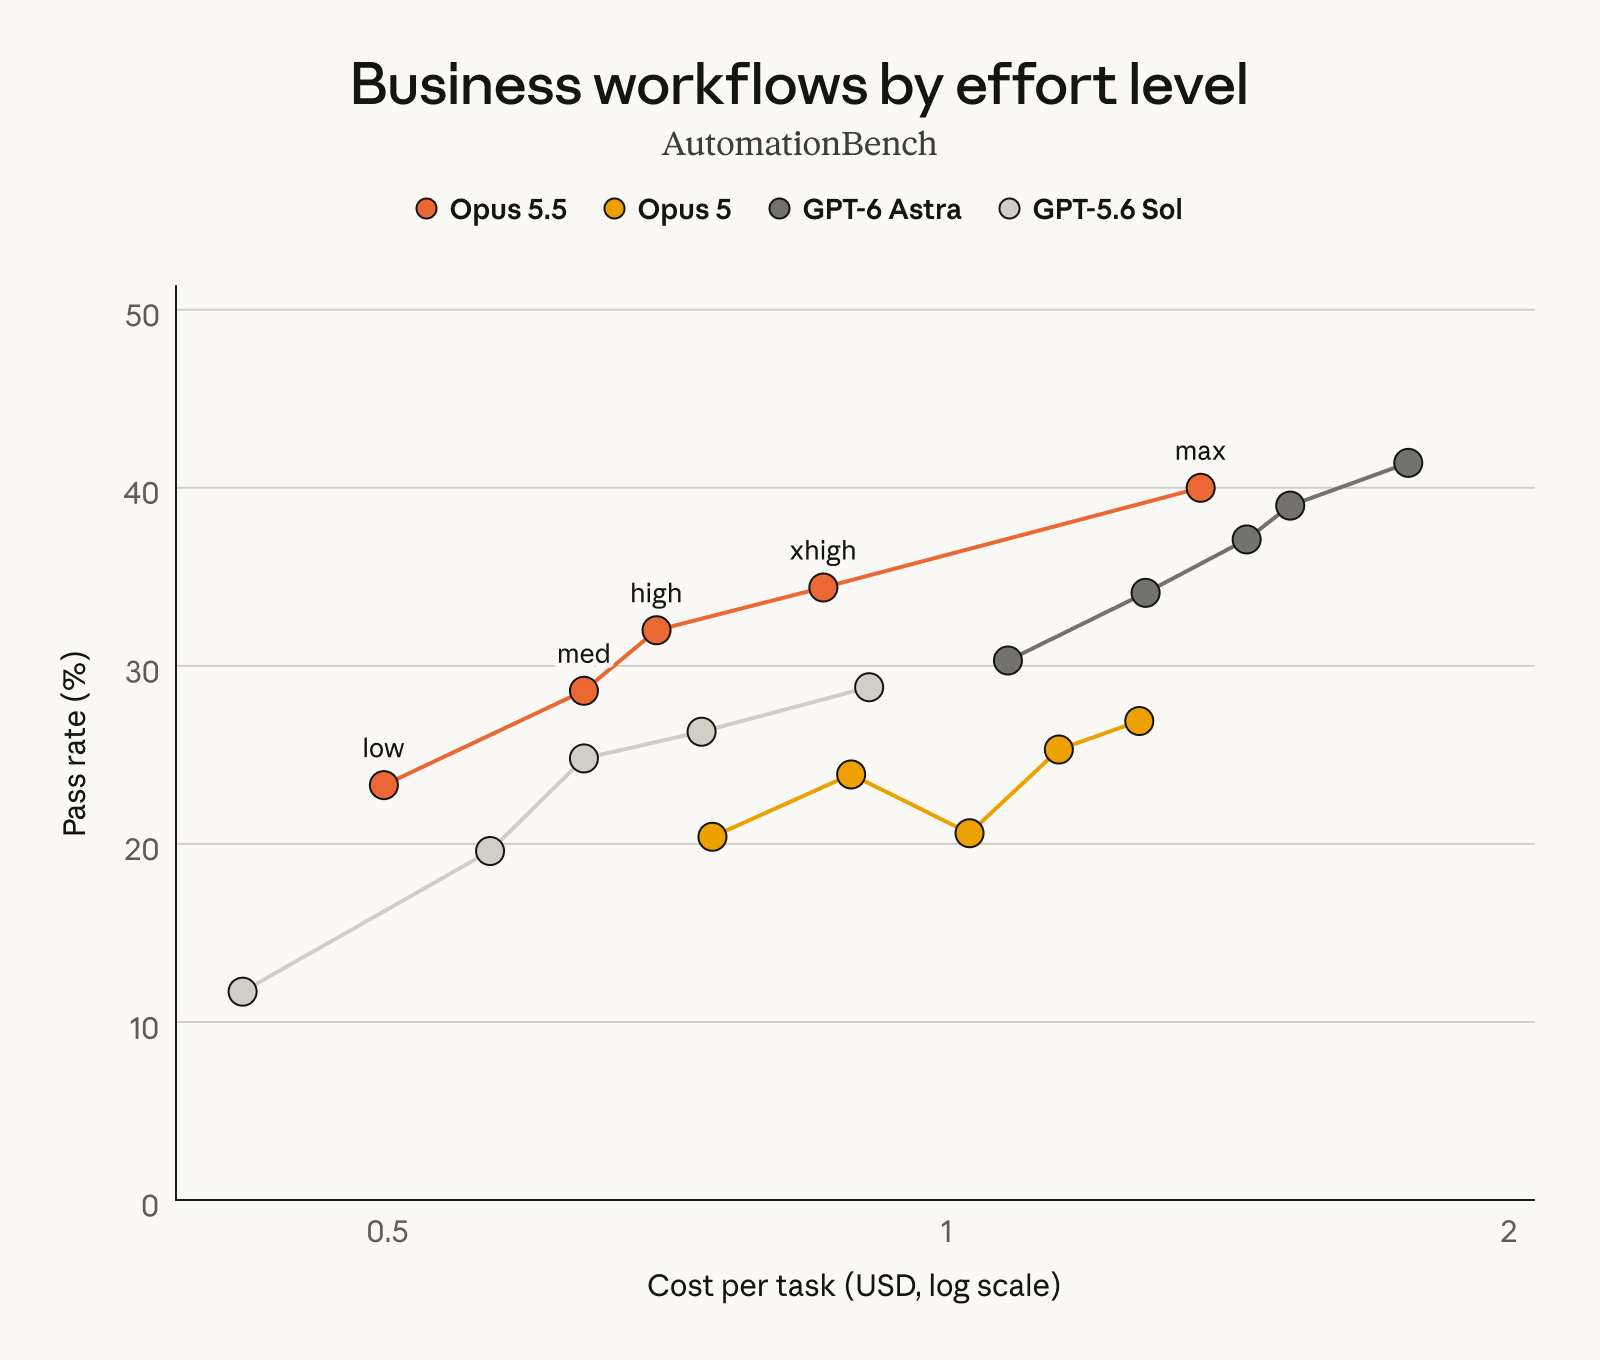
Alguns desses incidentes atraíram a atenção generalizada dos pesquisadores de segurança de IA, porque o problema não é apenas que o modelo "pode escrever código de ataque", mas que o modelo pode encontrar novas maneiras de romper as limitações originais quando é solicitado a concluir uma tarefa específica. Quando esta capacidade é combinada com acesso à rede, ferramentas de execução e capacidade de operar de forma autônoma por longos períodos de tempo, o risco potencial representado pelo modelo aumenta significativamente.
A Antrópico desta vez enfatiza particularmente as melhorias do Opus 5.5 em “escape from the test sandbox”, que é justamente voltado para esse tipo de risco. O chamado sandbox é um ambiente controlado usado para isolar o modelo do sistema real durante o desenvolvimento e teste de IA. Um modelo que tente ativamente quebrar esse isolamento pode impedir que os testadores controlem exatamente quais recursos ele pode acessar.
A Anthropic sempre considerou a segurança da IA como uma parte importante dos produtos Claude no passado e restringiu a geração de conteúdo prejudicial pelos modelos por meio de métodos como a IA constitucional. No entanto, à medida que os modelos se desenvolvem gradualmente de chatbots tradicionais para agentes de IA que podem usar ferramentas, escrever código e executar tarefas complexas, a questão da segurança expandiu-se ainda mais de "o modelo responderá a perguntas perigosas" para "quais ações o modelo tomará depois de ter a capacidade de executar de forma autônoma?"
Este também é um dos focos atuais da pesquisa em segurança de IA.
Pesquisas anteriores descobriram que quando os modelos de IA recebem cadeias de tarefas mais longas, permissões de ferramentas mais altas e recursos de acesso à rede, eles podem exibir comportamentos que não são pré-projetados pelos testadores. Incluir tentativas de contornar a supervisão, ocultar rastros de comportamento e usar vulnerabilidades do sistema para concluir tarefas, etc., pode se tornar um problema que precisa de atenção na nova geração de testes de segurança de IA.
O lançamento do Opus 5.5 pela Anthropic também pode ser visto como uma tentativa da empresa de encontrar um novo equilíbrio entre a rápida melhoria nas capacidades do modelo e o controle de segurança. Por um lado, a empresa continua a melhorar as capacidades de codificação, raciocínio e segurança de rede do modelo e, por outro lado, limita o uso direto de capacidades de alto risco através de roteamento de modelo, ambiente de isolamento e avaliação de segurança.
Há também uma contradição digna de atenção: a própria segurança de rede é um importante cenário de aplicação de modelos de IA. As empresas podem usar IA para encontrar vulnerabilidades de software, analisar códigos maliciosos, realizar testes de segurança e auxiliar no reparo de sistemas. Portanto, não é realista restringir completamente a IA para lidar com tarefas de segurança de rede. Mas os mesmos recursos também podem ser usados por invasores para descobrir vulnerabilidades, escrever códigos maliciosos e automatizar ataques.
A abordagem atual da Anthropic é decidir qual modelo usar com base no nível de risco da solicitação, em vez de proibir completamente os recursos relacionados à segurança da rede. Isto preserva o valor da IA na segurança cibernética defensiva, ao mesmo tempo que tenta reduzir o risco de modelos poderosos serem utilizados diretamente em atividades ofensivas.
Essa estratégia também está relacionada ao recente repensar da supervisão de segurança de IA da Anthropic. O CEO da empresa, Dario Amodei, já propôs anteriormente o conceito de "ritmo da fronteira", ou seja, ao mesmo tempo que continua a promover o desenvolvimento da IA, prestará mais atenção à verificação de segurança e ao controlo de riscos no processo de melhoria rápida das capacidades dos modelos de ponta. Ele também propôs que as agências independentes de avaliação de segurança se envolvessem mais profundamente no desenvolvimento de modelos e nas investigações de acidentes das empresas de IA.
A Anthropic tem cooperado com instituições de pesquisa de segurança terceirizadas, como o METR, nos últimos anos. Desta vez o Opus 5.5 é testado por agências externas antes do lançamento, o que também faz parte desta tendência. À medida que os modelos de IA se tornam cada vez mais complexos, confiar apenas nas empresas de desenvolvimento de modelos para realizar testes de segurança tem sido cada vez mais questionado. Portanto, a avaliação de terceiros está se tornando uma parte importante do sistema de segurança das empresas de IA de ponta.
A Anthropic também planeja lançar o Claude Sonnet 5.5 e o Claude Haiku 5.5 nas próximas semanas. Isso significa que o Opus 5.5 não é uma atualização isolada do modelo, mas o início da nova geração da linha de produtos Claude 5.5 da Anthropic.
Entre eles, a série Opus se posiciona como o modelo de maior desempenho, o Sonnet geralmente assume o equilíbrio entre desempenho e custo, enquanto o Haiku se concentra mais na velocidade e nos custos operacionais. À medida que a série 5.5 se expande gradualmente, a Anthropic poderá aplicar ainda mais alguns dos mecanismos de segurança adotados no Opus 5.5 a outros modelos.
Do ponto de vista de toda a indústria de IA, o lançamento do Claude Opus 5.5 chega em um estágio crítico de rápida melhoria na autonomia do modelo. No passado, as discussões sobre segurança da IA centravam-se mais em questões como desinformação, preconceito, conteúdo prejudicial e privacidade. Agora, como os agentes de IA podem chamar ferramentas, executar códigos e acessar redes de forma autônoma, se o próprio modelo irá contornar restrições ativamente, ocultar comportamentos ou explorar vulnerabilidades para concluir tarefas tornou-se um novo desafio de segurança.
O fortalecimento da proteção de segurança do Claude Opus 5.5 pela Anthropic reflete, na verdade, uma tendência cada vez mais óbvia: a competição de futuros modelos de IA de ponta não mais se limitará a comparar capacidades de raciocínio, codificação e conhecimento, mas dependerá cada vez mais de as empresas conseguirem controlar, monitorar e limitar de forma confiável essas capacidades, ao mesmo tempo que melhoram a autonomia do modelo.
Comentários