
Resumo:
O fundador do Linux, Linus Torvalds, está explorando ainda mais a aplicação de ferramentas de programação de inteligência artificial no desenvolvimento do kernel. Depois de desenvolver recentemente um patch de otimização de desempenho do kernel Linux com a ajuda de Claude Code da Anthropic, Torvalds usou um modelo de linguagem grande (LLM) para analisar um trecho de código do kernel que era difícil de entender há muito tempo. Ele não apenas confirmou uma falha relatada anteriormente pelo desenvolvedor, mas também descobriu outras três vulnerabilidades que estavam inativas há mais de dez anos. Todos esses problemas estão relacionados à implementação do Associative Array no kernel Linux.
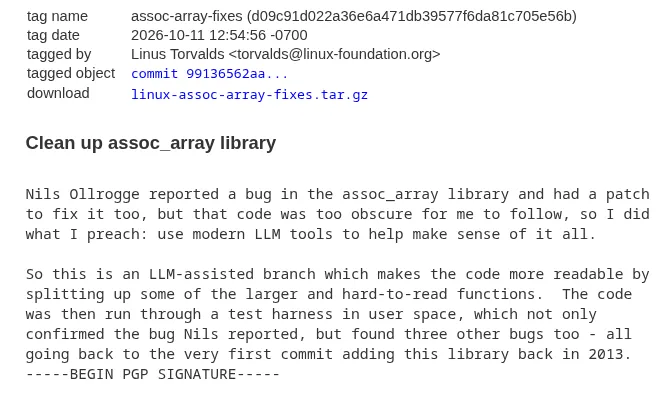
De acordo com um relatório divulgado pela Phoronix em 12 de outubro, Torvalds adicionou recentemente uma tag Git chamada "assoc-array-fixes" ao seu repositório de código do kernel Linux para organizar e marcar uma série de reparos no código do array associativo. Este trabalho é independente de seu projeto anterior de usar Claude Code para otimizar o desempenho de leitura de arquivos, mas ambos refletem suas tentativas de introduzir ferramentas de IA no complexo processo de desenvolvimento do kernel.
A causa deste trabalho foi que o desenvolvedor Nils Ollrogge relatou um bug na biblioteca de array associativo e enviou um patch de correção correspondente. No entanto, quando Torvalds revisou o patch, ele descobriu que a implementação do código relevante era muito obscura para entender diretamente sua lógica específica, por isso era impossível julgar facilmente se o patch resolveu o problema corretamente.
Diante desta situação, Torvalds optou por utilizar modelos modernos de linguagem em grande escala para auxiliar na análise. Ele escreveu na descrição da tag Git que desta vez ele adotou a abordagem que vinha defendendo antes, que é usar ferramentas modernas de LLM para ajudar a entender códigos complexos.
Torvalds então organizou um conjunto de patches com modificações assistidas por IA para dividir algumas funções grandes e difíceis de ler em uma estrutura mais clara, tornando a lógica do código mais fácil de entender e revisar. É importante notar que o objetivo deste trabalho não é simplesmente deixar a IA reescrever toda a implementação do array associativo, mas primeiro melhorar a legibilidade do código existente e depois verificar por meio de testes se seu comportamento é o esperado.
Depois de concluir a modificação, o código relevante também foi colocado na estrutura de teste do espaço do usuário para execução. Os testes não apenas confirmaram que o bug originalmente relatado pelo Olrog estava realmente presente, mas também descobriram três problemas adicionais.
Ainda mais preocupante é que essas falhas não são problemas novos introduzidos recentemente. De acordo com Torvalds, as três vulnerabilidades adicionais descobertas datam de 2013, quando a biblioteca de array associativo foi introduzida pela primeira vez no kernel do Linux. Em outras palavras, eles estão escondidos no código há mais de uma década, sem serem totalmente detectados por testes relevantes.
O array associativo no kernel do Linux é uma estrutura de dados usada para organizar e recuperar dados por valor-chave. Ao contrário dos arrays comuns que acessam elementos por meio de subscritos inteiros, os arrays associativos podem encontrar dados correspondentes com base em chaves específicas, portanto, são adequados para cenários que exigem indexação e gerenciamento flexíveis de objetos.
A implementação de array associativo no kernel Linux atende às necessidades de gerenciamento de dados dentro do kernel. Como o código do kernel deve ser executado sob rigorosos requisitos de desempenho, segurança de memória e acesso simultâneo, a implementação de tais componentes básicos costuma ser mais complexa do que código semelhante em aplicativos comuns. Mesmo que uma função execute ostensivamente apenas a inserção, exclusão ou pesquisa de dados, ela pode envolver ajuste da estrutura da árvore, gerenciamento do ciclo de vida do nó e várias condições de limite.
A falta de uma estrutura clara neste tipo de código torna mais difícil para os mantenedores entenderem seu comportamento. Os desenvolvedores não precisam apenas confirmar a lógica operacional em circunstâncias normais, mas também analisar entradas anormais, estados especiais da estrutura de dados e problemas que podem ocorrer quando múltiplas operações são executadas continuamente.
À medida que o código continua a evoluir, os defeitos que não são facilmente acionados nas implementações iniciais podem permanecer por muito tempo. Especialmente em estruturas de dados complexas, alguns erros só serão expostos em sequências de operação específicas ou estados estruturais especiais, e os testes comuns podem não cobrir necessariamente todas as situações.
A ideia adotada neste trabalho assistido por IA é primeiro dividir grandes funções que são difíceis de entender em partes mais fáceis de analisar e, em seguida, verificar a lógica relevante por meio de um programa de testes independente. Uma estrutura de código mais clara ajuda os desenvolvedores a identificar o relacionamento entre diferentes operações e também torna mais fácil para as ferramentas de teste criarem condições de verificação para comportamentos específicos.
No entanto, as três vulnerabilidades descobertas desta vez não podem ser simplesmente atribuídas à capacidade da IA de compreender programas além dos humanos. Mais precisamente, a refatoração de código assistida por IA, as revisões de desenvolvedores e as estruturas de teste funcionam juntas. Grandes modelos de linguagem podem ajudar a organizar a lógica do código e identificar possíveis problemas, mas, em última análise, ainda é necessário confirmar se os defeitos são reais por meio de execução real e testes repetíveis.
O que há de especial neste caso é que a IA não apenas participou da análise do código, mas também ajudou Torvalds a resolver barreiras de compreensão durante o processo de revisão do patch. Para desenvolvedores que mantêm grandes projetos de código aberto, este pode ser um método de trabalho de valor prático: quando o código é muito complexo e é difícil para os mantenedores avaliarem rapidamente se o plano de reparo está correto, a IA pode ser usada para ajudar na classificação da estrutura do código, e então as conclusões podem ser verificadas através de testes e revisão manual.
Atualmente, esse conjunto de correções para matrizes associativas ainda não foi incorporado à linha principal do kernel Linux. De acordo com os relatórios do Phoronix, espera-se que o trabalho relacionado avance ainda mais durante a próxima janela de mesclagem do Linux 7.4, mas se a mesclagem final ainda dependerá dos resultados de revisões e testes de código subsequentes.
É importante notar que esta não é a primeira vez que Torvalds demonstra publicamente recentemente o uso de IA no desenvolvimento do kernel Linux.
Anteriormente, ele usou Claude Code para realizar outro trabalho de otimização do kernel. O objetivo era resolver o problema de competição causado pela operação de contagem de referências de páginas de memória quando vários threads leem o mesmo arquivo ao mesmo tempo. O patch relevante tenta reduzir operações desnecessárias de contagem de referências ajustando o caminho de leitura do arquivo, melhorando assim o desempenho de leitura sob cargas de trabalho específicas.
Nesse trabalho, a IA participou da escrita inicial do código, do desenvolvimento do programa de teste, da revisão do código e da elaboração de documentos de notas de patch. Torvalds é responsável por determinar as direções de otimização, supervisionar o processo de desenvolvimento e realizar medições de desempenho em seu próprio computador.
Os objetivos técnicos das duas tarefas são diferentes, mas incorporam um modelo de desenvolvimento semelhante: engenheiros familiarizados com o kernel determinam o problema, depois usam IA para ajudar a entender implementações complexas, escrever ou ajustar código e, finalmente, verificar os resultados por meio de testes.
Este modelo pode ser particularmente valioso para projetos de código aberto com ciclos de manutenção longos e de grande escala, como o Linux. O código do kernel continuou a evoluir ao longo de décadas e contém um extenso histórico de implementação e requisitos de compatibilidade complexos. Mesmo os mantenedores experientes nem sempre podem estar familiarizados com todos os detalhes de cada subsistema.
A revisão de código tradicional depende principalmente dos desenvolvedores para ler o código, analisar a lógica e projetar testes. As ferramentas de IA têm a oportunidade de ajudar os mantenedores a classificar códigos desconhecidos com mais rapidez, explicar a relação entre funções, propor possíveis condições de limite e auxiliar na geração de casos de teste. Eles não substituem a revisão profissional, mas espera-se que reduzam o tempo gasto na compreensão de códigos complexos.
Ao mesmo tempo, o código gerado por IA também tem limitações. Grandes modelos de linguagem podem interpretar mal fluxos de controle complexos, ignorar condições de contorno raras ou propor modificações que parecem razoáveis, mas na verdade não garantem a correção. Para kernels de sistemas operacionais, esses problemas são particularmente importantes porque erros de código podem afetar a estabilidade do sistema, a segurança da memória e até mesmo a operação confiável de todo o sistema.
Portanto, a participação da IA no desenvolvimento do kernel não significa que os requisitos de revisão possam ser relaxados. Em vez disso, a refatoração de código, os testes automatizados, a revisão de patches e a verificação real continuam sendo essenciais para garantir a qualidade das modificações. O projeto de matriz associativa foi capaz de descobrir problemas de longa data, o que apenas mostra que as ferramentas de IA precisam ser combinadas com processos rigorosos de verificação de engenharia para serem eficazes.
Torvalds sempre teve uma atitude pragmática em relação às ferramentas de programação de IA. Ele reconheceu o valor da IA para ajudar no processo de desenvolvimento, mas não defendeu que os desenvolvedores aceitassem código gerado por máquina sem revisão. Desta vez, ele declarou publicamente que usa o LLM para analisar o código, o que mostrou ainda que a IA está se tornando uma opção auxiliar na caixa de ferramentas de desenvolvimento do kernel.
De forma mais ampla, o incidente também esclarece uma dificuldade de longa data na manutenção de grandes projetos de software: o código não só precisa ser executado corretamente, mas também deve ser compreensível para futuros desenvolvedores. Para software básico que foi mantido por mais de dez anos ou mesmo décadas, a legibilidade em si é um fator importante que afeta a confiabilidade.
Essa modificação melhora a estrutura do código ao dividir funções complexas e usa testes para descobrir problemas anteriormente perdidos, demonstrando a estreita conexão entre a legibilidade do código e a solução de problemas de defeitos. Quando a lógica do programa é mais clara, é mais fácil para os desenvolvedores identificar possíveis caminhos de erro e criar testes que cubram comportamentos relevantes.
Se esse conjunto de patches eventualmente entrar na linha principal do Linux, seu significado não apenas corrigirá os quatro problemas identificados, mas também fornecerá uma base de código mais clara para manutenção subsequente.
À medida que as ferramentas de programação de IA continuam a se desenvolver, poderá haver mais casos semelhantes em grandes projetos de código aberto no futuro. No entanto, para softwares básicos importantes, como o kernel Linux, o que realmente determina se o desenvolvimento assistido por IA pode obter reconhecimento a longo prazo é se o patch pode passar por uma revisão rigorosa, se o teste pode reproduzir o problema e se o código final é confiável o suficiente.
Desta vez, a IA não substituiu o fundador do Linux na tomada de decisão final, mas o ajudou a entender o código que era originalmente difícil de revisar e a descobrir ainda mais defeitos que estavam ocultos por muitos anos. Para a engenharia de software madura, esta pode ser uma das áreas de aplicação mais práticas da inteligência artificial.
Comentários