
Resumo:
O fundador do kernel Linux, Linus Torvalds, está desenvolvendo uma solução de otimização de desempenho do kernel Linux com a ajuda da ferramenta de programação de inteligência artificial Claude Code.
Este trabalho visa um gargalo de desempenho no mecanismo de gerenciamento de memória do kernel Linux. O objetivo é reduzir a competição causada pela contagem de referências de páginas de memória quando vários threads leem o mesmo arquivo ao mesmo tempo, melhorando assim a eficiência da leitura de arquivos.
Torvalds não apenas usou IA para ajudar a escrever código, mas também usou essa ferramenta para escrever programas de teste, conduzir revisões de código e redigir notas de patch relevantes.
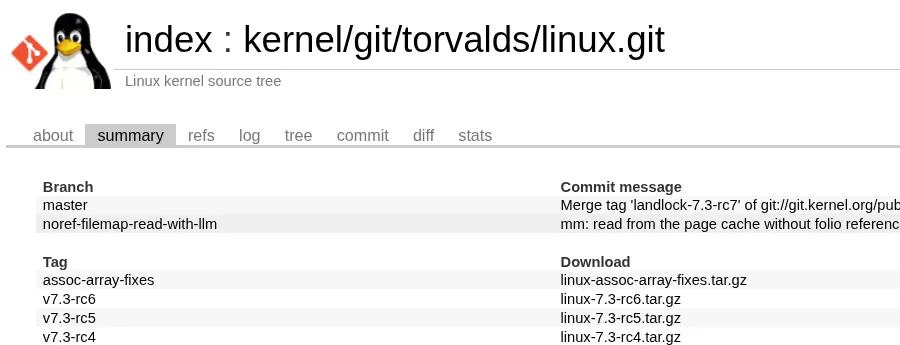
Enquanto aguardava o lançamento do Linux 7.3-rc7, Torvalds atualizou recentemente seu repositório de código Git do kernel Linux e descobriu que um novo branch incomum havia aparecido no repositório. Ao contrário de sua prática usual de manter o branch principal, este branch chamado "noref-filemap-read-with-llm" é dedicado ao desenvolvimento de uma série de patches de melhoria do kernel. Como pode ser visto no LLM no nome do ramo, este trabalho está relacionado à programação assistida por modelo em linguagem de grande porte.
Torvalds mais tarde deixou claro nas notas relevantes do patch que este trabalho foi concluído sob sua orientação e com a ajuda de Claude Code. A IA não apenas participou da implementação do código, mas também auxiliou na escrita de programas de teste, na condução de revisões de código e na elaboração da versão inicial da documentação da série de patches. As medições de desempenho relevantes foram feitas no próprio computador de Torvalds.
Essa otimização visa principalmente um problema específico no caminho de leitura do arquivo do kernel do Linux. Quando vários threads leem pequenos pedaços de dados do mesmo arquivo ao mesmo tempo, eles podem competir em torno da contagem de referência de páginas de memória no cache de páginas do arquivo, fazendo com que os threads concorram entre si por estruturas de dados relacionadas, limitando assim o desempenho de leitura.
Para entender esse problema, você precisa primeiro entender como o kernel do Linux lida com a leitura de arquivos.
O Linux usará o cache de páginas (Page Cache) para salvar os dados do arquivo lidos no dispositivo de armazenamento. Quando um programa acessa novamente o conteúdo de um arquivo que foi armazenado em cache na memória, o kernel muitas vezes pode fornecer os dados diretamente da memória sem ter que revisitar o disco ou outro dispositivo de armazenamento todas as vezes. O cache de páginas é, portanto, um mecanismo importante para o Linux melhorar a eficiência do acesso a arquivos.
Para gerenciar esses dados armazenados em cache, o kernel precisa rastrear o ciclo de vida dos objetos de memória relacionados. O mecanismo de contagem de referências em implementações tradicionais pode ajudar o kernel a determinar se um objeto de memória ainda está em uso e quando pode liberar recursos relacionados com segurança.
No entanto, quando um grande número de threads acessa frequentemente o mesmo arquivo, mesmo que os dados lidos já estejam na memória, as operações de contagem de referência relacionadas ainda podem incorrer em sobrecarga adicional de sincronização. Em um sistema de processador multinúcleo, se vários threads atualizarem continuamente o mesmo valor de contagem compartilhada, poderão ocorrer problemas como aumento do tráfego de coerência de cache e núcleos de processador aguardando uns pelos outros.
Para cenários de thread único ou de baixa simultaneidade, essa sobrecarga pode não ser perceptível. Mas em servidores, bancos de dados, sistemas de construção e outras cargas de trabalho altamente simultâneos que precisam lidar com um grande número de solicitações de leitura de arquivos simultaneamente, as operações recorrentes de sincronização podem gradualmente se tornar um gargalo de desempenho.
A série de patches que Torvalds está desenvolvendo foi projetada para reduzir operações desnecessárias de contagem de referências. A ideia central é ajustar o caminho de leitura do arquivo para que o kernel possa ler dados diretamente do cache da página sob certas condições, sem ter que realizar operações tradicionais de gerenciamento de referência de fólio para cada acesso relevante.
folio aqui é uma das abstrações básicas usadas pelo kernel Linux para gerenciar um conjunto de páginas de memória contíguas ou associadas. Nos últimos anos, o kernel Linux tem usado gradualmente o mecanismo de fólio para substituir alguns dos antigos métodos de gerenciamento de página única, a fim de lidar com tarefas de gerenciamento de memória com mais eficiência. Como reduzir a sobrecarga causada pela contagem de referências de fólio tornou-se, portanto, uma tarefa importante na otimização do desempenho do kernel.
Do ponto de vista técnico, esse tipo de otimização não remove simplesmente a contagem de referências. O kernel ainda deve garantir que os objetos de memória não sejam liberados prematuramente enquanto estão sendo acessados e não deve introduzir corrupção de dados ou problemas de segurança de memória, reduzindo as operações de sincronização. Portanto, os patches precisam encontrar um equilíbrio entre correção, segurança de acesso simultâneo e desempenho.
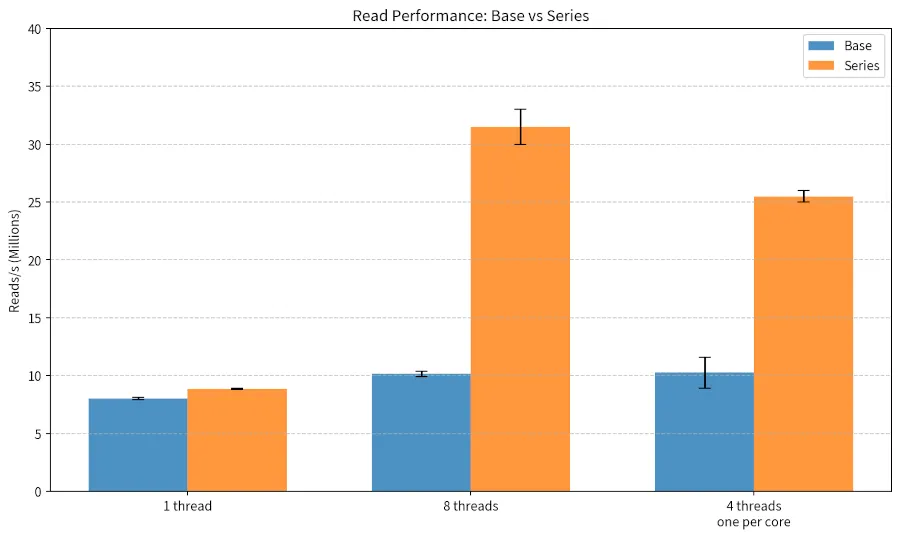
Essa otimização resultou em mudanças de desempenho bastante significativas na carga de trabalho desejada. O teste visa principalmente o cenário em que vários threads leem pequenos dados do mesmo arquivo ao mesmo tempo, o que corresponde ao problema de competição que o patch está tentando resolver.
No entanto, esses resultados devem ser entendidos como desempenho sob condições de teste específicas, e não que todas as operações de arquivo no Linux receberão a mesma melhoria. Os benefícios reais dependem dos padrões de acesso do seu aplicativo, do número de threads, do tamanho do arquivo, do dispositivo de armazenamento, da configuração da memória e de outros fatores do sistema. Os efeitos da otimização podem ser limitados para cargas de trabalho que não envolvem os mesmos problemas de contenção.
Atualmente, esses patches ainda estão armazenados na ramificação pessoal do Git de Torvalds e não se pode concluir que eles tenham entrado oficialmente no kernel principal do Linux. Se será fundido no futuro e que método de implementação será adoptado no final requer uma observação mais aprofundada.
De acordo com o ritmo de desenvolvimento atual, esta série de patches pode entrar na fase de discussão ou revisão durante a próxima janela de mesclagem do Linux 7.4, mas se ela pode ser mesclada ainda depende da revisão do código, dos resultados dos testes e do julgamento do mantenedor.
Vale a pena notar que o uso de Claude Code por Torvalds não é sua primeira tentativa de usar inteligência artificial para lidar com o trabalho de desenvolvimento relacionado ao Linux.
Anteriormente, ele falou sobre o uso de depuração de kernel assistida por IA e experimentou ferramentas de programação de IA, como o Google Antigravity, fora do kernel do Linux. Para Torvalds, a IA não se trata de substituir os desenvolvedores como tomadores de decisão independentes, mas sim de uma ferramenta de desenvolvimento que pode ser usada com objetivos claros e supervisão humana.
Desde este ano, as ferramentas de programação de inteligência artificial estão gradualmente entrando no processo de desenvolvimento de software de código aberto. Cada vez mais desenvolvedores estão aproveitando grandes modelos de linguagem para analisar código, localizar bugs, escrever testes e gerar patches iniciais. A comunidade do kernel Linux também está vendo um número crescente de códigos assistidos por IA e relatórios de bugs.
Essa tendência traz oportunidades e desafios. Por um lado, a IA pode ajudar desenvolvedores experientes a explorar caminhos de código complexos com mais rapidez, apresentar ideias de otimização e reduzir o tempo necessário para escrever código repetitivo. Por outro lado, um grande número de patches e relatórios de bugs gerados automaticamente também aumenta a carga de revisão dos mantenedores, e alguns dos envios podem ter problemas de baixa qualidade, envios duplicados ou falta de valor real.
Torvalds já declarou publicamente que acredita que a IA é uma ferramenta útil, mas a comunidade do kernel precisa lidar com a pressão de trabalho causada pelo rápido aumento no conteúdo gerado pela IA. Ele não defende a rejeição do código apenas porque usa IA, mas presta mais atenção à qualidade, correção e efeito real do código final.
O projeto de otimização do kernel do qual Claude Code participou desta vez reflete um método de aplicação mais específico de desenvolvimento assistido por IA: desenvolvedores familiarizados com os mecanismos internos do kernel identificam problemas, propõem direções de otimização e supervisionam a implementação, e então verificam os resultados por meio de testes e revisão de código.
Ao contrário de depender apenas da IA para gerar automaticamente todo o projeto de software, o desenvolvimento do kernel Linux envolve mecanismos complexos de simultaneidade, requisitos de segurança de memória e comportamento de hardware. Qualquer modificação aparentemente simples pode afetar um grande número de aplicações e diferentes plataformas de hardware. Portanto, mesmo que a IA possa ajudar a gerar código, os desenvolvedores ainda precisam entender como ele funciona e assumir a responsabilidade pela implementação final.
Se esse conjunto de patches finalmente passar na revisão e entrar na linha principal do Linux, ele se tornará mais um caso de desenvolvimento assistido por IA participando da otimização do software do sistema subjacente. Seu valor reside não apenas nas melhorias de desempenho que podem ser obtidas em cenários específicos, mas também na demonstração de como grandes modelos de linguagem podem auxiliar engenheiros experientes na análise e melhoria de sistemas complexos.
À medida que as ferramentas de programação de IA continuam a se desenvolver, mais trabalhos semelhantes poderão aparecer no kernel do Linux e em outros grandes projetos de código aberto no futuro. No entanto, o que determina se estas conquistas podem realmente ser implementadas ainda será a verificação técnica rigorosa, a revisão da comunidade e os requisitos de longo prazo para a estabilidade do sistema.
Comentários