Resumo:
Março de 2016, Four Seasons Hotel Seul. No meio do segundo jogo da batalha homem-máquina, AlphaGo deixou cair uma mancha solar na quinta linha. Os comentários no local ficaram sem palavras e algumas pessoas suspeitaram que havia um bug no programa, pois segundo o bom senso dos enxadristas profissionais, esse lance foi quase um lance livre.
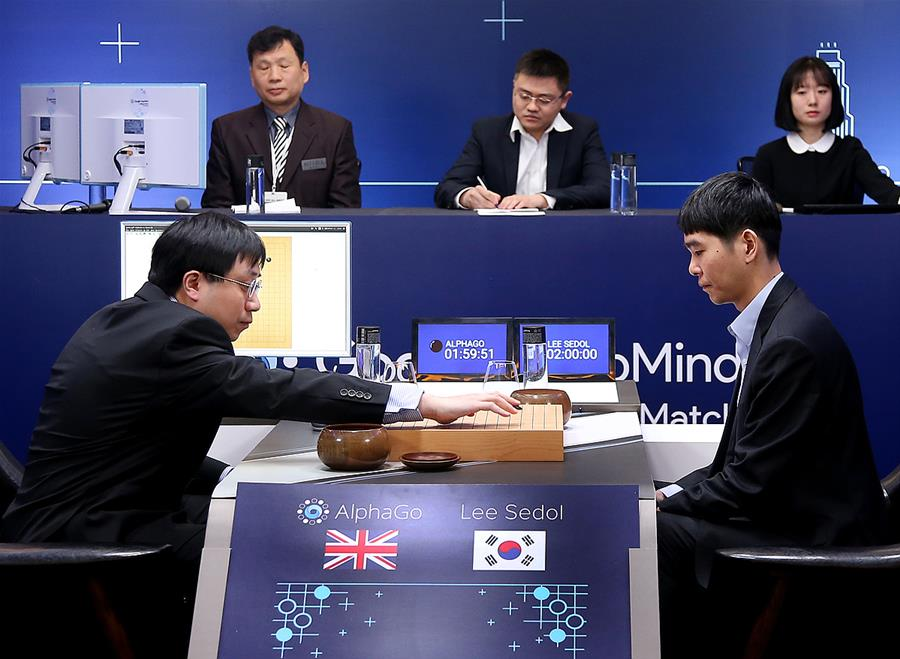
Todo mundo conhece a história subsequente. AlphaGo não só venceu esse jogo, mas também derrotou Lee Sedol com uma pontuação total de 4:1. Após o jogo, Lee Sedol disse algo que é frequentemente citado: "Originalmente, pensei que o AlphaGo fosse apenas uma máquina baseada no cálculo de probabilidades. Mas depois de ver aquela mão, mudei de ideia. O AlphaGo deve ser criativo."
Esse é o famoso lance 37.
Dez anos depois, o homem que construiu o AlphaGo levantou-se e disse: a IA de hoje não tem as capacidades das quais esse jogo de xadrez depende.
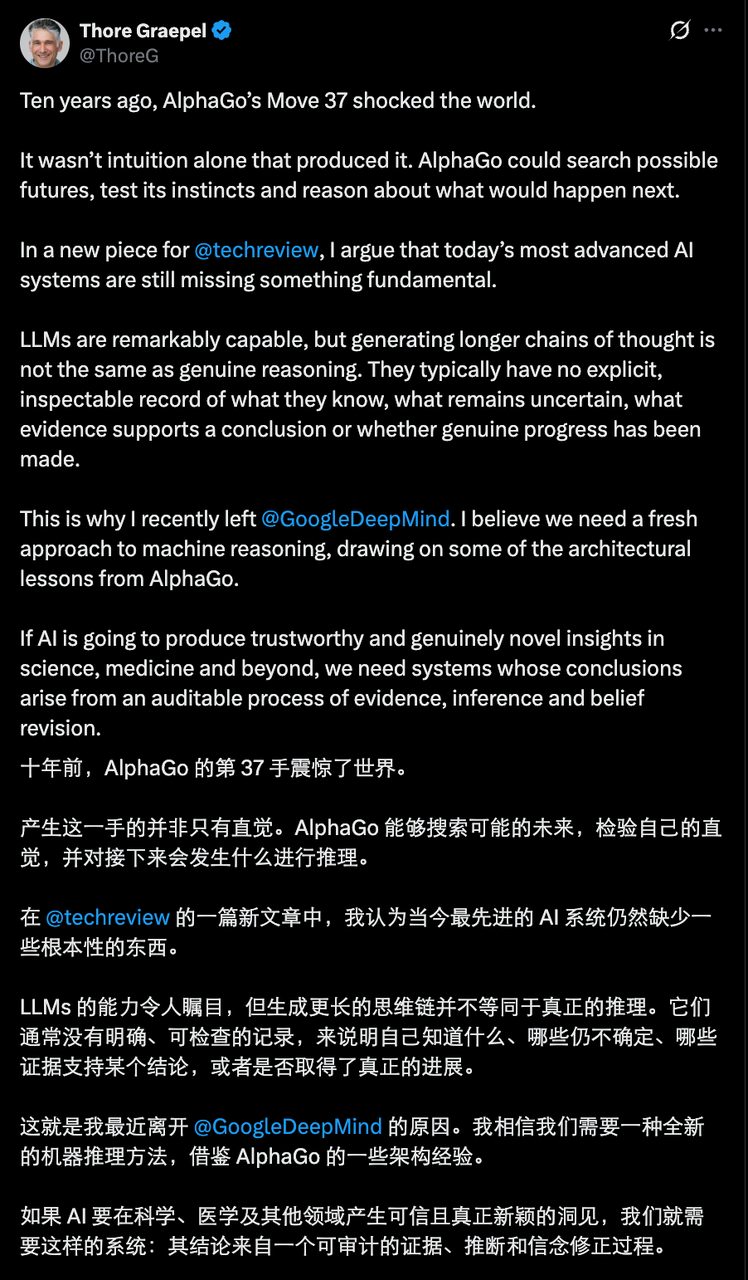
A pessoa que disse isso é Thore Graepel, um dos principais autores do AlphaGo e está envolvido em pesquisas de aprendizado de máquina há muito tempo. Recentemente, ele tomou uma decisão intrigante: deixar o Google DeepMind para iniciar um negócio e fazer algo que considera mais importante: equipar as máquinas com capacidades reais de raciocínio.
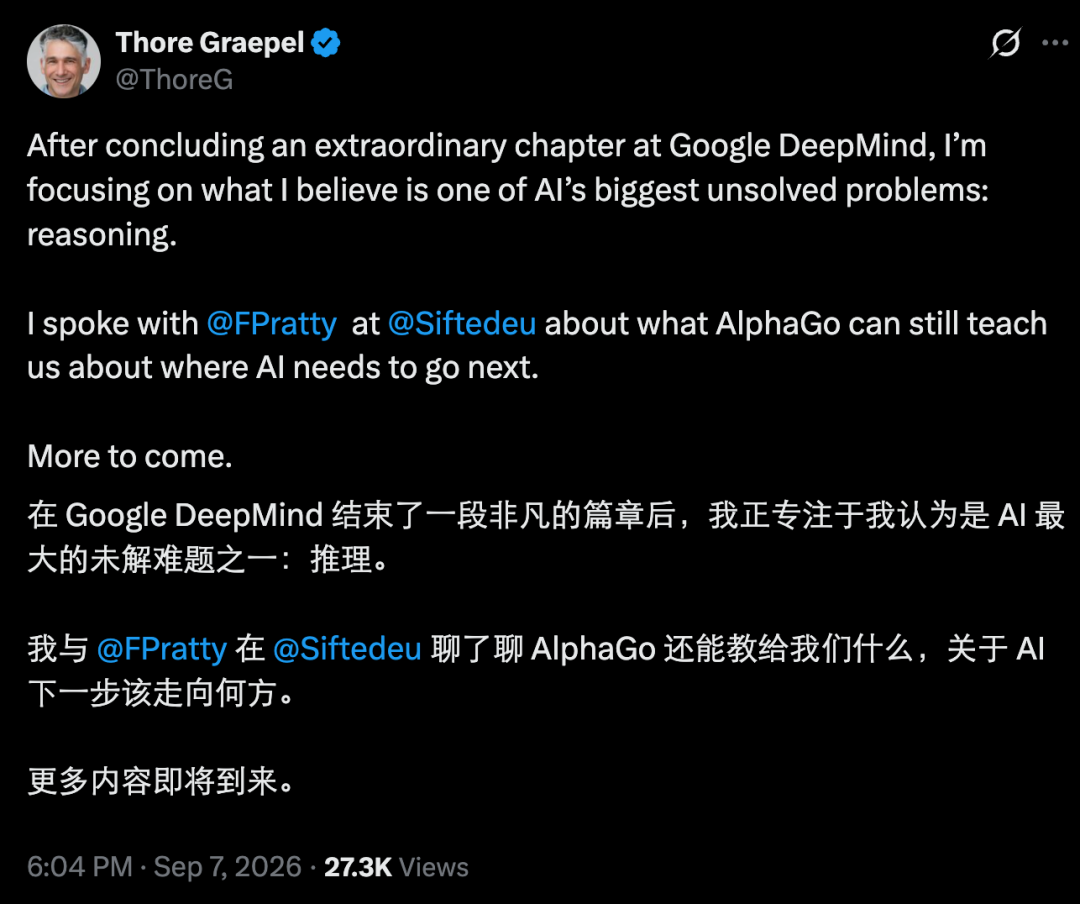
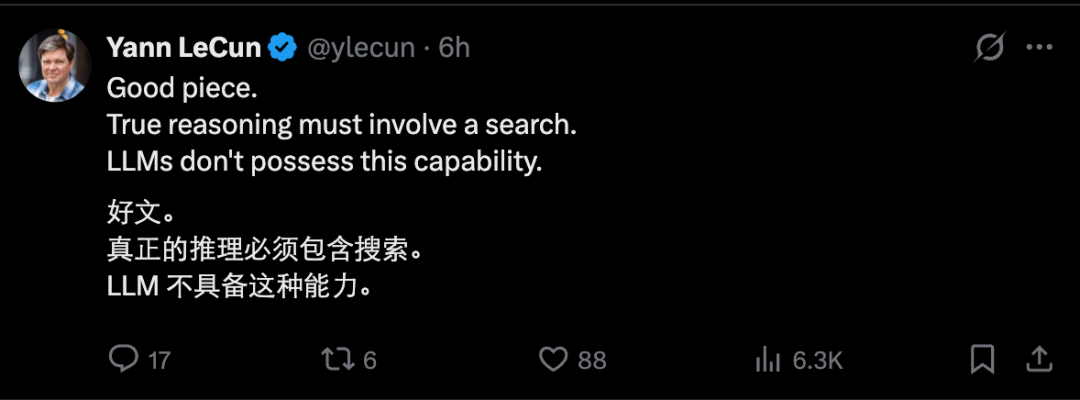
Esse ponto comovente vem de um artigo que ele publicou recentemente na MIT Technology Review. O título do artigo é muito direto, chamado "Não se deixe enganar - os LLMs não conseguem raciocinar". Depois de ler este artigo, o vencedor do Prêmio Turing, Yann LeCun, expressou seu agradecimento, enfatizando que "o raciocínio real deve envolver pesquisa, e o LLM não tem essa capacidade".
Por que Thore Graepel disse isso? Vamos dar uma olhada no que está escrito neste artigo.
O movimento 37 não foi um “lampejo de inspiração”,
É o produto do raciocínio
Muitas pessoas descrevem o 37º movimento como um "momento mítico de intuição da máquina" - num relâmpago, a IA viu um movimento magistral além da história de mil anos do xadrez humano. Graepel disse que este é o maior mal-entendido sobre o AlphaGo.
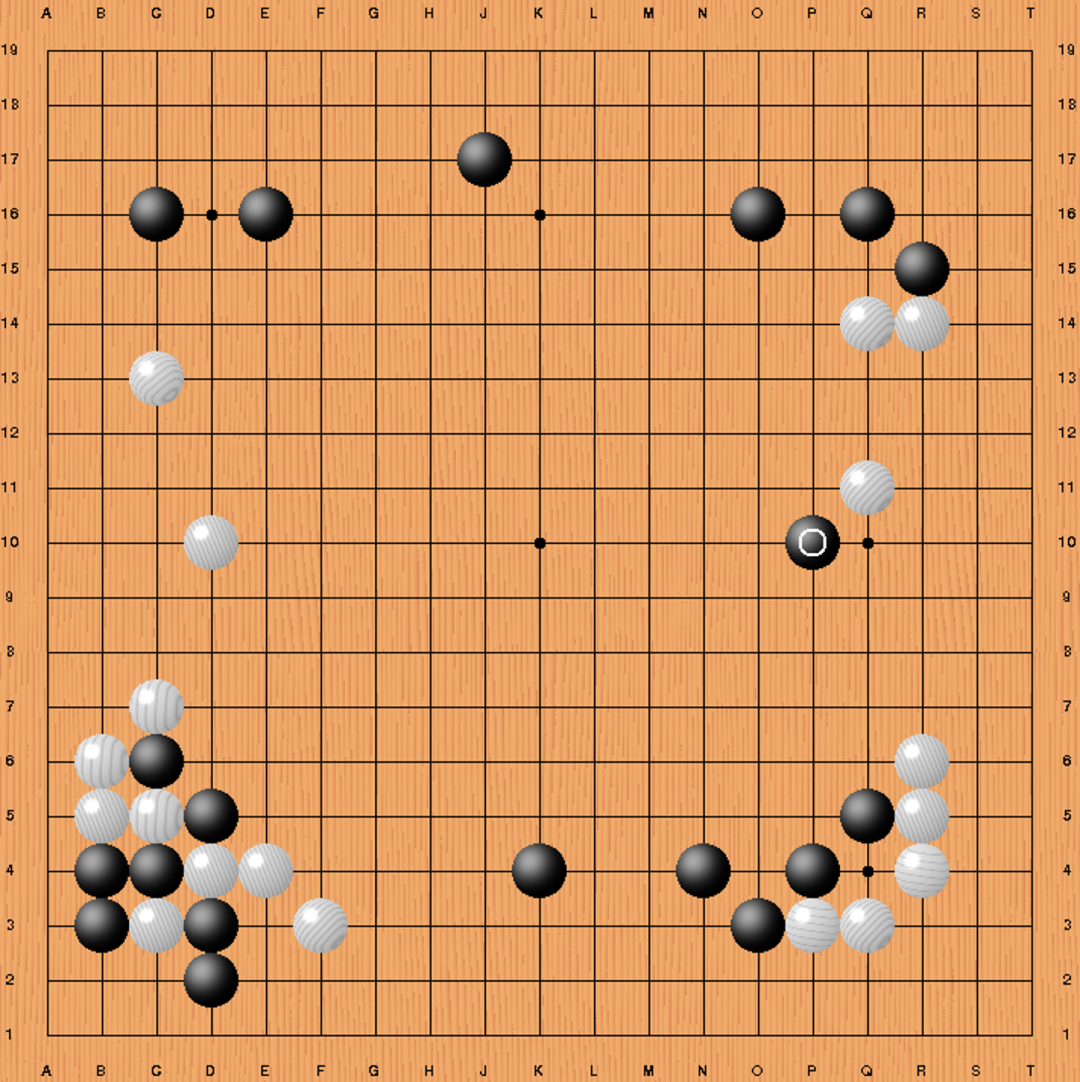
Para entender isso, devemos primeiro desmontar a estrutura interna do AlphaGo. Consiste em dois sistemas: um é uma rede política, que aprende a partir de enormes registros humanos de xadrez para prever “como o mestre jogará nesta situação”. Esta é a parte intuitiva. O outro é um mecanismo de busca, que não se importa se um determinado movimento de xadrez "parece ter sido jogado por um humano", mas constrói explicitamente uma árvore de jogo contendo milhares de ramos para deduzir o futuro a que cada posição candidata leva.
O ponto principal é: aos olhos da rede de estratégia, o lance 37 não é notável - a probabilidade de um jogador de xadrez humano profissional jogar esse lance é de apenas cerca de 1 em 10.000. Se você apenas ouvir a sua intuição, esta mão não será escolhida de forma alguma. Foi o mecanismo de busca que descobriu, após cálculos cuidadosos, que esse movimento “inacreditável” levou a um final melhor.
Graepel toma emprestada a famosa estrutura de Kahneman para explicar isso. O pensamento humano está dividido em dois modos: o Sistema 1 é rápido, intuitivo e fácil; O Sistema 2 é lento, passo a passo e cuidadosamente ponderado. AlphaGo é uma rara combinação desses dois modos na máquina: a rede neural fornece a intuição de “este movimento tem uma chance” e “esta situação é para ser vencida”, e o mecanismo de busca é responsável por testar essas intuições em futuras mudanças ofensivas e defensivas. Não funcionará sem metade: a intuição por si só nunca fará o 37º movimento; a busca violenta por si só não será capaz de eliminar as possibilidades astronômicas do Go.
Há aqui outra comparação que muitas vezes é esquecida. O Deep Blue derrotou Kasparov em 1997, baseando-se em regras codificadas por humanos para avaliar 200 milhões de posições de xadrez por segundo e olhar seis a oito passos à frente. A complexidade do Go está totalmente em outro nível. O valor de uma peça depende do crescimento e declínio do impulso e do campo após dezenas de rodadas. Mesmo que apenas uma pequena parte de todas as alterações fosse calculada, um supercomputador teria de calculá-la ao longo de milhares de milhões de anos. Portanto, AlphaGo deve aprender a “ver a situação claramente de relance” e até mesmo criar movimentos que os humanos nunca imaginaram. Não se ganha esmagando o poder da computação, o que é crucial.
Modelo de linguagem grande:
Um sistema treinado ao extremo 1
Vejamos a IA atual.
O princípio de funcionamento dos grandes modelos de linguagem é prever o próximo token repetidamente. Este é essencialmente o Sistema 1 em ação: rápido, associativo e capaz de completar padrões impressionantes em quase todos os campos sobre os quais os humanos já escreveram, mas sem a parte "pense antes de responder".
Não muito depois do nascimento do ChatGPT, a indústria percebeu que a fluência no idioma por si só não poderia sustentar a utilidade real. Todos estão familiarizados com o plano de solução: deixe o modelo não se apressar em responder, primeiro gere etapas intermediárias, desmembre o problema e traga os resultados intermediários - isto é, a cadeia de pensamento.
A melhoria da cadeia de pensamento é real, especialmente em matemática e codificação. Mas Graepel apontou um fato que é facilmente obscurecido pela excitação: essas etapas intermediárias de raciocínio ainda são o mesmo processo de “prever o próximo token”, apenas itera um pouco mais antes de dar a resposta final. Não introduz um mecanismo de raciocínio verdadeiramente independente como a pesquisa do AlphaGo. A intuição é ampliada, mas não se transforma em prudência.
Ele listou ainda três deficiências para explicar por que o que o chatbot faz fica aquém do “tipo de raciocínio reconhecido pelos cientistas”.
Primeiro, o modelo não possui um estado cognitivo claro, continuamente atualizado e inspecionável. Que hipóteses está a considerar neste momento, quanta confiança deposita nas diversas explicações, que provas está a ponderar e que questões permanecem sem resposta. Estas coisas deveriam ser sistematicamente revistas à medida que novas informações chegam, mas não existe tal “registo aberto” dentro do modelo.
Em segundo lugar, o modelo não consegue a separação entre “o que saber” e “como usar o conhecimento”. O conhecimento e o raciocínio estão fortemente emaranhados nos pesos da rede neural, e não existe um sistema de crenças independente e explicitamente expresso.
Terceiro e mais sutil: as cadeias de pensamento parecem uma deliberação cuidadosa, mas pesquisas mostram que os modelos muitas vezes as constituem após o fato. A resposta é obtida caminhando para um lado, mas o que lhe é relatado é outro caminho. Uma “história que parece razoável” e um “raciocínio que realmente aconteceu” são duas coisas diferentes.
Quer o raciocínio seja verdadeiro ou falso,
É tão importante?
Se você está apenas conversando e conversando, pode não importar se o raciocínio é verdadeiro ou falso. Mas nos campos de alto risco com os quais realmente nos importamos – medicina, engenharia, investigação científica – o que um sistema alcança é tão importante como a forma como o alcança. Quando algo corre mal, como um erro no diagnóstico ou no tratamento, precisamos de ser capazes de identificar onde reside o erro: existe um problema com o processo de raciocínio, está a aceitar provas inválidas ou a fazer uma suposição errada? Um sistema que só pode inventar histórias após o fato não pode ser confiável ou responsabilizado em tais cenários.
É exatamente por isso que Graepel deixou a DeepMind. Ele acredita que precisamos de um novo caminho de raciocínio mecânico, e a inspiração vem do AlphaGo há dez anos.
AlphaGo mantém um registro de todo o seu conhecimento da situação atual a qualquer momento, que é a árvore do jogo. A árvore contém todas as mudanças que considerou, todos os futuros possíveis, e cada movimento e cada situação são marcados com o julgamento da rede neural. À medida que a dedução avança, ela atualiza continuamente a árvore e, finalmente, determina o movimento com base nas informações da árvore.
Graepel acredita que o mesmo se aplica aos sistemas de raciocínio geral: manter um estado cognitivo que expressa claramente o que está confirmado, o que está em dúvida, o que foi descartado e quais questões permanecem em aberto. E o “raciocínio” é uma série de “ações” que mudam esse estado cognitivo – tirando conclusões, desmontando problemas e, o mais importante: decidindo quais perguntas fazer em seguida, quais cálculos fazer e quais experimentos realizar.
É claro que o raciocínio em mundo aberto é muito mais difícil do que jogar xadrez. O estado no quadro Go é totalmente visível e as regras são fixas; no mundo real, a situação atual é apenas parcialmente conhecida, as ações disponíveis são numerosas e complexas e as consequências das ações são cheias de aleatoriedade ou mesmo completamente desconhecidas.
Mas a boa notícia é que o progresso do LLM e de outros modelos neurais ao longo dos anos apenas forneceu peças para isso: o LLM pode propor um caminho para resolver o problema com base em informações conhecidas e recursos disponíveis; pode interagir com ferramentas através de APIs e códigos; pode ajudar a avaliar se uma conclusão é apoiada pelas evidências existentes. Mais importante ainda, deve haver um “árbitro” independente no sistema que avalie cada movimento de raciocínio com base em “quanta incerteza é resolvida por esta etapa” – e só atualiza as crenças quando apoiadas por evidências. Uma vez estabelecidas as regras, o sistema pode acumular conhecimento certificado, aprender com experiências de raciocínio anteriores e melhorar as suas próprias estratégias de raciocínio.
Graepel deu a esta imagem uma expressão vívida: o método científico com esteróides. Existe apenas um objetivo: produzir conhecimento que possa resistir ao escrutínio.
Sistema 1 maior,
O sistema 2 não crescerá automaticamente
No final do artigo, ele deixou clara sua atitude: Inteligência de máquina confiável não pode ser alcançada aumentando o Sistema 1. A escala aguça a intuição, mas não a prudência.
A razão pela qual o movimento 37 é importante é porque uma máquina defendeu uma posição, pesou os futuros possíveis e depois selecionou um movimento que até mesmo o seu próprio "pressentimento" provavelmente teria rejeitado.
A sociedade humana precisa de mais “mãos de Deus” nas áreas de descoberta de medicamentos, novos materiais, clima e diagnóstico médico. O tabuleiro de xadrez não se parecia em nada com Go, e ninguém nos passou as regras. Tais insights só podem vir de sistemas que raciocinem verdadeiramente: conclusões extraídas de uma cadeia de evidências auditáveis, inferências e revisões de crenças, em vez de uma história convincente inventada após os factos.
Há dez anos, o AlphaGo usou seu 37º ponteiro para dizer ao mundo que as máquinas podem superar a intuição humana.
Dez anos depois, um de seus criadores nos lembra: não se deixe enganar pela linguagem suave. Esse salto real não aconteceu novamente com o LLM até agora.
Você disse que o LLM não consegue raciocinar,
É sustentável?
Depois que este artigo de opinião foi publicado, ele causou bastante controvérsia no X.
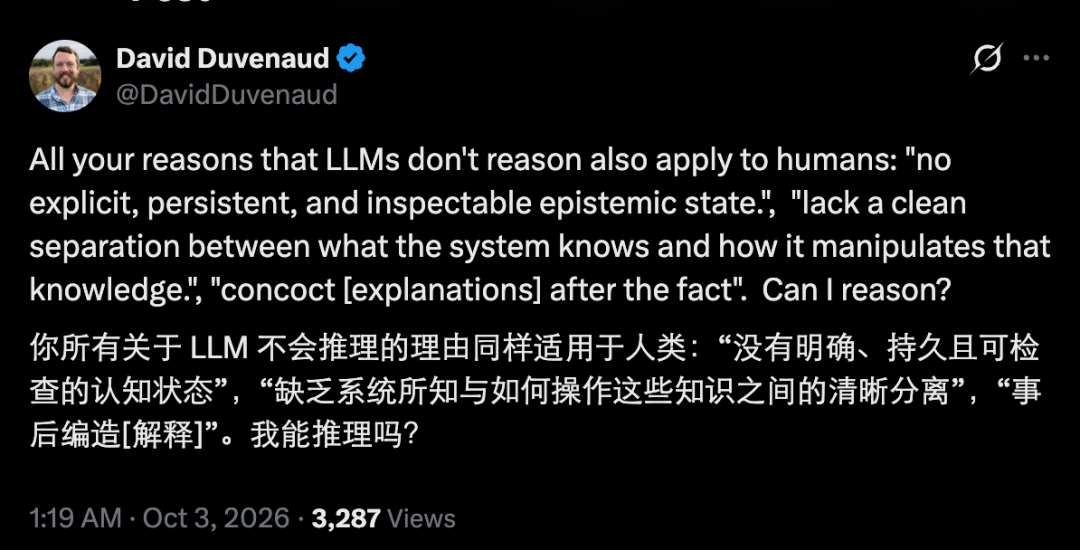
A pergunta mais contundente veio do professor David Duvenaud da Universidade de Toronto (um dos autores do melhor artigo do NeurIPS sobre EDO neural). Ele mencionou: As três acusações de Graepel contra o LLM – nenhum estado cognitivo verificável, nenhuma separação entre conhecimento e raciocínio, e fabricação de explicações após o fato – são igualmente válidas para os humanos. "De acordo com este padrão, posso ser considerado bom em raciocínio?"
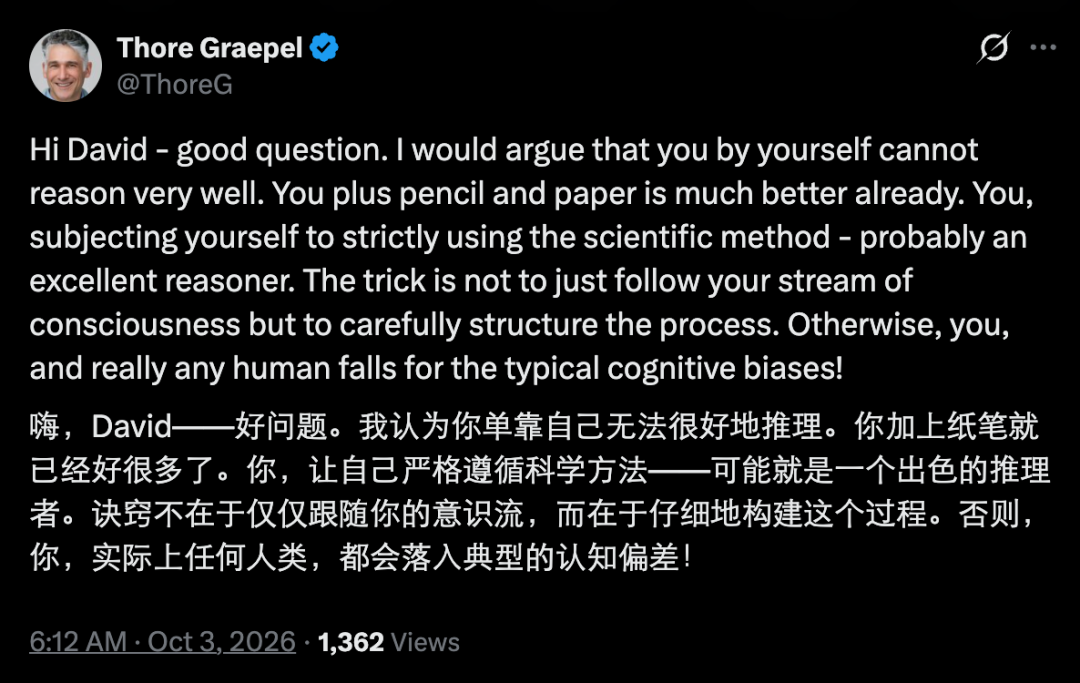
Graepel respondeu: Você não consegue raciocinar bem sozinho; se você receber papel e caneta, será muito melhor; e se lhe for solicitado que siga rigorosamente o método científico, você será considerado um excelente raciocinador. O truque é nunca seguir o fluxo da consciência, mas estruturar o processo – caso contrário, ninguém poderá escapar dos preconceitos cognitivos.
Duvenaud percebeu imediatamente a implicação desta frase: "Parece que podemos alcançar um raciocínio real de acordo com a sua definição, desde que equipamos o LLM com ferramentas semelhantes - não é isso que você pretende fazer?"
A "teoria do aprimoramento do papel e lápis" de Graepel também atraiu dúvidas de outros internautas. O internauta KingBroken apontou que papel e caneta são essencialmente um plug-in para memória de trabalho. Permite raciocinar sobre mais dados ao mesmo tempo, mas não altera a existência da capacidade de raciocínio “do nada”; mas tem um benefício adicional: as palavras e os números escritos são evidências verificáveis do “status cognitivo” humano.
Imediatamente depois, o internauta Daniel Grant fez uma pergunta mais incisiva: De acordo com isso, o método de raciocínio humano é equivalente a "modelo existente + sistema de plug-in", então você está construindo um modelo com capacidades de raciocínio interno mais fortes do que ambos? Ou estou faltando alguma nuance?
Graepel ainda não respondeu a essas perguntas.
Outra voz sentiu que esta discussão era desnecessária. O internauta visimo-dino disse sem rodeios: "Não acredito que ainda haja pessoas escrevendo esse tipo de artigo": o LLM já teve um bom desempenho em muitas coisas, e a afirmação "não consigo raciocinar" é ridícula ou irrelevante, e centenas de artigos semelhantes foram publicados.
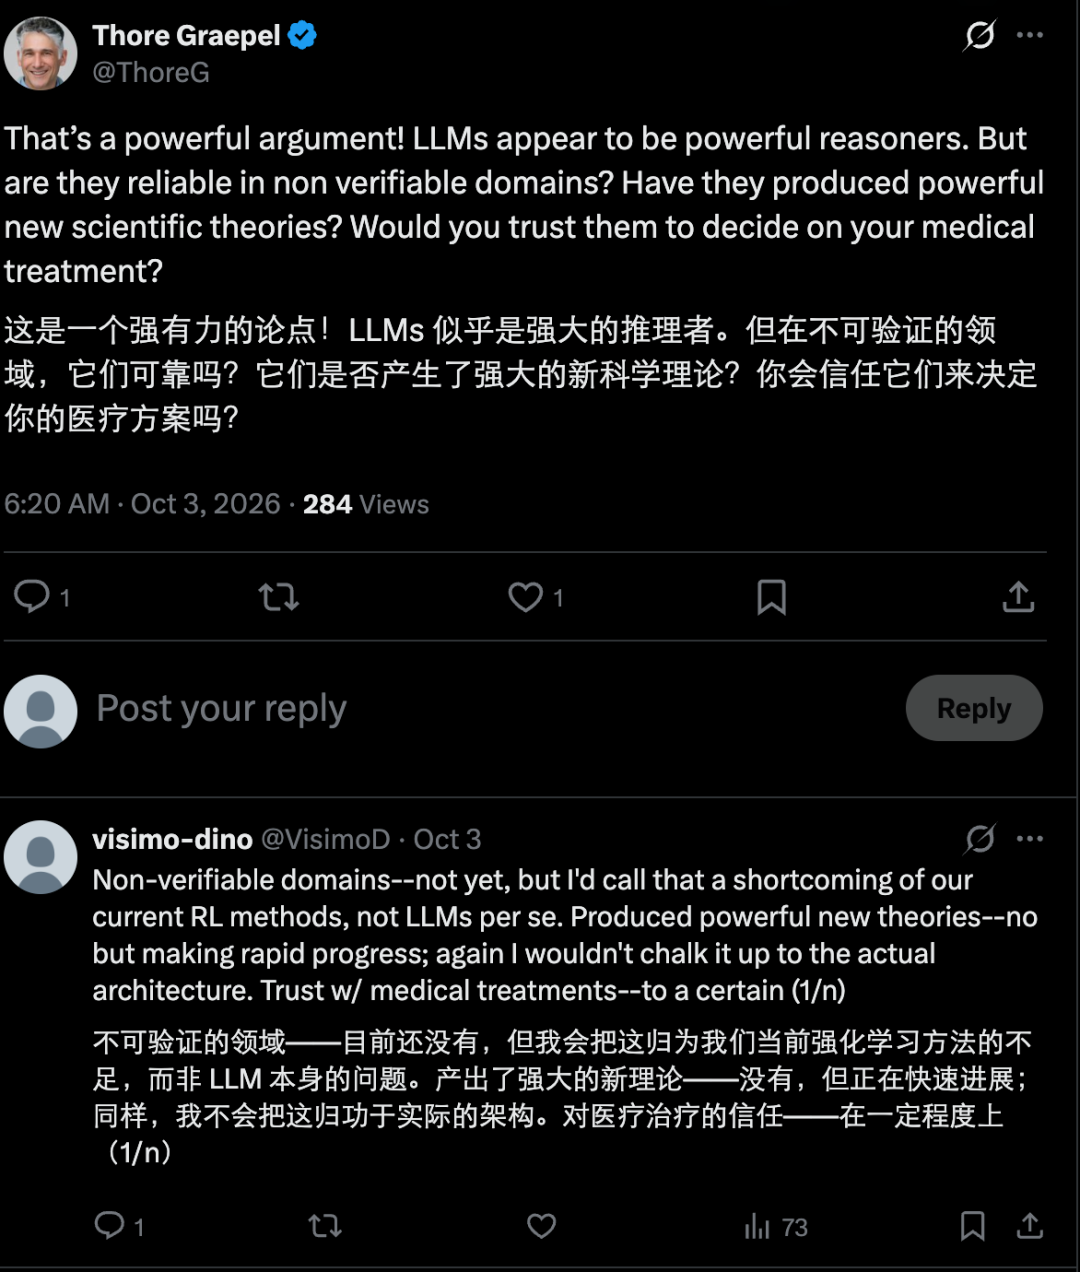
Graepel não insistiu nisso, apenas lançando três questões: eles são confiáveis em áreas onde não podem ser verificados? Produziu uma nova e poderosa teoria científica? Você tem coragem de deixar que isso dite seu tratamento médico? A outra parte foi franca, admitindo "ainda não", mas culpando os métodos de aprendizagem por reforço existentes, e não a própria arquitetura LLM - a implicação é que será resolvido com o tempo. Esta é provavelmente a verdadeira diferença entre os dois grupos: um lado pensa que o que falta é tempo, e o outro lado pensa que o que falta é estrutura.
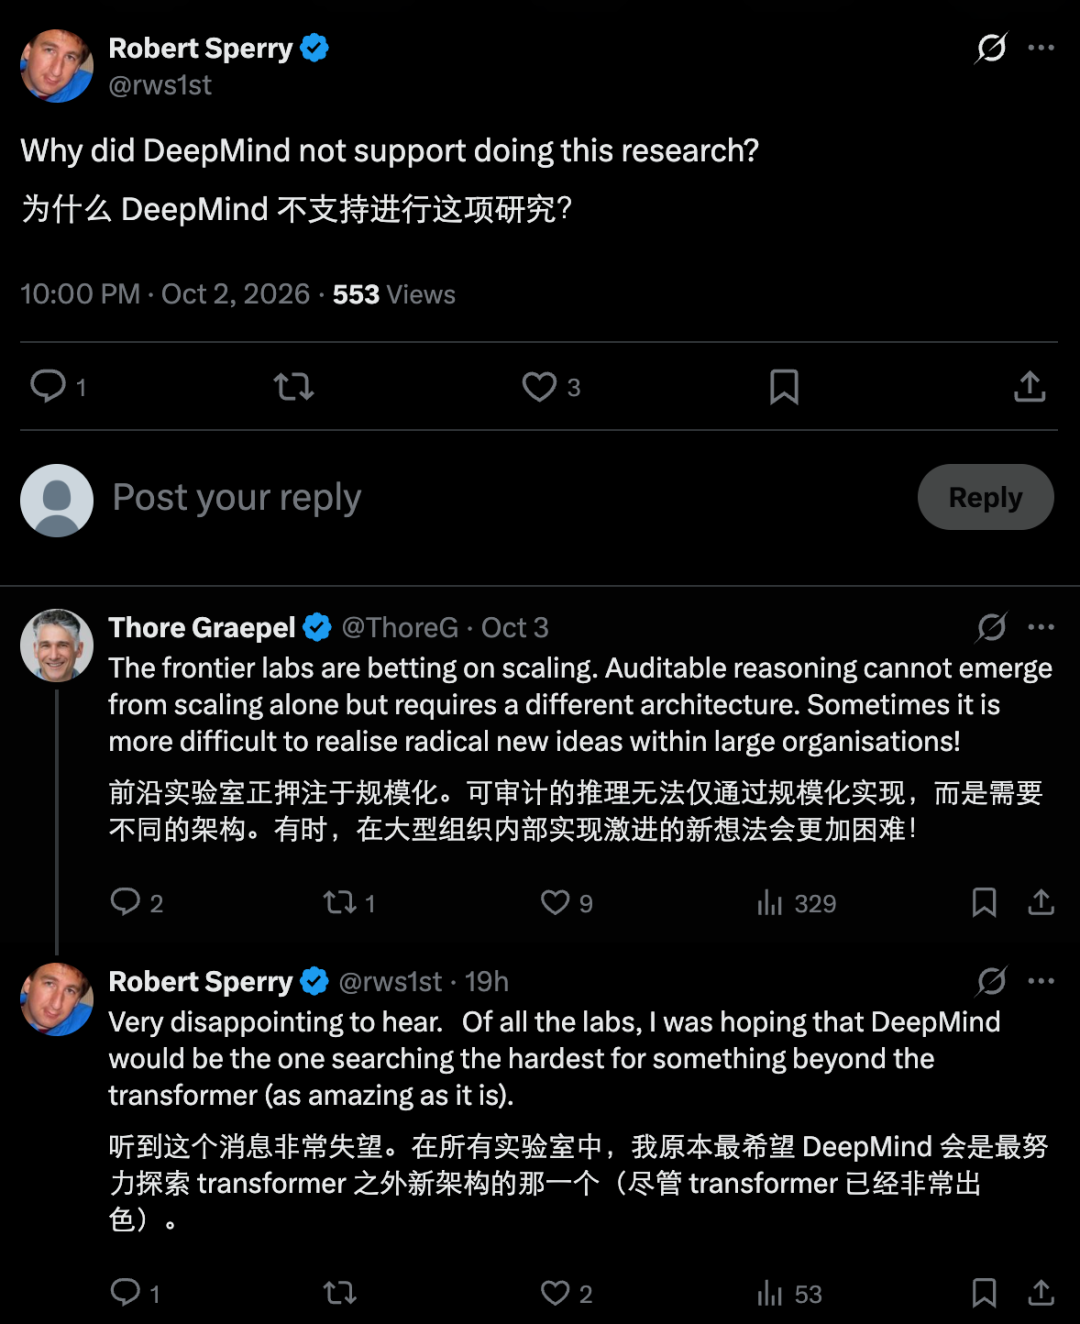
Outro comentário perguntou o que muitas pessoas estão pensando: Por que a DeepMind não apoia esta pesquisa? A resposta de Graepel é direta: laboratórios de ponta estão apostando no escalonamento, e o raciocínio auditável não pode surgir apenas do escalonamento. Requer uma arquitetura diferente. “Às vezes, novas ideias radicais são mais difíceis de implementar em grandes organizações.” A decepção do questionador Robert Sperry foi palpável: de todos os laboratórios, ele esperava que o DeepMind fosse o que mais se esforçasse para encontrar respostas além do Transformer.
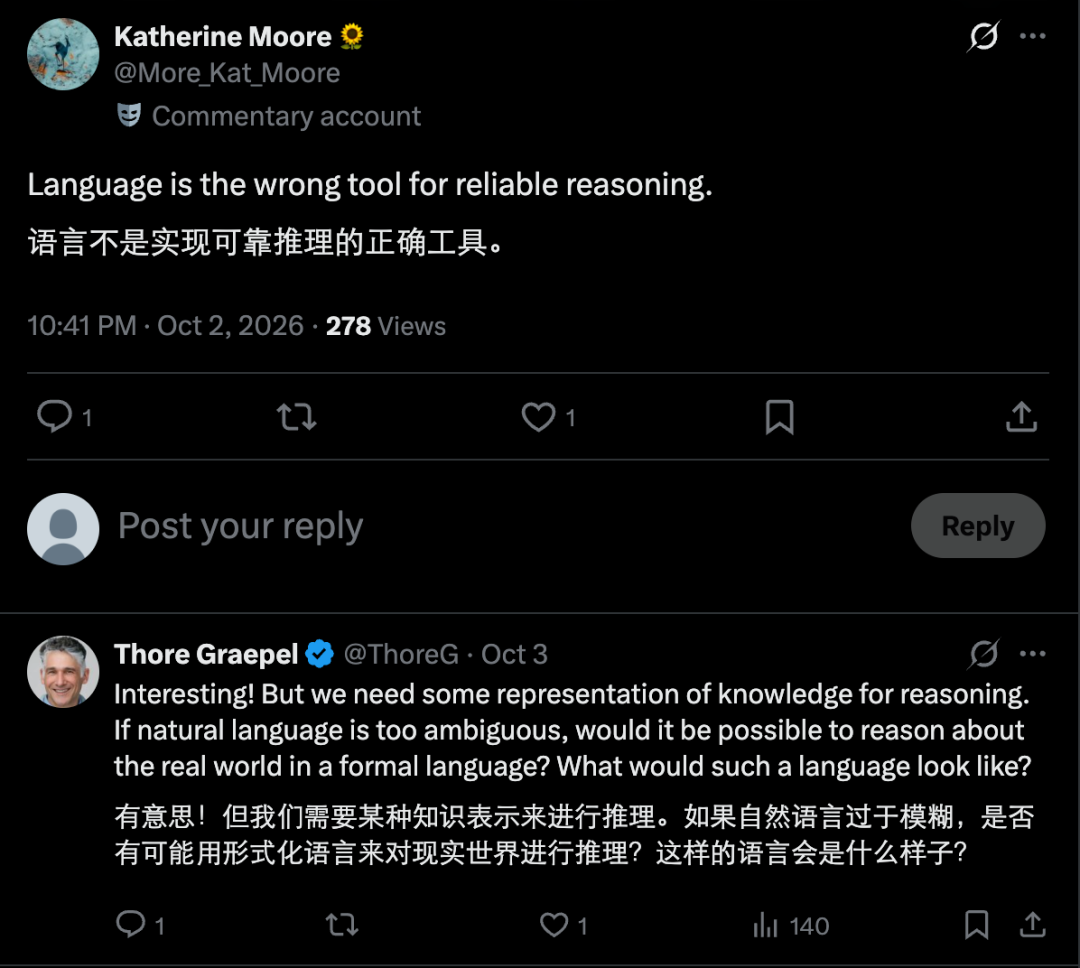
Algumas pessoas também apontaram o dedo para um lugar mais fundamental. A comentarista Katherine Moore deixou apenas uma frase: “A linguagem em si é a ferramenta errada e um raciocínio confiável não pode ser feito com ela”. Graepel levou a sério esta posição mais radical e levantou uma questão em aberto: o raciocínio requer algum tipo de representação do conhecimento. Se a linguagem natural for demasiado vaga, poderá a linguagem formal ser usada para raciocinar sobre o mundo real? Como seria essa linguagem? . Ele não respondeu, mas essa pode ser a pergunta que algumas pessoas responderão ao abrir seu próprio negócio.
Comentários